「生成AIの回答が不正確で、業務に使うには不安がある」
「社内データのような専門的で最新の情報に基づいて回答を生成させたい」このようにお考えではないでしょうか。生成AIは便利な一方、学習していない社内情報や新しい事実を、モデルの内部知識だけで正確に答えられるとは限りません。もっともらしい誤情報(ハルシネーション)を生成することもあります。その対策の一つが
「RAG(ラグ)」です。
RAG(Retrieval-Augmented Generation:検索拡張生成)は、質問に関連する外部情報を検索し、その内容を生成AIの回答材料に加える技術です。社内情報や新しい情報を反映しやすくなりますが、正確性は参照データ、検索結果、回答生成の品質に左右されます。この記事では、RAGの基本的な仕組みから具体的な活用事例、導入を成功させるポイントまでを解説します。
また、AIの導入や活用に関するお悩みは、当社AX CAMPが提供する資料で解決できるかもしれません。AI導入の計画から実行までをサポートする実践的なノウハウをまとめているので、ぜひ一度ご覧ください。
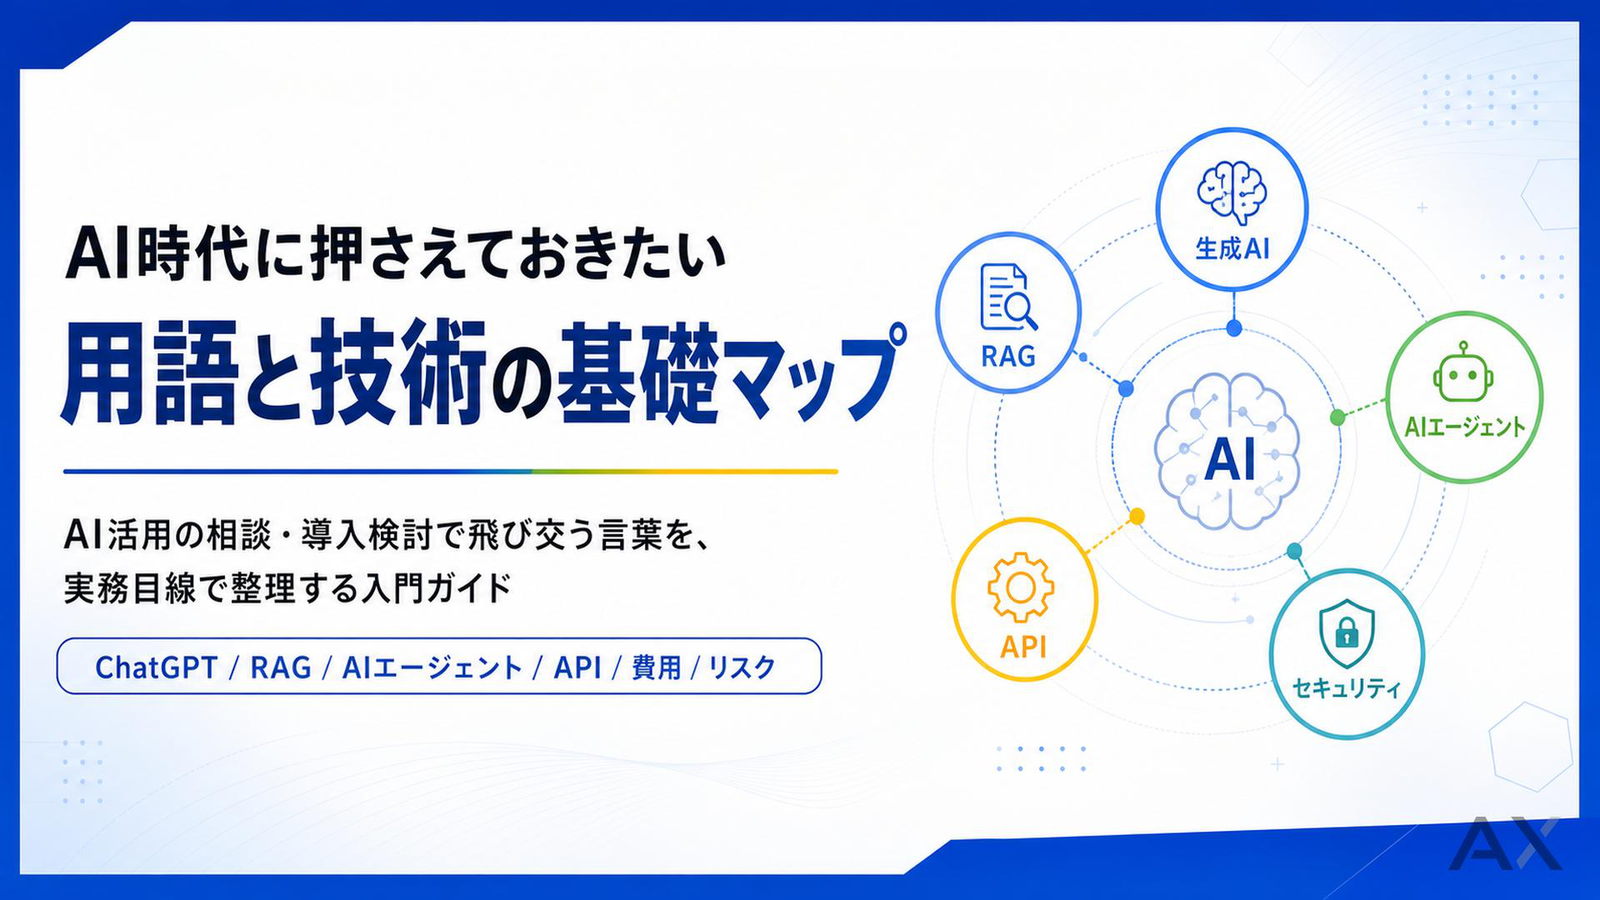
ChatGPT・RAG・AIエージェントなど、導入検討で迷いやすいAI用語を実務目線で整理。
RAG(検索拡張生成)とは?生成AIの新たな可能性
RAG(検索拡張生成)は、質問に関連する外部情報を検索し、その内容をLLMなどの生成AIに渡して回答を作成する技術です。社内資料や専門情報を回答に反映し、参照元を示す設計ができます。ただし、参照する情報が信頼できるか、必要な情報を検索できたかは別途確認が必要です。(出典:AWS:RAGとは)
外部資料や検索ツールを使わない生成AIを、暗記した知識でテストに臨む状態に例えると、RAGは質問に応じて参考資料を調べて回答する状態に近い仕組みです。ただし、資料を持ち込めても読み違いは起こり得るため、回答の検証は必要です。
基本的な定義と役割
RAGの役割は、LLMが内部知識だけでは扱いにくい社内情報や新しい情報を、回答の材料として外部から供給することです。検索対象の文書と更新の仕組みを設計し、必要な情報を取得できるようにします。
そこでRAGは、ユーザーからの質問に関連する情報を、指定されたデータベース(社内規定、製品マニュアル、最新の市場データなど)から瞬時に探し出します。そして、見つけ出した情報(コンテキスト)を元の質問と一緒にLLMへ渡すことで、LLMがその情報に基づいて回答を生成できるように支援します。この一連の流れが、RAGの基本的な役割です。
LLMの知識をリアルタイムで拡張する技術
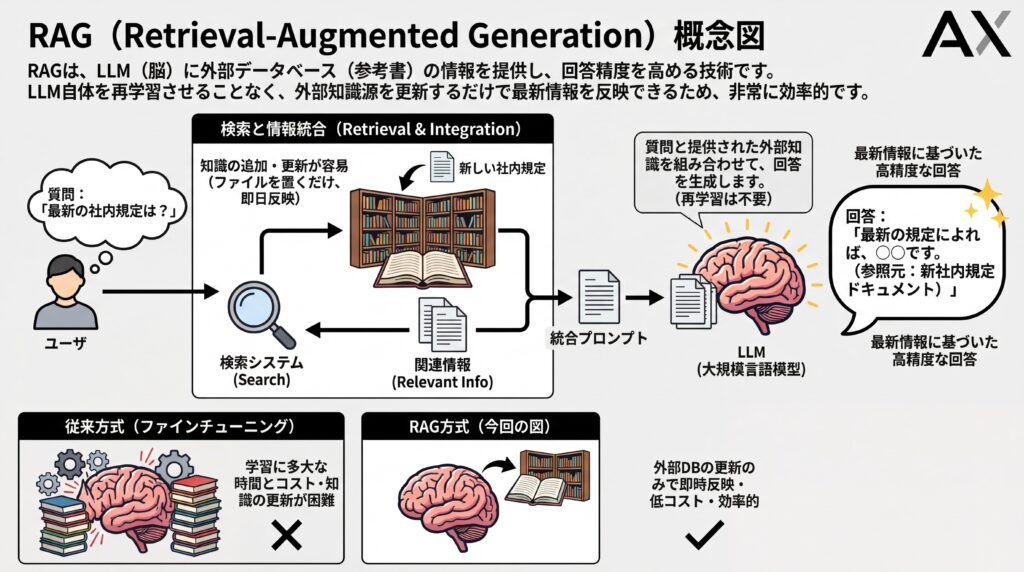
RAGは、LLMの重みを再学習させずに、回答時に外部情報を参照できる点が特長です。情報を補う方法には、プロンプトへの資料添付や検索ツールの利用などもあり、新しい情報の利用に必ずファインチューニングが必要なわけではありません。
RAGでは、知識源の更新に加え、取り込み・分割・インデックス更新を完了すると、新しい情報を検索対象にできます。新しい社内規定も、この処理とアクセス権限の設定が済んだ後に回答へ反映できます。ファイルを置くだけで即日反映されるかは、システムの同期設計によって異なります。(出典:LlamaIndex:RAGの取り込み・索引化)
なぜ今RAGが注目されるのか?従来の生成AIが抱える課題
RAGが急速に注目を集めている背景には、従来の生成AIが抱える3つの根深い課題があります。これらの課題は、生成AIをビジネスの現場で本格的に活用する上での大きな障壁となっていました。RAGは、これらの課題に対する直接的かつ効果的な解決策を提示します。
具体的には、平気で嘘をつく「ハルシネーション」、情報が古くなる「知識の陳腐化」、そして回答の根拠が分からない「ブラックボックス問題」です。これらの問題点を理解することで、RAGの真価が見えてきます。
ハルシネーション(もっともらしい嘘)の問題
ハルシネーションとは、生成AIが事実に基づかない情報を、あたかも真実であるかのように生成する現象です。これは、AIが学習データに含まれる情報の関連性を確率的に判断して文章を生成する仕組みに起因します。そのため、特に専門的な内容や最新のトピックについて質問した場合、誤った情報を自信満々に回答してしまうことがありました。
RAGは回答時に検索した情報を参照するため、ハルシネーションを抑制する効果が期待できます。ただし、参照元が誤っていたり、必要な情報を検索できなかったりすると、回答も誤る可能性があります。RAGだけで誤回答を完全には防げません。高信頼性が求められる用途では、回答と原資料の照合や人間による確認が重要です。(出典:AWS:RAGとは)
学習データ以降の最新情報に対応できない限界
GPTシリーズやGeminiなどのLLMは、内部知識だけでは学習時点より後の事実や非公開の社内情報を正確に把握できるとは限りません。ただし、検索ツールやユーザーが提供する資料を利用するサービスもあります。モデル内部の知識と、外部情報を取り込んだアプリケーションの回答能力は区別しましょう。
情報の鮮度が重要な業務では、更新された文書を検索対象にし、取得日時や版を確認することが必要です。RAGは新しい情報の参照を可能にしますが、同期が遅れたり古い文書が上位に出たりする場合があります。知識源の更新と検索品質の確認をセットで運用します。
回答の根拠が不明瞭なブラックボックス問題
従来の生成AIは、なぜその回答に至ったのか、その思考プロセスや根拠となった情報源がユーザーには分かりませんでした。これは「ブラックボックス問題」と呼ばれ、回答の妥当性を検証することが困難でした。
特に、コンプライアンスや正確性が厳しく問われる業務では、根拠不明な情報を利用することはできません。RAGは、回答を生成する際に参照した情報源を明示できるという大きな特長があります。これにより、ユーザーは回答の根拠を自ら確認し、その信頼性を判断できます。ただし、正確な出典を提示するためには、データの分割単位(チャンク)に文書IDやページ番号といったメタデータを適切に設計し、検証する仕組みを組み込むことが重要です。この透明性の高さが、ビジネス利用における安心感につながるのです。
法人向けAI研修
AX CAMP 無料資料
RAGの仕組みを3つのステップでわかりやすく解説
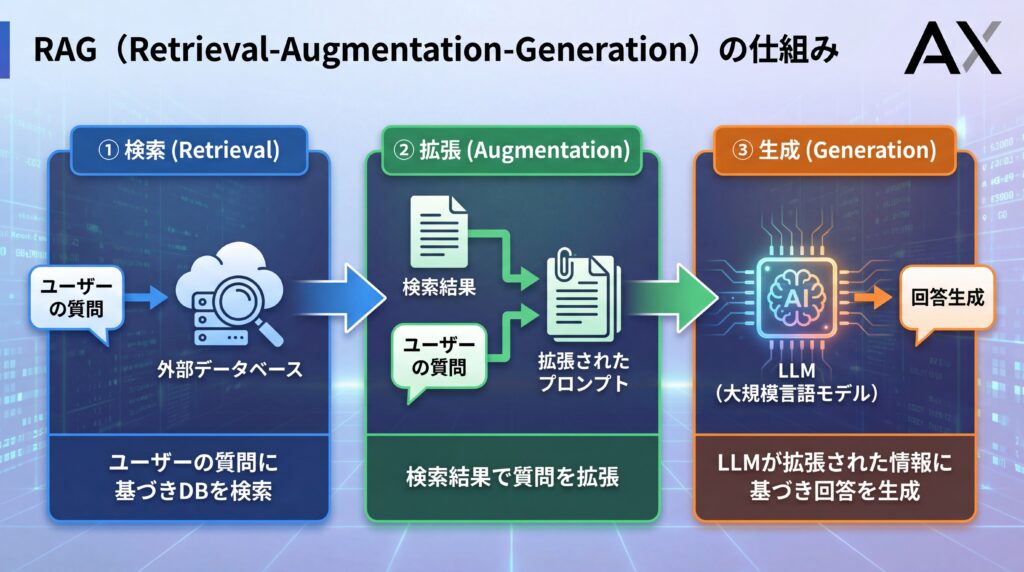
RAGの仕組みは、一見複雑に思えるかもしれませんが、実際には「検索」「拡張」「生成」という3つのシンプルなステップで構成されています。この一連の流れによって、生成AIは外部の知識を活用し、正確で信頼性の高い回答を生み出すことができます。それぞれのステップがどのように連携して機能するのかを具体的に見ていきましょう。
ステップ1:検索(Retrieval)- 関連情報の特定
最初のステップは「検索(Retrieval)」です。ユーザーから質問(プロンプト)が入力されると、RAGシステムはまず、その質問内容と関連性の高い情報を、あらかじめ接続されている外部の知識データベースから探し出します。
検索には、文章の意味的な近さを数値で比べるベクトル検索、キーワード検索、両者を組み合わせるハイブリッド検索などを使います。RAGにベクトル検索が必須というわけではありません。製品型番などの完全一致と、文脈の類似性を使い分け、必要な資料が取得できるかを評価します。(出典:Microsoft:ハイブリッド検索)
ステップ2:拡張(Augmentation)- プロンプトの強化
次のステップは「拡張(Augmentation)」です。ステップ1で検索された関連情報(コンテキスト)を使って、元の質問(プロンプト)を強化・拡張します。具体的には、元の質問文と、検索で見つかった情報を組み合わせて、新しいプロンプトを作成します。
例えば、元の質問が「テレワークの新しい規定について教えて」だった場合、検索で見つかった「テレワーク勤務規程第3版.pdf」の内容をプロンプトに追加します。これにより、LLMに対して「『テレワーク勤務規程第3版.pdf』の内容に基づいて、テレワークの新しい規定について教えてください」という、より具体的で情報が豊富な指示を与えられます。
ステップ3:生成(Generation)- 回答の作成
最後のステップが「生成」です。検索した資料と質問をLLMへ送り、その資料に基づいて回答するよう指示します。外部情報が自動的に最優先されるとは限らないため、参照範囲や答えがない場合の対応も設定します。
LLMは検索結果と質問を受け取り、回答を生成します。参照資料だけに基づくよう指示しても、内部知識を混ぜたり資料を誤読したりする可能性があります。出典を表示し、資料に答えがなければ回答を控える設計と、生成結果の検証を組み合わせましょう。(出典:Microsoft:RAGと生成AI)
RAGとファインチューニングの決定的な違い
RAGとよく比較される技術に「ファインチューニング」があります。どちらもLLMの性能を向上させる手法ですが、その目的とアプローチは根本的に異なります。ビジネス要件に合った最適な手法を選ぶためには、両者の違いを正確に理解しておくことが重要です。
端的に言えば、RAGは「知識」を外部から与える技術であり、ファインチューニングは「振る舞いや口調」をモデル内部に学習させる技術です。この違いが、コストや更新性、柔軟性に大きな差を生みます。
目的とアプローチの違い
RAGの主な目的は、LLMが持っていない最新情報や専門知識をリアルタイムで提供し、回答の正確性を高めることです。アプローチとしては、外部のデータベースを検索し、得られた情報を基に回答を生成します。
一方、ファインチューニングの目的は、特定のタスクや文体に合わせてLLMの応答スタイルや振る舞いを調整することです。例えば、特定のキャラクターのような口調で話させたり、特定の形式(メール作成、要約など)の文章生成に特化させたりする場合に有効です。アプローチとしては、追加の学習データセットを用いてLLM自体を再トレーニングします。
コスト・更新性・柔軟性の比較
RAGとファインチューニングは、実用面で大きな違いがあります。以下の比較表で、自社の目的にどちらが適しているかを確認しましょう。
| 比較項目 | RAG(検索拡張生成) | ファインチューニング |
|---|---|---|
| 目的 | 知識の外部注入、回答の正確性向上 | 応答スタイル、振る舞いの調整 |
| コスト | ケースバイケース(DB運用コストは継続的に発生) | ケースバイケース(PEFT等で安価な場合もある) |
| 情報の更新性 | 取り込み・インデックス更新後に反映 | 低い(再学習が必要) |
| 根拠の提示 | 可能(参照元を明示できる) | 単独では参照元の提示を保証しない。検索機能と併用可能 |
| 導入の手軽さ | 構成次第。データ整備・権限制御・評価が必要 | 専門知識と時間が必要 |
コストはユースケースによって変動するため、一概にどちらが優れているとは言えません。RAGは初期導入が比較的早いものの、継続的な検索・推論コストやベクトルデータベースの運用コストがかかります。一方で、LoRAなどの効率的な手法(PEFT)を用いれば、ファインチューニングが安価に済む場合もあります。最新情報への対応や事実に基づいた回答が求められる多くのビジネスシーンではRAGが有効ですが、最適な手法は要件次第と言えるでしょう。
法人向けAI研修
AX CAMP 無料資料
RAG導入による主要なメリット
RAGを導入することで、企業は生成AIの活用レベルを大きく引き上げることができます。そのメリットは多岐にわたりますが、特にビジネスインパクトが大きいのは「回答の信頼性向上」「情報の最新性と専門性の確保」「開発コストと時間の削減」という3つの点です。
1. 回答の信頼性向上(ハルシネーション抑制と根拠提示)
RAG導入の大きなメリットは、回答の信頼性が向上する点です。生成AIの最大の欠点であったハルシネーション(もっともらしい嘘)は、信頼できる社内データや公式文書といった外部情報源を基に回答を生成することで、大幅に抑制されることが期待できます。(出典:AWS:RAGとは)
さらに、RAGは回答と同時に根拠となった情報源(どの文書の何ページを参照したかなど)を提示できます。これにより、ユーザーは回答の正しさを簡単に検証でき、安心してAIの回答を業務に利用できます。(出典:Microsoft:RAGと生成AI)この透明性は、金融や法務など、情報の正確性が極めて重要な業界でのAI活用を可能にします。
2. 情報の最新性と専門性の確保
RAGでは、外部データの取り込みと索引の更新によって、新しい情報を検索・回答へ反映できます。LLM本体の再学習は不要ですが、文書の更新頻度や削除の反映、版管理を設計し、古い情報が検索されないか確認する必要があります。
また、社内マニュアル、研究開発データ、顧客からのフィードバックといった、インターネット上には存在しない専門的かつクローズドな情報を知識源として活用できるのも大きな強みです。これにより、自社の状況に即した、より価値の高い回答をAIに生成させることが可能になります。
3. 開発コストと時間の削減
ファインチューニングでは追加の学習データや学習処理が必要です。ただし、計算量や準備するデータ量はモデル、手法、タスクによって異なり、常に膨大なコストがかかるとは限りません。RAGと併用して、検索で知識を補いながら応答形式を調整する構成もあります。
RAGはLLMの再学習を省けるため、更新頻度の高い情報を扱うシステムで開発を効率化できる場合があります。ただし、データ準備に加え、検索・権限制御・回答評価・運用監視が必要です。検索や推論の利用料も継続するため、初期開発費と運用費の両方を比較しましょう。
知っておくべきRAGのデメリットと対策
RAGは非常に強力な技術ですが、万能というわけではありません。導入を成功させるためには、そのデメリットや注意点を理解し、あらかじめ対策を講じておくことが重要です。主な課題は「検索精度への依存性」と「システム構成の複雑化」の2点です。
検索精度への依存性と対策
RAGの回答品質は、ステップ1の「検索(Retrieval)」の精度に大きく依存します。質問に対して適切な情報を見つけられなければ、たとえ高性能なLLMを使っても、的外れな回答や不正確な回答が生成されてしまいます。「ゴミを入れればゴミが出る(Garbage In, Garbage Out)」という原則が、RAGにも当てはまるのです。
この課題への対策は以下の通りです。
- 高品質な知識ベースの構築:参照するデータは事前にクレンジングし、整理しておく必要があります。
- 高性能な検索技術の採用:キーワード検索とベクトル検索を組み合わせた「ハイブリッド検索」などが有効です。
- データの定期的な棚卸し:情報が古くならないよう、定期的なメンテナンスが不可欠です。
これらの対策を通じて、知識源となるデータベースの品質を担保することが、RAGの性能を最大限に引き出す上で極めて重要になります。
システム構成の複雑化とデータ管理の重要性
RAGシステムは、LLMに加えて、データを取り込む部分、情報をベクトル化して保存するベクトルデータベース、検索を実行する部分など、複数のコンポーネントを組み合わせる必要があり、システム構成が複雑になりがちです。
この課題への対策は以下の通りです。
- マネージドサービスの活用:AWSやAzureなどが提供するサービスを利用し、構築・運用の手間を削減します。
- データガバナンスの徹底:機密情報が漏洩しないよう、アクセス権限を適切に管理することが重要です。
- スモールスタートでの導入:まずは限定的な範囲で導入し、知見を蓄積しながら段階的に拡大します。
特に、誰がどのデータにアクセスできるかを管理するデータガバナンスは、セキュリティを確保する上で欠かせない要素です。
法人向けAI研修
AX CAMP 無料資料
【2026年版】RAGの主な活用事例
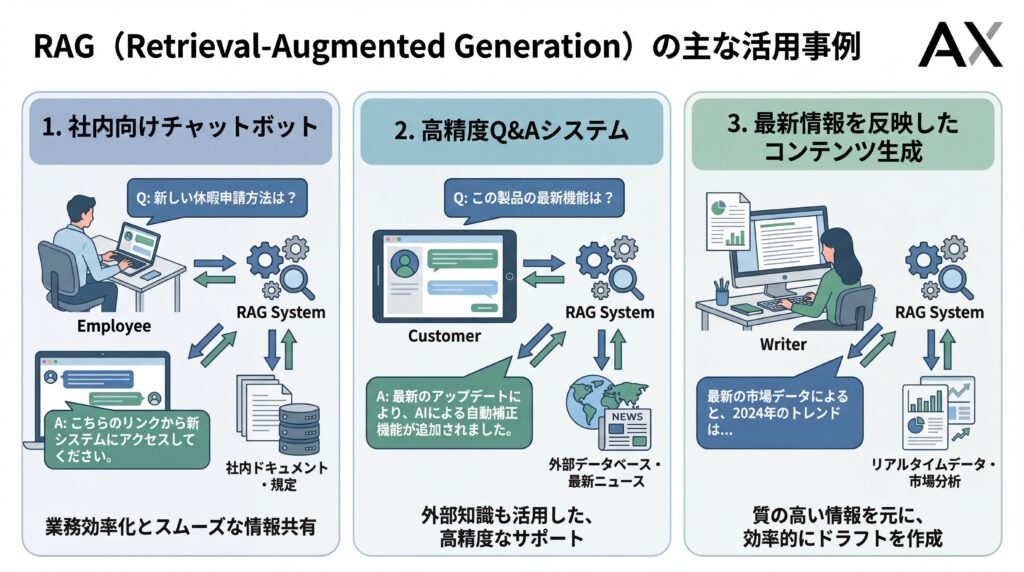
RAGの技術は、すでに多くの企業で実用化が進んでおり、業務効率化や顧客満足度向上に大きく貢献しています。ここでは、具体的な活用イメージを掴んでいただくために、代表的な3つのユースケースと、当社AX CAMP(エーエックスキャンプ)の支援を通じて成果を上げた企業の事例をご紹介します。
高精度な社内向けAIチャットボット
社内向けのAIチャットボットでは、経費精算の規定やIT機器のマニュアルなどを参照して、問い合わせへの回答を支援できます。営業時間外の対応も可能ですが、稼働時間は運用設計やサービスの条件によります。重要な手続きは原資料や担当者による確認を残しましょう。
これにより、定型的な問い合わせや資料探しの時間を減らせる可能性があります。三井住友フィナンシャルグループの2026年2月の公式記事では、SMBC-GAIが約130万件の社内文書を検索対象にしたRAG活用を紹介しています。参照元を表示してもハルシネーションが生じ得るとして、利用者による確認も促しています。(出典:SMBCグループのRAG活用事例)
専門的なQ&Aシステムの構築
法律、医療、金融といった高度な専門知識が求められる分野でも、RAGは非常に有効です。膨大な量の専門文献、判例、論文などを知識データベースとすることで、専門家の調査・分析業務を支援するQ&Aシステムを構築できます。
例えば、弁護士が過去の類似判例を検索したり、医師が最新の治療ガイドラインを確認したりする際に、RAGシステムが瞬時に適切な情報を提供します。ただし、これらはあくまで支援ツールであり、診断や最終的な法的判断は必ず各分野の専門家が行う必要があり、参照情報の正確性についても専門家による検証が不可欠です。
最新情報を反映したコンテンツ生成支援
マーケティング部門におけるコンテンツ制作も、RAGによって大きく効率化できます。最新の市場調査レポート、競合製品のニュースリリース、自社のアクセス解析データなどを知識源とすることで、時事性の高いブログ記事やSNS投稿、メルマガの原稿などをAIが生成します。
これにより、情報収集や下書き作成の一部を効率化できる可能性があります。ただし、知識源の更新、引用の妥当性、生成内容の正確性、著作権や公開可否の確認は引き続き必要です。
C社様のAI活用事例(RAG実装は未確認)
2026年9月のAX公式取材では、C社が過去にSNS投稿の自動化で月間1,000万インプレッションを生み出したこと、その後はAI活用を全社へ広げたことが紹介されています。取材時点で以前のSNSシステム全体は稼働しておらず、中核の仕組みを継続利用しています。この資料ではRAG実装や「3時間から1時間」という削減値は確認できないため、RAG固有の成果としては扱いません。(出典:C社のSNS自動化から全社AI活用への展開)
WISDOM合同会社様(広告・動画制作事業)の事例
WISDOM合同会社様は、広告制作周辺の業務効率化にAIやGASを活用しています。2025年8月の取材では、バックオフィス担当者2名の採用を見送ったことが報告されていますが、日程調整の完全自動化は「これから実装する」「見込み」と説明されています。RAGの導入や、すべての業務を既にAIが代替したことを実証する資料ではありません。(出典:WISDOM社のAI活用取材)
エムスタイルジャパン株式会社様の業務自動化事例
エムスタイルジャパン株式会社様の2025年9月の取材では、GASによる通話履歴・処理情報の自動集約によって、月約16時間かかっていた確認業務がほぼ不要になり、全社で月100時間以上の業務削減を達成したと報告されています。この成果は業務自動化の事例であり、RAGによる検索・回答システムの実績とは区別します。社内ナレッジを使うチャットボットなどは次の取り組みとして説明されています。(出典:エムスタイルジャパン社の業務自動化取材)
RAG導入を成功させるための重要なポイント
RAGの導入を成功に導くためには、技術的な側面だけでなく、戦略的な視点が不可欠です。やみくもに導入するのではなく、「目的の明確化とスモールスタート」および「高品質なデータと最適な技術の選定」という2つの重要なポイントを押さえることが成功のカギとなります。
目的の明確化とスモールスタート
まず最も重要なのは、RAGで解決する業務課題を明確にすることです。例えば「問い合わせ対応工数を30%削減する」は目標設定の例であり、導入効果を保証する数値ではありません。導入前の工数と回答品質を記録し、同じ条件で比較できる指標を決めましょう。
目的が明確になったら、いきなり全社展開を目指すのではなく、特定の部門や業務に絞ってスモールスタートで始めることを推奨します。例えば、まずは人事部のFAQ対応チャットボットから始めるなど、効果を検証しやすく、影響範囲が限定的な領域から着手することで、リスクを抑えながら知見を蓄積できます。ここで得られた成功体験と課題を基に、段階的に適用範囲を拡大していくのが成功への近道です。
高品質なデータと最適な技術の選定
前述の通り、RAGの性能は知識源となるデータの品質に大きく左右されます。導入プロジェクトの初期段階で、利用するデータソースを特定し、その品質を評価・整備することが不可欠です。文書のフォーマットが統一されていなかったり、古い情報や誤った情報が含まれていたりする場合は、事前にデータをクレンジングし、整理しておく必要があります。
また、RAGを実現するための技術要素(ベクトルデータベース、検索アルゴリズム、LLMなど)には様々な選択肢があります。自社の要件(セキュリティ、コスト、拡張性など)や技術チームのスキルセットに合わせて、最適な技術スタックを選定することが重要です。クラウドサービスを活用するのか、オープンソースを組み合わせるのかなど、長期的な運用を見据えた選択が求められます。
法人向けAI研修
AX CAMP 無料資料
社内情報の権限制御と回答の評価
利用者が元の文書を閲覧できるかを、検索時にも確認する設計が必要です。検索対象に入った情報が、そのまま全社員に見える状態にならないように、利用者・所属・文書の権限で結果を絞り込みます。引用元のリンクだけを隠しても、回答本文に機密情報が出れば保護になりません。(出典:Microsoft:文書単位のアクセス制御)
導入前に、正解を確認できる質問、資料に答えがない質問、閲覧権限がない資料に関する質問を用意します。必要な文書を検索できたか、回答が資料に沿うか、根拠を表示できるかを別々に確認し、処理時間と費用も測定します。外部APIへ送る検索結果や保存ログの範囲、データ保持・利用条件も契約と設定で確認しましょう。
RAGシステムの基本的な構築方法
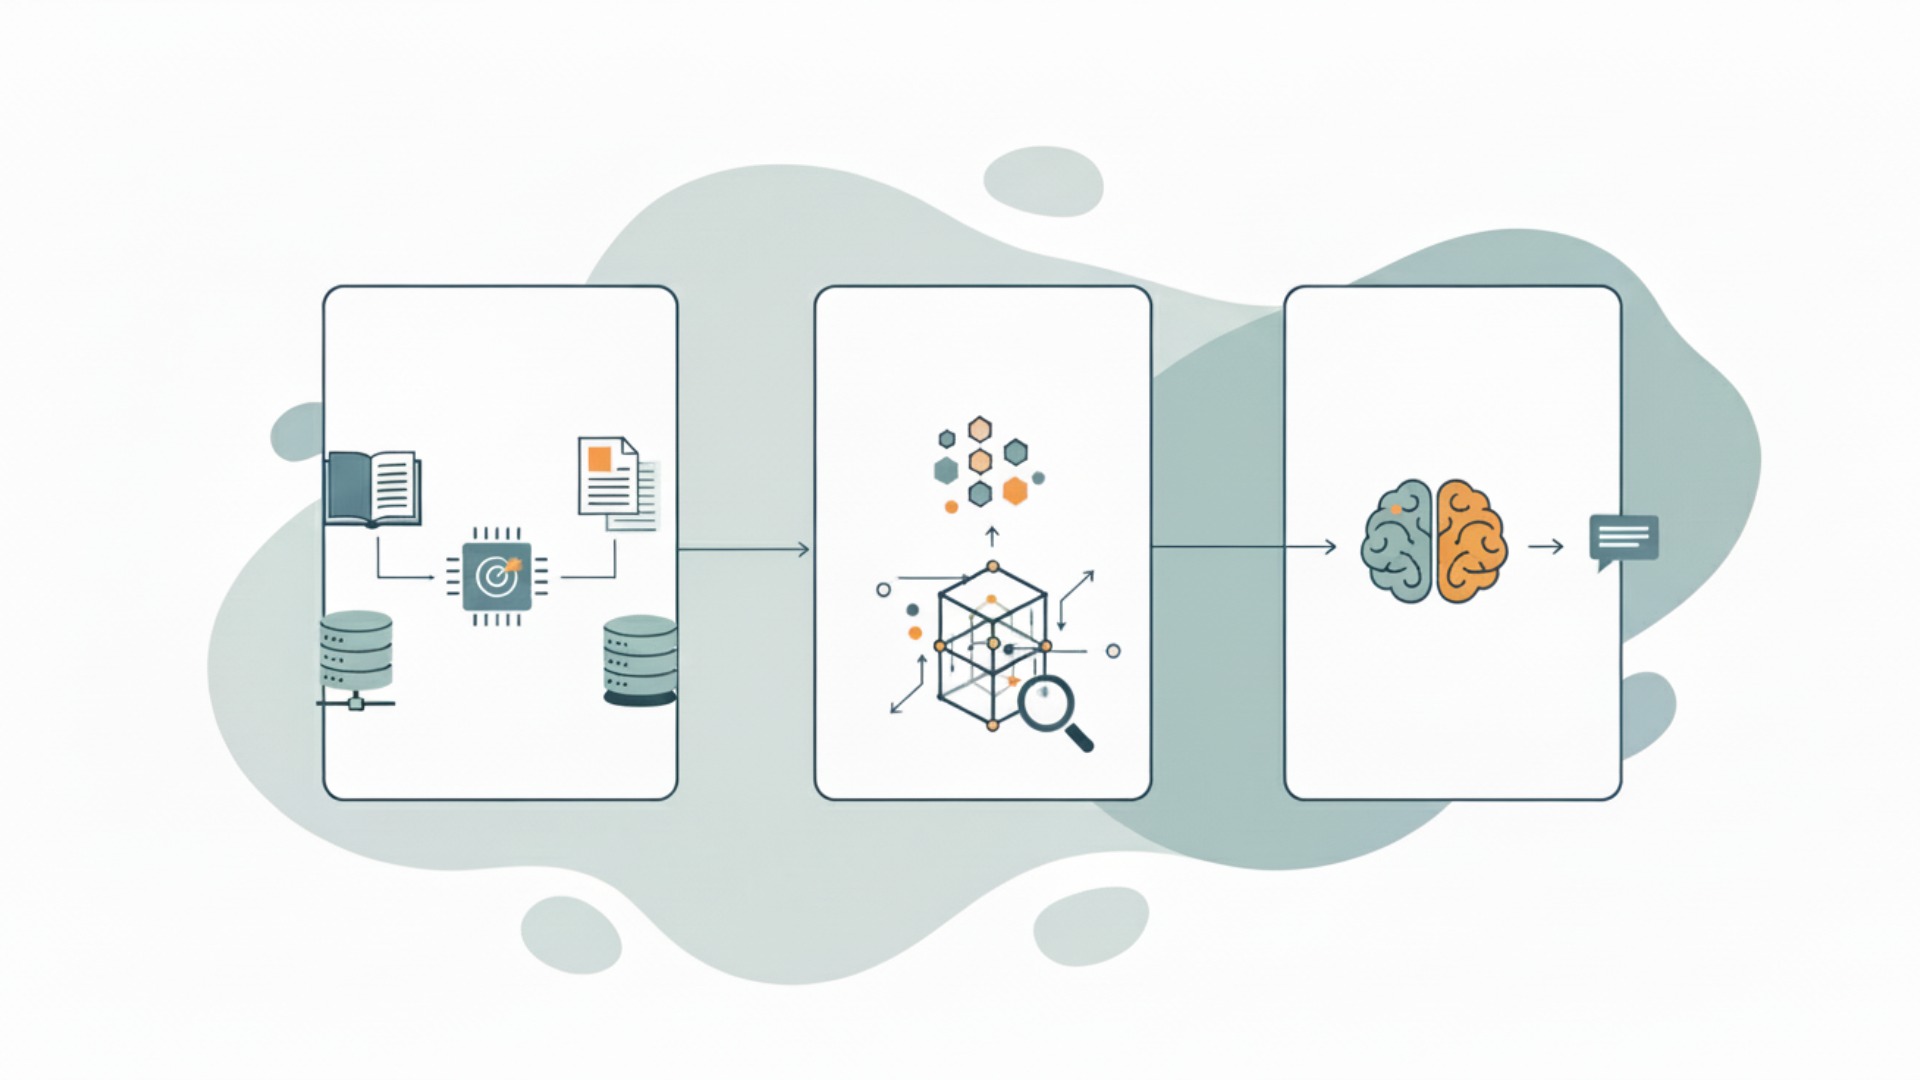
RAGシステムを構築するプロセスは、大きく3つのステップに分けられます。それは「データソースの準備」「エンベディングとベクトルデータベースの選定」「LLMの選択と連携」です。ここでは、それぞれのステップで具体的に何を行うのか、その概要を解説します。
データソース(ナレッジベース)の準備と前処理
最初のステップは、RAGの知識源となるデータソース(ナレッジベース)を準備することです。社内規定のPDF、業務マニュアルのWordファイル、過去の問い合わせ履歴が記録されたExcelファイルなど、AIに参照させたいあらゆるドキュメントが対象となります。
集めたデータは、そのままではAIが処理しにくいため、前処理が必要です。具体的には、ドキュメントを意味のある単位(段落など)で小さな塊(チャンク)に分割します。このチャンク化の粒度が、後の検索精度に影響を与えるため、非常に重要な工程です。不要なヘッダーやフッターを削除するなどのデータクレンジングもこの段階で行います。
エンベディングモデルとベクトルデータベースの選定
次に、前処理したテキストデータ(チャンク)を、AIが意味を理解できる数値の羅列、すなわち「ベクトル」に変換します。この処理を「エンベディング」と呼び、専用のエンベディングモデルを使用します。
変換されたベクトルデータは、「ベクトルデータベース」という専用のデータベースに格納されます。ベクトルデータベースは、ベクトルの類似度を高速に計算し、関連性の高い情報を瞬時に検索することに特化しています。Pinecone、Milvus、Chroma DBといった多様な選択肢があり、プロジェクトの規模や要件に応じて最適なものを選定します。
LLM(大規模言語モデル)の選択と連携
LLMにはOpenAIのGPTシリーズ、GoogleのGeminiシリーズ、AnthropicのClaudeシリーズなどがあります。2026年10月13日に確認したGoogleの公式一覧では、Gemini 3.8 Flashが安定版、Gemini 3.1 ProはAPIでプレビュー版として掲載されています。用途別の応答品質、費用、遅延、データ条件を比較し、利用するAPI・地域での提供状態と終了予定を確認して選びます。ProとFlashは用途や仕様が異なるため、番号だけで置き換えないことが重要です。(出典:Gemini公式モデル一覧、Gemini提供終了情報)
そして、ユーザーからの質問入力、ベクトルデータベースでの検索、検索結果と質問を組み合わせたプロンプトの作成、LLMへの送信、そして最終的な回答の生成という一連の流れをプログラムとして実装します。この全体の処理フローを効率的に構築するために、後述するLangChainやLlamaIndexといったフレームワークがよく利用されます。
RAGの精度を最大化する先進的テクニック
基本的なRAGシステムを構築した上で、さらに回答の精度を追求するためには、いくつかの先進的なテクニックを導入することが有効です。ここでは、「ハイブリッド検索」や「クエリ変換・リランキング・自己修正」といった、より高度なRAGの手法について紹介します。これらの技術を組み合わせることで、複雑な質問に対しても的確な回答を生成できる可能性が高まります。
ハイブリッド検索による検索精度の向上
RAGの根幹である検索ステップの精度を高めるために、複数の検索手法を組み合わせる「ハイブリッド検索」が注目されています。これは、従来からあるキーワードベースの検索(BM25など)と、意味の類似性で検索するベクトル検索を組み合わせるアプローチです。
ベクトル検索は文脈を捉えるのが得意ですが、特定の固有名詞や製品型番などのキーワードを正確に捉えられないことがあります。一方でキーワード検索はその逆です。両者を組み合わせることで、互いの弱点を補い、より網羅的で精度の高い検索結果を得ることができ、最終的な回答の品質向上につながります。
クエリ変換・リランキング・自己修正による回答品質の向上
検索精度だけでなく、LLMに渡す情報の質を高めるためのテクニックも進化しています。
- クエリ変換:ユーザーの曖昧な質問を、検索に適した明確な質問にLLM自身が書き換える技術です。
- リランキング:一度検索した結果を、専用モデルやLLMなどで再評価し、質問との関連性が最も高い順に並べ替える手法です。
- 自己修正(Self-Correction):生成した回答が元の質問の意図と合っているかなどをLLMが自らチェックし、問題があれば修正する技術です。
これらの手法は回答品質の改善に役立つ場合があります。ただし、自己修正の判定自体が誤ることもあります。追加処理による費用・遅延を測定し、正解を確認できる評価用の質問や原資料と照合して効果を検証しましょう。
法人向けAI研修
AX CAMP 無料資料
【2026年10月確認】RAG関連ツール・サービス
RAGシステムをゼロから構築するのは大変ですが、幸いなことに、開発を効率化し、高度な機能を実現するための様々なツールやサービスが存在します。これらは大きく「主要クラウドプラットフォーム」が提供するマネージドサービスと、「オープンソースフレームワーク」に大別されます。自社の状況に合わせてこれらを適切に選択・活用することが、RAG導入の成功につながります。
主要クラウドプラットフォーム(AWS, Azure, Google Cloud)
大手クラウドベンダーは、RAGシステムの構築に必要なコンポーネントを統合し、簡単に利用できるサービスを提供しています。これらを利用することで、インフラ管理の手間を大幅に削減し、アプリケーション開発に集中できます。
- Amazon Web Services (AWS):エンタープライズ向け検索サービス「Amazon Kendra」やベクトルデータベース機能を持つ「Amazon OpenSearch Service」などを提供。
- Microsoft Azure:「Azure AI Search」が中核となり、Azure OpenAI Serviceとシームレスに連携できます。
- Google Cloud:Vertex AI SearchやRAG Engineなど、検索と生成を組み合わせるためのサービスを提供しています。利用可能なモデル、対応データ、地域、プレビューの制限は各サービスの公式情報で確認します。(出典:Google Cloud:RAG Engine概要)
これらのサービスは、各社のLLMとスムーズに連携できる点が大きな強みです。
オープンソースフレームワーク(LangChain, LlamaIndex)
より柔軟なカスタマイズや、特定のクラウドに依存しないシステム構築を目指す場合には、オープンソースのフレームワークが有力な選択肢となります。中でも、LangChainとLlamaIndexは、RAG開発の主要フレームワークとして広く採用されています。
- LangChain:LLMアプリケーション開発のための汎用的なフレームワークで、データ連携からエージェント機能まで幅広くカバーします。
- LlamaIndex:RAGの構築、特にデータのインデックス作成と検索機能に特化したフレームワークで、効率的なデータ検索パイプラインの構築に強みがあります。
LangChainとLlamaIndexは競合するだけでなく、それぞれの得意な機能を組み合わせて利用することも可能です。
生成AIとRAGの今後の展望と未来予測
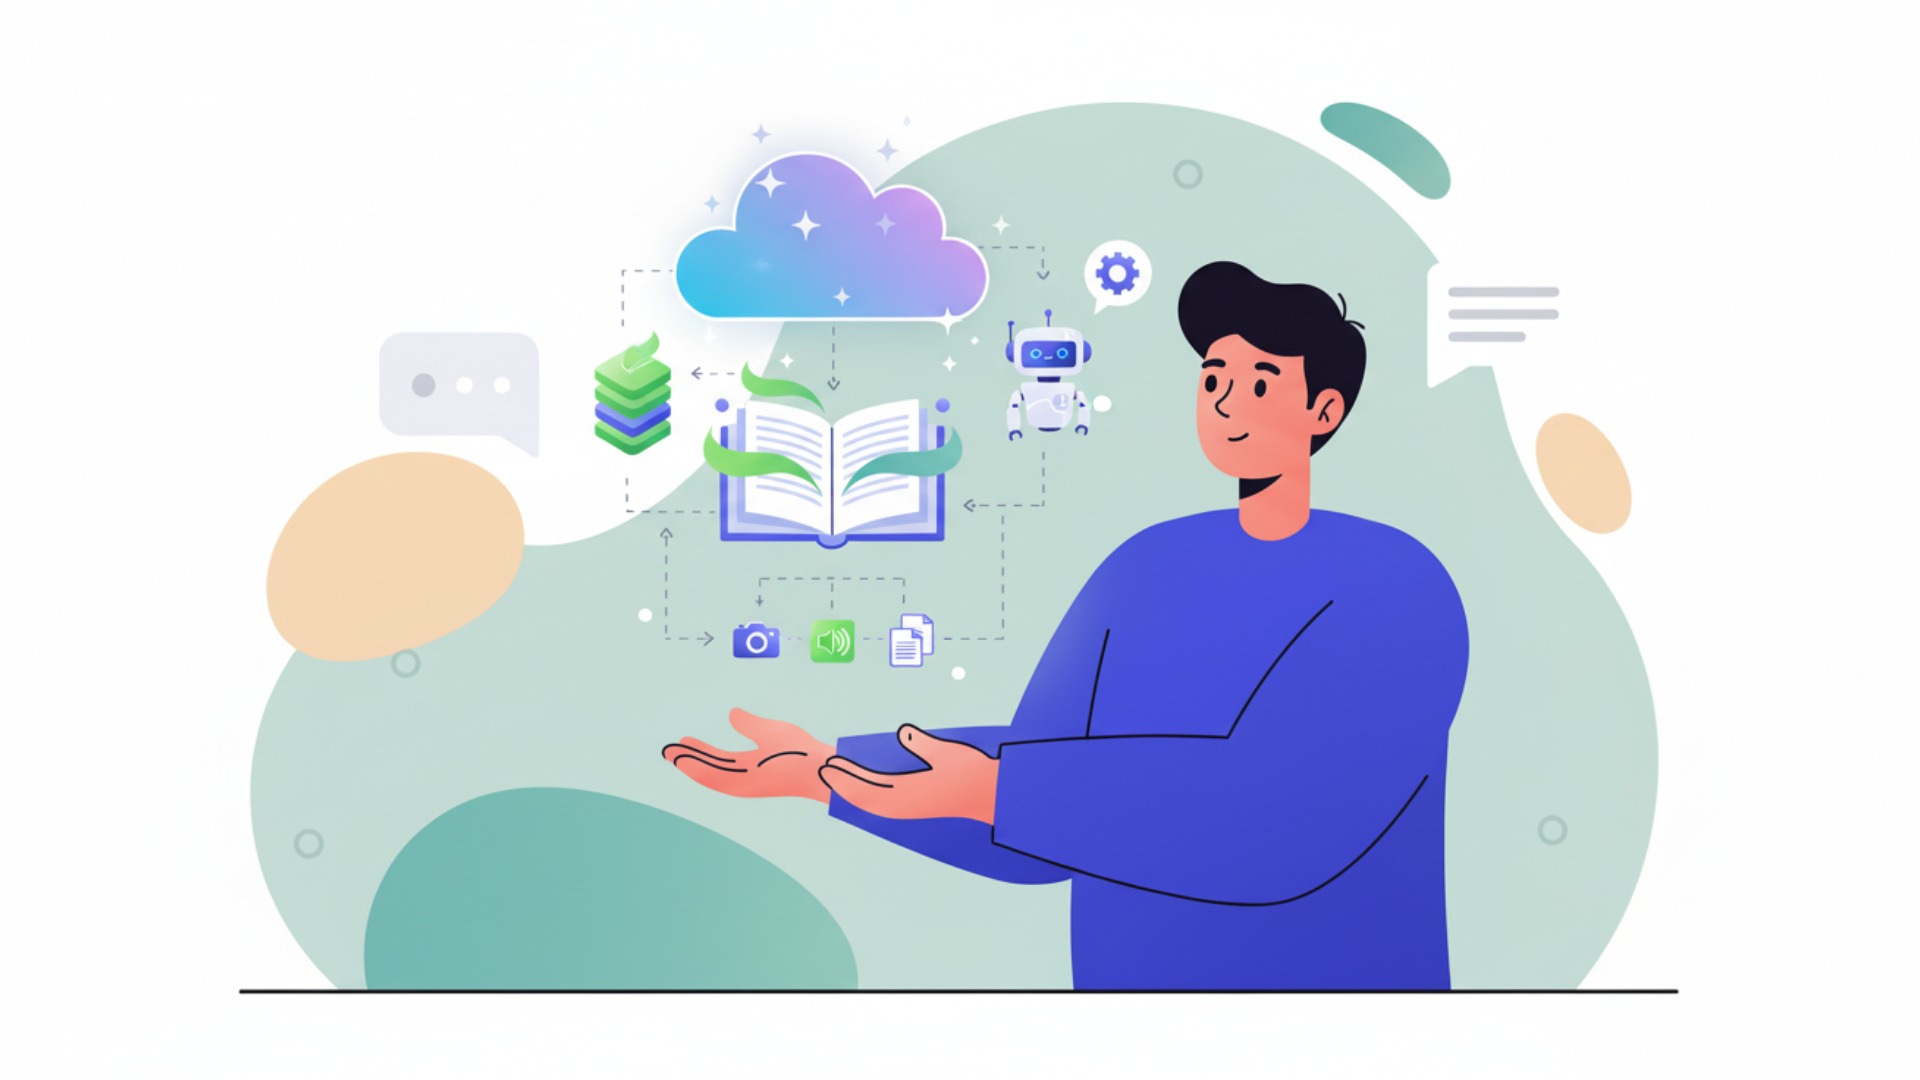
RAG技術は、生成AIの可能性を大きく広げ、今もなお急速な進化を続けています。今後は、テキスト情報だけでなく、画像や音声といった多様なデータを扱う「マルチモーダルRAG」や、自律的にタスクを遂行する「AIエージェント」との連携が、RAGの新たなフロンティアになると予測されています。
マルチモーダルRAGの進化
マルチモーダルRAGは将来だけの構想ではなく、画像などを扱う機能が既に提供されています。例えばAmazon Bedrock Knowledge Basesは、対応する構成で画像やマルチモーダル資料を検索・回答に利用できます。ただし、画像、音声、動画の対応範囲はサービスや処理方式ごとに異なります。図面の読み取りや音声の文字起こしを含め、業務データで検証することが必要です。(出典:Amazon Bedrock Knowledge Bases)
これにより、RAGの活用範囲は製造業の設計部門や、メディア業界のコンテンツ管理など、これまで以上に幅広い分野へと拡大していきます。テキストと画像を組み合わせた検索など、より人間に近い高度な情報検索が実現されると期待されています。
自律型AIエージェントとの連携
もう一つの重要なトレンドは、RAGと自律型AIエージェントの融合です。AIエージェントとは、与えられた目標に対して、自ら計画を立て、必要なツール(RAGによる情報検索を含む)を使いこなしながらタスクを遂行するAIのことです。
例えば、「競合A社の新製品の評判を調査してレポートを作成して」と指示すると、AIエージェントが自律的にWeb検索を行い、関連ニュースやSNSの投稿をRAGで収集・分析し、最終的なレポートを生成する、といったことが可能になります。RAGがエージェントの「知識収集能力」を担うことで、AIは単なる応答システムから、能動的に業務を遂行するパートナーへと進化していくでしょう。
法人向けAI研修
AX CAMP 無料資料
生成AIの導入・活用ならAX CAMP(エーエックスキャンプ)
生成AI、特にRAGのような先進技術の導入には、専門的な知識と戦略的なアプローチが不可欠です。しかし、「何から手をつければ良いかわからない」「社内にAIに詳しい人材がいない」といった課題を抱える企業は少なくありません。もし貴社が同様の課題を感じているなら、実践型の法人向けAI研修・伴走支援サービス「AX CAMP(エーエックスキャンプ)」がお役に立てるかもしれません。
現在のAX CAMPは、業務ヒアリング、14時間のeラーニング、AI化計画のプランニング、実装・改善・定着への伴走を組み合わせた法人向けAI研修です。RAGを使うべき業務かどうかを含め、自社の課題とデータの条件を整理するところから相談できます。(出典:AX CAMP公式サービス)
伴走支援では、AIエージェントの設計・改善、チャットでの質問対応、ミーティングなどを通じて実務活用を支援します。RAGの開発範囲や運用体制、費用・契約条件は個別に確認してください。導入しただけで成果が出ると保証するものではありません。まずは相談を通じて対象業務を整理しましょう。

法人向けAI研修
AX CAMP 無料資料
生成AIとRAGに関するよくある質問
RAGを使えば誤回答はなくなりますか?
なくなるとは限りません。参照データの誤り、検索漏れ、生成時の誤読が残るため、原資料の確認や回答を控える設計が必要です。
RAGとファインチューニングは併用できますか?
併用できます。検索で新しい知識を補い、追加学習で応答形式やタスクへの対応を調整するなど、目的に応じて役割を分けます。
RAGは社内資料を自動で安全に扱えますか?
RAGという方式だけでは安全性は保証されません。取り込みと検索の権限制御、外部APIへの送信範囲、ログ保存、データ更新・削除の反映を確認します。
まとめ:生成AIとRAGを理解し、ビジネス活用を次のレベルへ
本記事では、生成AIの回答精度と信頼性を飛躍的に向上させる技術「RAG(検索拡張生成)」について、その仕組みからメリット、具体的な活用事例、導入のポイントまでを網羅的に解説しました。最後に、重要なポイントを振り返ります。
- 外部DBの参照:RAGは外部の知識データベースを参照して回答を生成する技術です。
- 信頼性の向上:ハルシネーションを抑制し、回答の根拠を提示できます。
- 情報の鮮度:更新・索引化した資料を検索対象にし、新しい情報を回答へ反映できます。
- コスト効率:ファインチューニングに比べて低コストかつ迅速に導入できる場合があります。
- 成功の鍵:導入目的の明確化と、参照するデータの品質担保が重要です。
RAGは、生成AIが抱えていた「不正確さ」や「情報の古さ」といった課題を克服し、ビジネスの現場で本格的に活用するための鍵となる技術です。社内情報の検索、顧客対応の自動化、専門的な調査業務の支援など、その応用範囲は非常に広く、多くの企業にとって大きな業務効率化と生産性向上をもたらすポテンシャルを秘めています。
もし、この記事を読んで「自社でもRAGを活用してみたい」「AI導入を具体的に進めたい」と感じられたなら、ぜひAX CAMP(エーエックスキャンプ)にご相談ください。専門的な知見と豊富な支援実績を持つ私たちが、貴社のAI活用を成功へと導くための最適なプランをご提案します。AIを単なるツールとしてではなく、事業成長を加速させる強力な武器とするために、私たちと一緒に最初の一歩を踏み出しましょう。
法人向けAI研修
AX CAMP 無料資料
