「LLMの性能を比較したいけれど、パラメータ数の意味が分からない」「自社の用途に合うモデルを選びたい」。この記事では、パラメータ数が公表されたモデルを具体的に比較し、APIモデルも含めた実務での選び方を解説します。
パラメータ数はモデル規模の目安ですが、性能をそれだけで判断することはできません。実際の業務で必要な精度、速度、費用、運用条件も合わせて見ていきましょう。
法人向けAI研修
AX CAMP 無料資料
LLMの「パラメータ数」とは?性能を測る基本指標を理解する
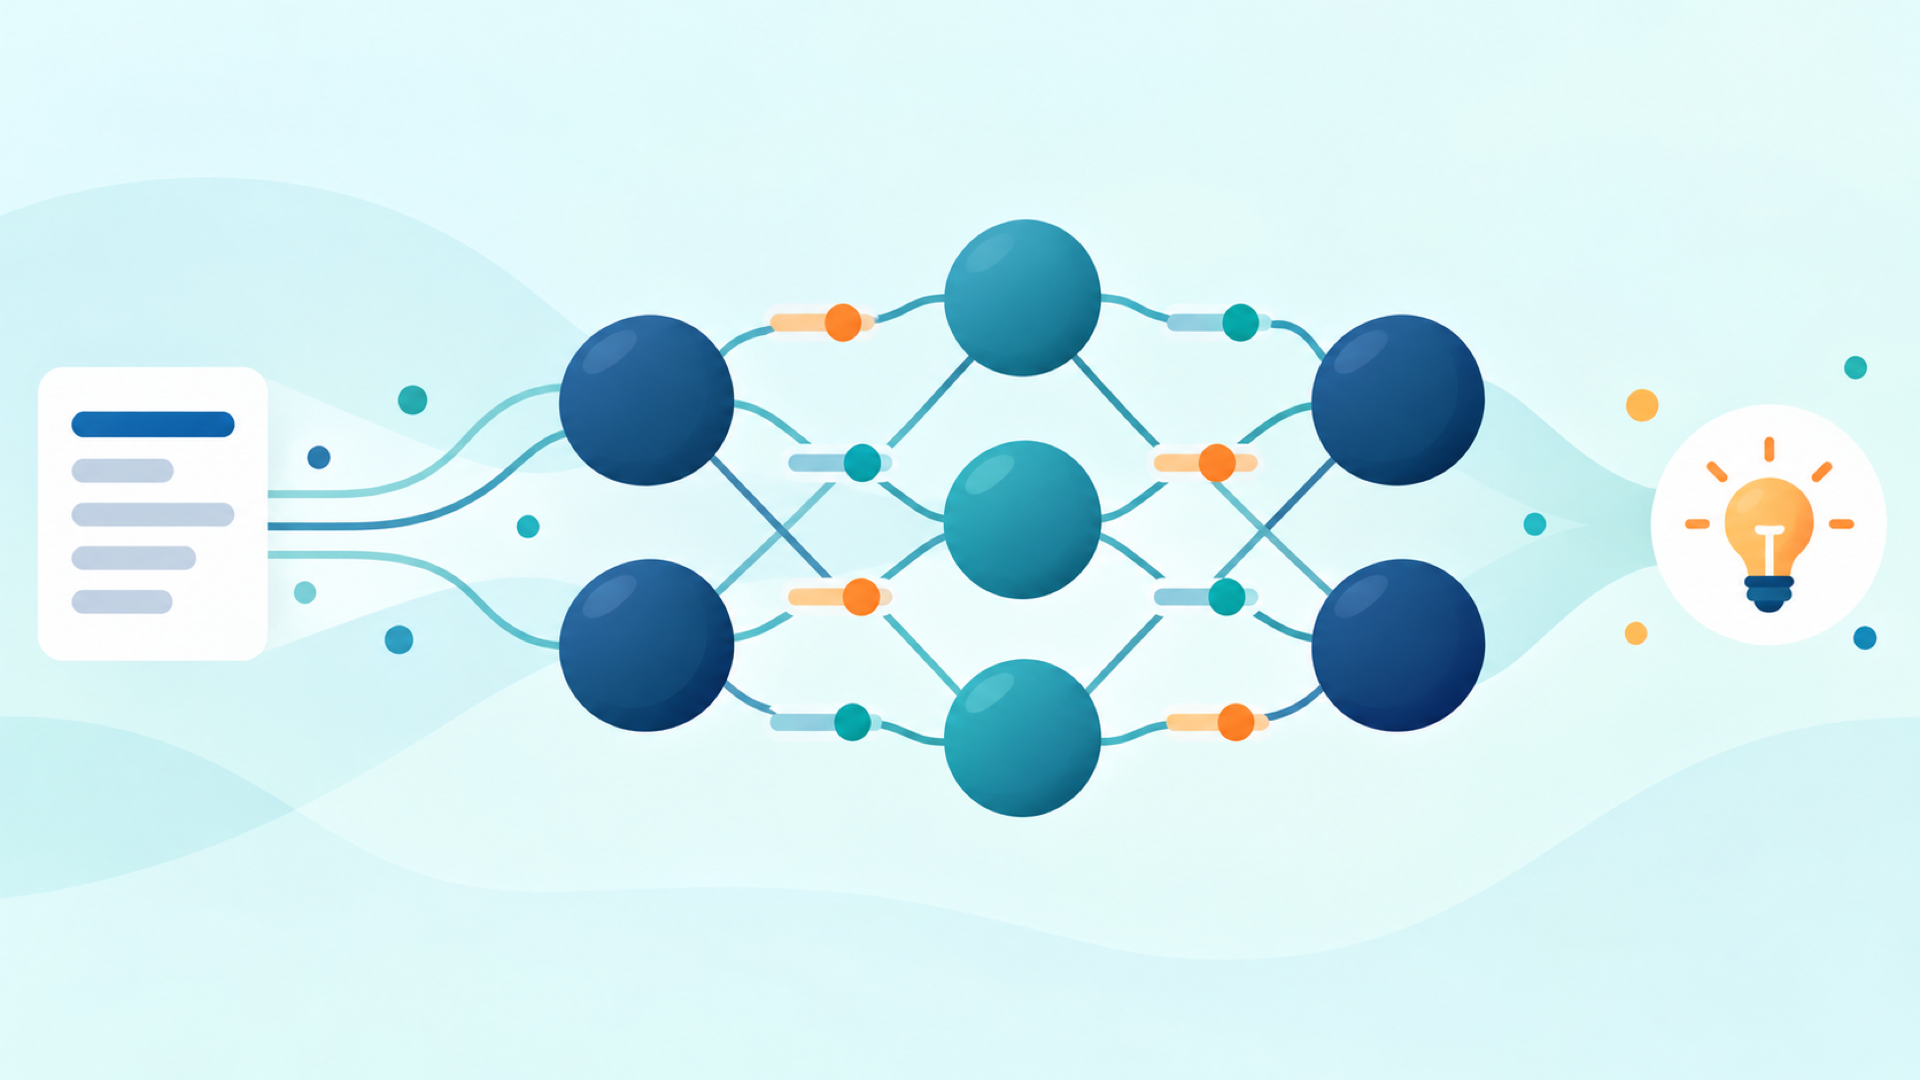
パラメータとは、モデルが学習を通じて調整する内部の数値です。入力に対してどのような出力を返すかを計算するときに使われます。数はモデルの規模を知る手掛かりですが、学習データ、構造、調整方法なども結果に影響します。
パラメータが担う役割と仕組み
文章を生成する言語モデルは、入力やそれまでの出力を基に、次に続く「トークン」の確率を計算します。トークンは単語全体とは限らず、文字や単語の一部の場合もあります。確率が最も高い候補を選ぶ方法のほか、生成設定に応じて候補を選ぶ方法もあります。
パラメータはこの計算に使われる値です。人間の知識が項目ごとにそのまま保存されているわけではなく、学習で得たパターンがモデル全体に分散して反映されます。
モデルの規模を示す「B(ビリオン)」
BはBillion、つまり10億です。8Bなら約80億、70Bなら約700億を表します。例えばOpenAIのGPT-2は1.5B、GPT-3は175Bと公表されました。ただし異なる時代や構造のモデルを、数だけで性能順に並べることはできません。
公開モデルのパラメータ数比較と、主要AIモデルの選び方
GPT、Gemini、Claudeの一部のモデルは、総パラメータ数を公表していません。まず公表された数値を持つモデルを比較し、続いてAPIで利用するモデルの選択肢を紹介します。以下のモデルは比較例であり、すべてが同じ用途や実行環境向けではありません。
| モデル | 公表パラメータ数 |
|---|---|
| OpenAI gpt-oss-20b | 総数20.9B/使用3.6B |
| OpenAI gpt-oss-120b | 総数116.8B/使用5.1B |
| Google Gemma 4 12B | 約11.95B |
| Google Gemma 4 31B | 約30.7B |
| Google Gemma 4 26B A4B | 総数25.2B/使用3.8B |
| Meta Llama 4 Scout | 総数109B/使用17B |
| Meta Llama 4 Maverick | 総数400B/使用17B |
| LLM-jp 4 8B Base | 総数約8.59B |
「総数」はモデル全体、「使用」はMoE型モデルが各トークンの処理で使うパラメータ数です。使用数が小さくても、モデル全体を扱うためのメモリが必要になる場合があります。数値は速度や品質の順位を示すものではありません。
出典:OpenAI gpt-ossモデルカード/Gemma 4モデルカード/Meta Llama 4発表/LLM-jp 4モデルカード
1. OpenAIのGPT系列
GPT系列には、複雑な推論やコード作成を扱うモデルと、速度や費用を重視するモデルがあります。利用するモデルを選ぶ際は、実際に使うAPIや製品のモデル一覧で利用可能な版を確認し、同じ業務で精度と費用を比較します。公表されていないパラメータ数を推定して比較することはできません。
一方、公開重みのgpt-ossには20bと120bがあり、MoE型の総パラメータ数はそれぞれ20.9B、116.8Bです。用途に応じて公開APIモデルとは別に検討できます。
2. GoogleのGemini・Gemma系列
GeminiはAPIなどで利用するモデル系列です。複雑な処理向けのPro、速度と能力のバランスを取るFlash、大量処理や低遅延を重視するFlash-Liteでは、想定用途や提供状態が異なります。選択時はモデルごとの入力形式、料金、安定版かプレビューかを確認しましょう。
Gemmaは別の公開重みモデル系列です。Gemma 4には12Bや31BのほかMoE型があり、自社で実行する際の規模や条件を比較できます。
3. AnthropicのClaude系列
Claudeには、複雑なエージェント作業やコーディング向けのモデルと、速度・費用とのバランスを重視するモデルがあります。モデルの版によって利用条件や機能が変わるため、実際に使うサービスの一覧で確認し、対象業務で比較しましょう。
出典:Claudeモデル概要
4. MetaのLlama系列
Llama 4 Scoutは総数109B・使用17B、Maverickは総数400B・使用17BのMoE型モデルです。重みが公開されているため、自社環境での利用や調整を検討できます。実行に必要な資源とともに、Llama 4 Community Licenseの利用・再配布条件を確認しましょう。
出典:MetaのLlama 4発表/Llama 4ライセンス
5. 日本で開発された公開モデル
LLM-jpの4 8B Baseは、日本語と英語を扱う約8.59Bの基盤モデルです。対話用途には指示応答向けに調整されたモデルも比較します。LLM-jp 4 8B BaseのモデルカードにはApache License 2.0が記載されています。
Llama 3.1 Swallowには8Bと70Bがあり、Llama 3.1を基に日本語能力を拡張しています。日本語向けモデルでも開発方法や利用条件は同じではありません。個別モデルのカードとライセンスを確認しましょう。
パラメータ数が公表されていないモデルはどう比較する?
数値が公表されていない場合、パラメータ数による直接比較はできません。ただし、入力できる情報の種類、コンテキストの長さ、料金、利用条件、同じ業務データでの回答品質は比較できます。非公開の理由は提供元ごとに異なり、一律には判断できません。
例えば社内FAQなら、同じ質問を候補モデルに与え、正しい回答の割合、根拠を示せるか、答えられない質問を無理に回答しないかを評価します。そのうえで応答時間と利用料を比べると、数値が公開されていなくても選択できます。
パラメータ数とLLMの性能は比例するのか?
パラメータ数が大きいモデルが、あらゆる用途で優れるとは限りません。学習データ、モデル構造、調整方法、利用時の設定も結果を左右するからです。
「パラメータ数が多い=高性能」の神話と現実
スケーリング則は、一定の条件でモデル規模、データ量、計算量と学習時の損失との間に観測された経験的な関係です。異なるモデル同士の業務精度を、パラメータ数だけで保証する法則ではありません。
MoE型では、モデル全体の一部の専門層を各トークンの処理に使います。総数と使用数が異なるため、両方を確認しましょう。実際の速度や必要メモリは、機器や実装、量子化、入力の長さにも左右されます。
出典:Scaling Laws for Neural Language Models/Gemma 4のメモリ要件
学習データの質と量が性能に与える影響
学習データに偏りや誤りがあれば、モデルの回答にも影響する可能性があります。対象業務に必要な知識を扱えるか、公開ベンチマークだけでなく自社の例でも確認しましょう。データが多いことだけで、正確さが保証されるわけではありません。
パラメータ数だけでない!LLMの性能を比較する重要指標
モデルの選定では、回答品質、速度、費用、データの取り扱いを合わせて比較します。
ベンチマークスコア(Nejumi LLM Leaderboardなど)
ベンチマークは、一定の課題で複数モデルを評価する参考情報です。日本語の比較にはWeights & Biases Japanが運営するNejumi Leaderboardもあります。評価問題や採点方法、モデルの版によって結果は変わるため、順位を自社業務の精度と同一視しないようにしましょう。
ビジネス指標で見る:速度、コスト、タスク適合性
速度は実際の入力長と同時利用数で測り、コストは入力・出力トークン、ツール利用料、運用費を含めて比較します。タスク適合性は、代表的な問い合わせや文書を使い、正答率、抜け漏れ、必要な人手の修正で評価します。機密情報を扱う場合は、送信先、保存、アクセス権限、契約条件も確認します。
性能評価の新基準:ベンチマークスコアでLLMを比較する方法
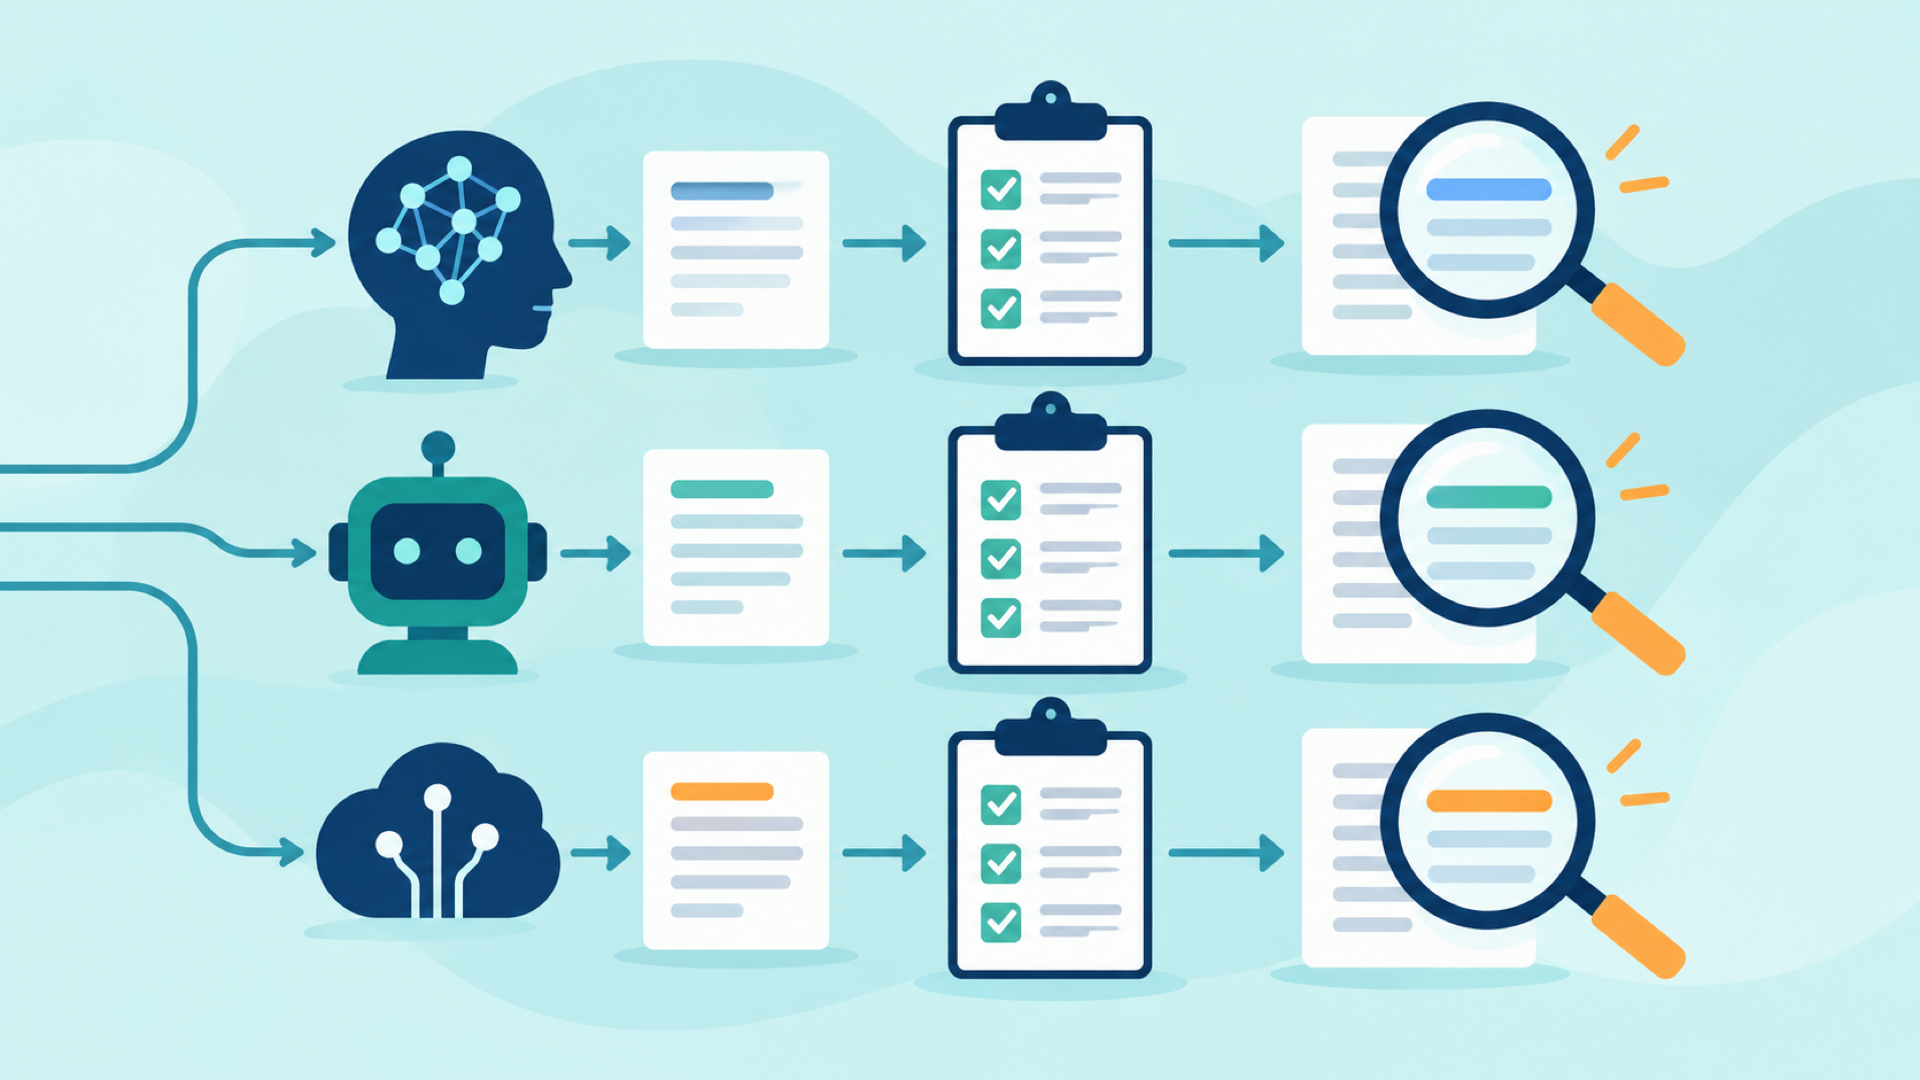
ベンチマークには、一般的な知識、数学、コーディング、日本語の読解や指示応答など、異なる能力を測るものがあります。結果を比べるときは、同じ評価版・問題・設定の結果かを確認します。
次に、自社業務から代表的な例を用意します。FAQなら正答・誤答・回答不能を適切に示した割合、要約なら重要事項の抜けと事実誤認、コードなら指定テストの通過を確認します。同じ例と条件で比較することで、公開スコアだけでは分からない実用上の差を見つけられます。
パラメータ数を基にしたLLMの賢い選び方
ビジネス要件とコストのバランスを考える
まず、対象業務と求める精度を決めます。例えば問い合わせ分類なら分類の正しさと処理件数、文書分析なら重要事項の漏れと根拠の確認しやすさが判断材料です。候補を同じデータで試し、品質の要件を満たした中から速度と総費用が合うものを選びましょう。
ファインチューニングやRAGの活用を前提としたモデル選定
ファインチューニングは既存モデルを追加学習で調整する方法です。特定の形式やタスクで改善する場合があります。一方、RAGは回答時に外部情報を検索し、参照内容をモデルに渡す方法です。検索漏れや誤回答は起こり得るため、権限設定と回答の検証が必要です。
RAGはAPIモデルにも公開重みモデルにも組み合わせられます。知識を参照したいのか、出力形式や振る舞いを調整したいのかを分けて検討しましょう。
公開重みモデルとAPIモデル:自社に合うLLMの選び方
APIモデルは、提供元の環境でモデルを利用でき、自社で重みやサーバーを管理せずに試せます。入力・出力に応じた利用料、データの保存や利用条件、提供終了時の移行方法を確認します。
公開重みモデルは、ライセンスの範囲内で自社環境への配置や調整を検討できます。データや運用を管理しやすい一方、計算資源、アクセス管理、更新、監視を自社で担います。重みが公開されていても利用・再配布の条件はモデルごとに異なります。
どちらも条件次第で費用や安全性が変わります。対象データの管理方法と運用体制を先に決め、同じ業務で比較しましょう。
【目的別】LLMとSLM(小規模言語モデル)の使い分け
SLMは比較的小規模な言語モデルを指す呼び方で、LLMとの間に一律の境界はありません。小型モデルは条件によって計算資源を抑えられますが、速度・費用・精度は実行環境にも左右されます。
汎用的なタスクに向いているモデル
長い資料の分析や複数の手順を伴う課題では、必要な推論やコンテキストに対応するモデルを候補にします。市場調査、企画案、契約書の要約などでは、生成された内容の根拠確認や専門家による確認も必要です。
比較的小型のモデルを試しやすい場面
メール分類、定型的な情報抽出、範囲の決まったFAQ応答は、小型モデルを試す候補です。音声会議の場合は、音声認識モデルで文字起こしした後、言語モデルで要約・分類する構成も考えられます。端末で動くかどうかはモデルと機器の組み合わせで確認します。
LLM活用を成功させた企業事例
以下は各社の事例であり、同じ効果を保証するものではありません。
グラシズ様の事例
グラシズ様は、AX CAMPを通じてAI活用を進め、LPライティング業務を内製化しました。同社への取材では、従来3営業日かかっていたライティング作業が約2時間になり、約10万円/本の外注費が0円になったと説明されています。
出典:グラシズ様インタビュー
WISDOM社様の事例
WISDOM社では、運用数値の管理シート生成やタスクのリマインドなど、周辺業務の自動化に取り組みました。毎日約2時間を要していたアポイント調整については、LINEボットによる自動化を計画。同社はAI活用の可能性を踏まえ、予定していた2名の採用を見送ったと説明しています。調整業務の自動化は、取材時点では今後実装する計画でした。
Route66様の事例
Web・SNSマーケティングを手がけるRoute66様は、動画広告の制作から記事作成までを通じて企業の新規顧客獲得を支援しています。同社によると、従来は記事1本の原稿執筆に最短でも3時間、最大24時間かかっていました。AX CAMP受講後はAIによる原稿の出力が約10秒で得られるようになり、記事作成の作業時間を削減したといいます。10秒はAIの出力時間であり、画像の準備や装飾を含む記事全体の完成時間ではありません。
出典:Route66様インタビュー/Route66公式会社概要
最新LLMのビジネス活用ならAX CAMPの研修がおすすめ
LLMの選定では、パラメータ数だけでなく、業務に必要な精度、費用、速度、データの管理方法を総合して考える必要があります。自社の課題を基に、実際の業務で試すことが重要です。
AX CAMPは、企業の実務課題を題材に、AI活用や業務AI化のスキル習得を支援する法人向け研修です。自社で取り組む業務や受講内容について相談できます。

法人向けAI研修
AX CAMP 無料資料
LLMのパラメータ数比較に関するFAQ
LLMの「パラメータ数」とは具体的に何を指し、性能とはどのように関係しますか?
モデルが学習を通じて調整する内部の数値の個数です。モデル規模の目安になりますが、構造、学習データ、調整方法なども性能に影響するため、数だけで優劣は決まりません。
パラメータ数が公開されていないモデルはどう比較しますか?
同じ業務データを用いた回答品質に加え、応答時間、費用、入力形式、データの取り扱いを比較します。非公開の理由は各社が明らかにしていない限り推測しません。
LLMを比較選定する際、パラメータ数以外にどのような指標を重視すべきですか?
対象業務での正確性、必要な人手の修正、速度、費用、機密情報の管理方法を重視します。ベンチマークは候補を絞る参考にし、最後は自社の条件で比較しましょう。
まとめ:LLMのパラメータ数比較で自社に最適なモデルを見つけよう
パラメータ数はモデルの規模を知る目安です。MoE型では総数と処理時に使用する数を区別しましょう。パラメータ数が公表されていないモデルも、回答品質、速度、費用、利用条件を用いて比較できます。
自社に合うモデルを選ぶには、代表的な業務データで候補を試し、必要な精度を満たすかを確認することが大切です。運用する場所やライセンス、データの取り扱いも合わせて検討しましょう。
法人向けAI研修
AX CAMP 無料資料
