自社に蓄積されたデータや専門知識を活用し、汎用的な大規模言語モデル(LLM)を特定の業務に最適化したいと考えていませんか。
その強力な手法が
「ファインチューニング」です。しかし、その仕組みやメリット、他の技術との違いを正確に理解している担当者はまだ多くありません。
この記事では、LLMのファインチューニングについて、その基本からメリット・デメリット、具体的な手順、そして混同されがちなRAG(検索拡張生成)との違いまでを分かりやすく解説します。
最後まで読めば、自社の目的に合わせてLLMをカスタマイズし、独自の高精度なAIを開発するための具体的な道筋が見えるはずです。AI活用の成果を最大化するための第一歩として、ぜひご一読ください。
ChatGPT・RAG・AIエージェントなど、導入検討で迷いやすいAI用語を実務目線で整理。
LLMファインチューニングとは?
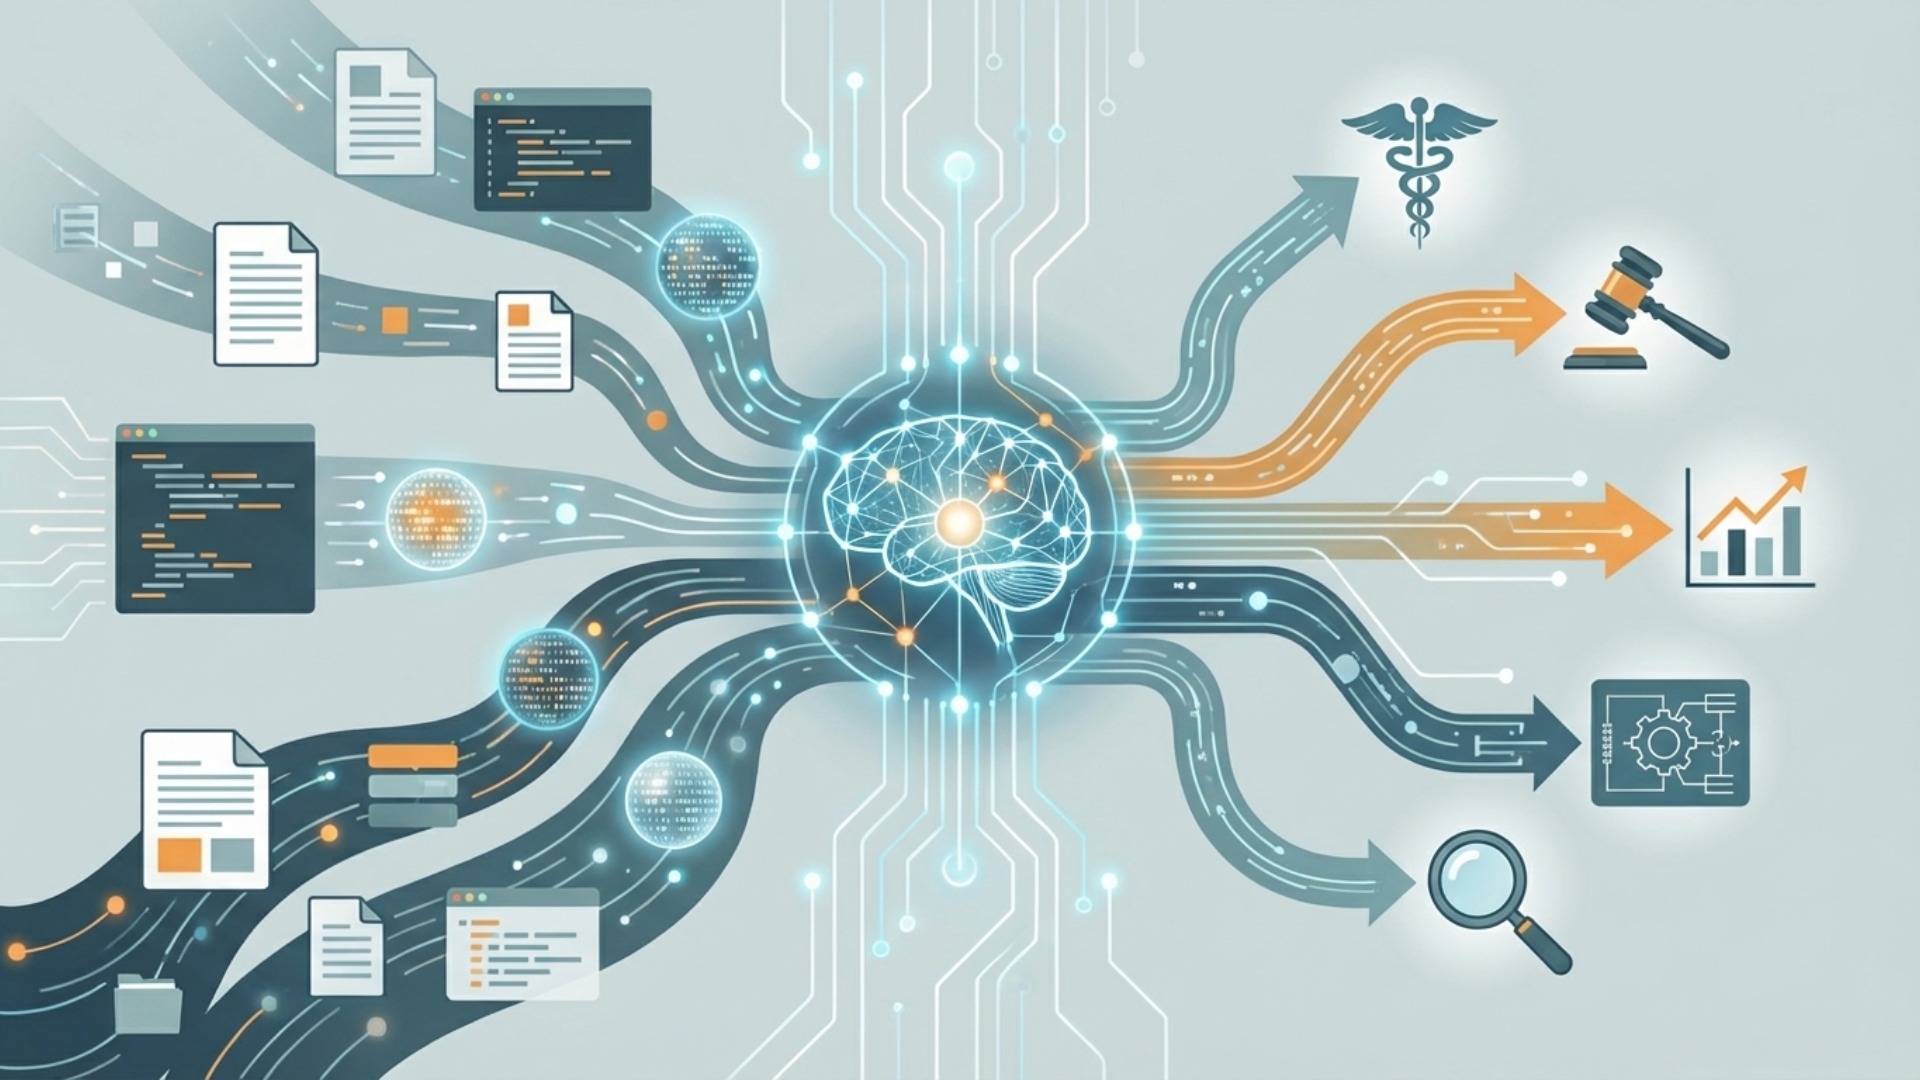
LLMファインチューニングとは、既存の学習済み大規模言語モデル(LLM)に対し、特定のタスクや専門分野に特化した追加の学習を行う技術のことです。 このプロセスを経ることで、モデルは汎用的な知識に加え、特定の要求に応えるための専門的な能力を獲得します。
料理に例えるなら、市販のだしを土台に、料理に合わせて味を調整するイメージです。ただし、追加学習で改善するのは評価したタスクの範囲であり、あらゆる応答の質が上がるわけではありません。
LLMを特定タスクに特化させる技術
ファインチューニングの核心は、LLMを「万能なアシスタント」から「特定の業務のプロフェッショナル」へと進化させる点にあります。一般的なLLMは幅広い知識を持っていますが、特定の業界用語や社内独自の言い回し、特殊な応答形式には対応しきれない場合があります。
そこで、自社が求める応答形式や文体のサンプルデータを学習させることで、モデルの振る舞いを調整します。例えば、以下のようなタスクに特化させられます。
- 顧客サポート用の丁寧な言葉遣い
- マーケティング用の魅力的なキャッチコピー生成
- 法務文書のような厳格なフォーマットでの文章作成
このように、特定の用途に合わせてモデルの応答スタイルを最適化するのが、ファインチューニングの主な目的と言えるでしょう。
ベースモデルとファインチューニングモデルの関係
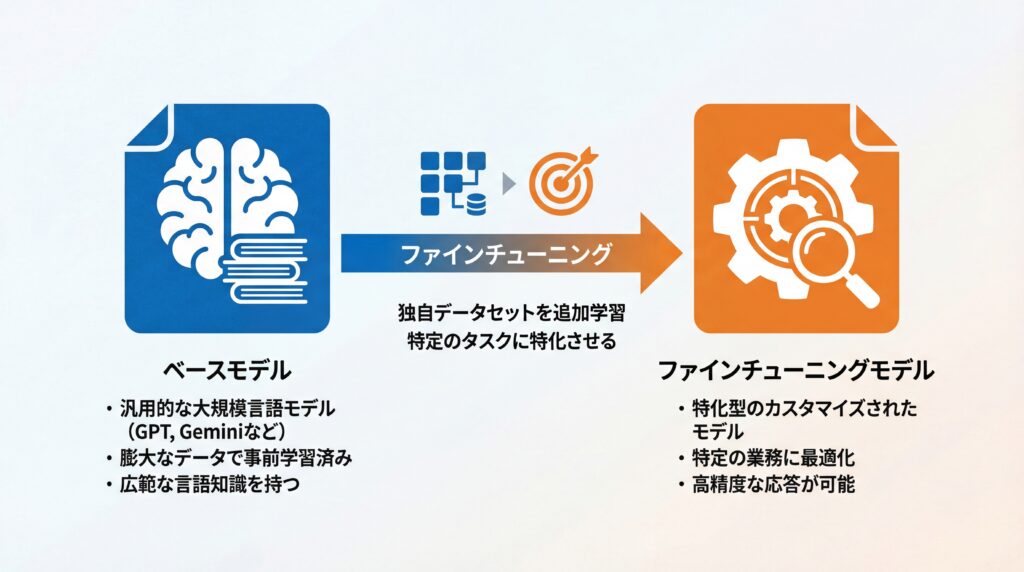
ファインチューニングは、事前学習済みのベースモデルを土台にします。ただし、推論APIで使えるモデルが、そのまま追加学習にも対応するとは限りません。利用する提供元・サービスごとに、学習可能なモデルID、利用資格、提供終了日を確認してください。Google Cloudでも、推論用の最新モデル一覧と追加学習の対応一覧は別です。(参考:Google Cloudの対応モデル一覧)
PEFTは、モデル全体ではなく一部または追加のパラメータを調整し、学習・保存に必要な計算資源を抑える手法の総称です。汎用能力の保持や精度向上を保証するものではないため、対象業務と従来タスクの両方を、学習に使わないデータで比較評価しましょう。(参考:Hugging Face PEFT公式資料)
事前学習をゼロから行う場合に比べ、既存モデルを活用して開発範囲を絞れます。ただし、必要なデータ量・計算資源・精度はモデルやタスクで異なり、少量・低コストで高性能になるとは限りません。
計算資源を抑えるPEFT・LoRAという選択肢
モデルの全パラメータを更新するフルファインチューニングに対して、更新対象を絞る方法もあります。必要なメモリ、学習時間、運用時の構成を比較して、目的に合う方法を選びます。
PEFTの代表例にLoRAがあります。追加の低ランク行列など、少数のパラメータを学習することで計算・保存コストを抑えられますが、効果は設定とデータ次第です。全パラメータ更新と同等の精度になるかは、対象タスクで確認が必要です。(参考:PEFT公式資料)
自社環境で扱えるモデルや計算資源、クラウドの対応モデルを確認し、小規模な検証から導入可否を判断しましょう。導入後も品質確認と更新の費用を見込んでおく必要があります。
ファインチューニングのメリット・デメリット
ファインチューニングは、モデルの性能を特定の方向に大きく向上させる強力な手法ですが、その一方でコストや専門性といった課題も存在します。導入を検討する際は、これらの両側面を正確に理解し、自社の目的やリソースと照らし合わせることが不可欠です。
ここでは、ファインチューニングがもたらす主要なメリットと、事前に考慮すべきデメリットを具体的に解説します。
メリット:モデル性能の向上と特定ドメインへの適応
ファインチューニングでは、特定の分類・要約・文体などのタスクで性能向上を目指せます。効果は未学習の評価データで確かめ、元のモデルやプロンプト改善だけの方法と比較します。次の項目は改善を検討できる対象で、すべてが必ず向上するわけではありません。(参考:Google Cloud公式ガイド)
- 特定タスクでの高精度化
- 専門用語や文脈の理解
- 応答スタイルの統一
- プロンプトの簡略化
医療要約の研究例では、FaMeSummが医療知識を用いた追加学習により、対象データセット上の要約の忠実性を改善しました。これは2023年の特定の研究条件での結果で、現行LLM全般や診療での安全性を保証しません。診断・治療の代替にせず、専門家の確認が必要です。(出典:FaMeSumm原論文)
法人向けAI研修
AX CAMP 無料資料
デメリット:高いコストと専門知識の必要性
多くのメリットがある一方で、ファインチューニングには無視できないデメリットも存在します。導入の障壁となりうる主な課題は以下の通りです。
- 高品質なデータセットの準備
- 高い計算コスト
- 専門的な技術知識
- 過学習のリスク
必要な学習データ量は一律に数千件ではありません。例えばOpenAIのSFTガイドでは最低10件、まず良質な50件から評価することを案内しています。ただし、これは同社の対象サービスの条件で、他の学習方式に共通する基準ではありません。クラウドのマネージド学習では自社でGPUを所有する必要はなく、学習料金・データ準備・評価・運用の費用を合わせて見積もります。(参考:OpenAI SFTガイド)
他のLLMカスタマイズ手法との違い
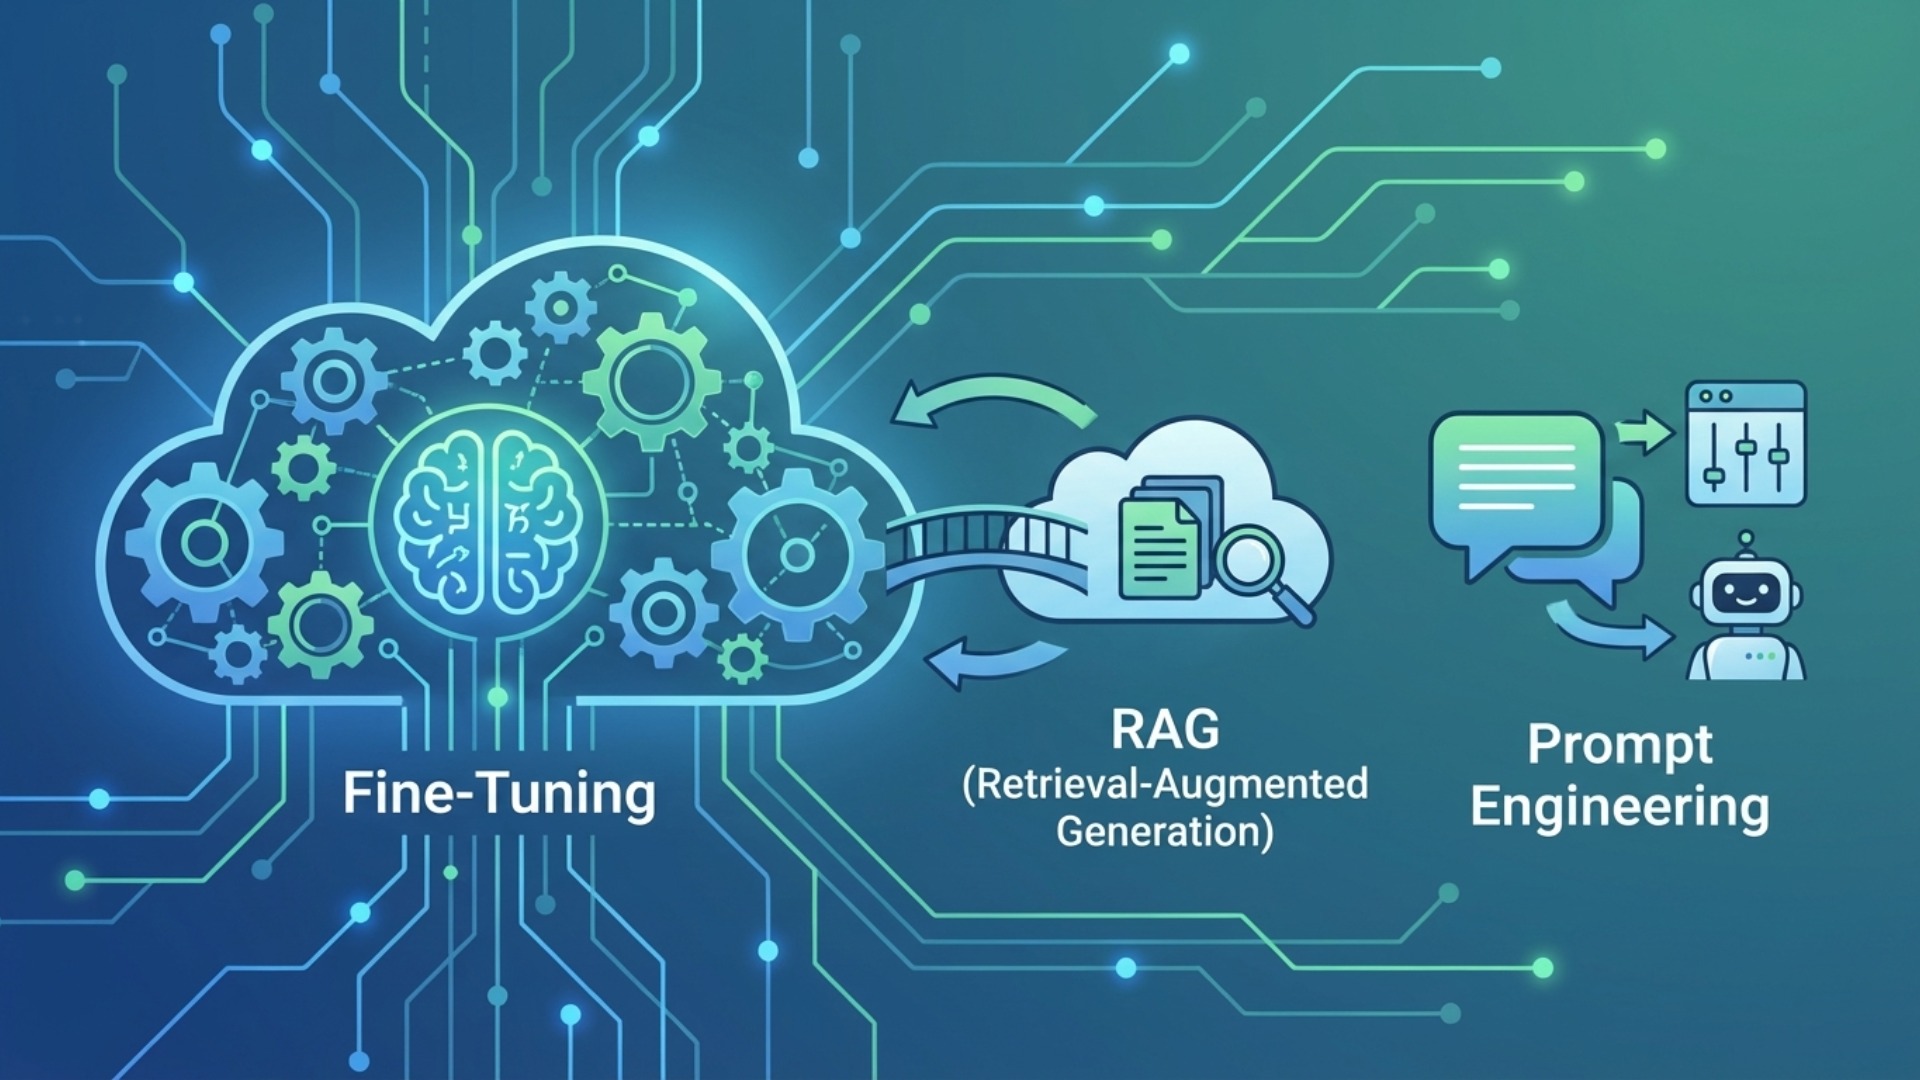
LLMを自社の業務に最適化する手法は、ファインチューニングだけではありません。代表的な手法として「RAG(検索拡張生成)」や「プロンプトエンジニアリング」があり、目的やコストに応じてこれらを使い分けることが重要です。各手法の特性を理解し、最適なアプローチを選択しましょう。
ここでは、それぞれの技術が持つ特徴と、ファインチューニングとの具体的な違いを比較・解説します。
RAG(検索拡張生成)との使い分け
ファインチューニングはモデルのパラメータを調整し、RAGは外部情報を検索して入力に加えます。文体や分類の改善には前者、頻繁に更新する社内文書の参照には後者を検討できますが、両者を組み合わせることもあります。(参考:NTTテクノクロスの解説)
今日の社内報を要約するなら、本文を直接入力するか、RAGで必要な情報を取り出す方法をまず検討できます。ファインチューニングで新情報を学ばせることが原理的に不可能なのではなく、更新のたびに再学習する負担を避けやすい点が、外部参照の利点です。
社内の回答形式や口調をそろえたい場合も、まずプロンプトと回答例で基準を作り、それで足りない場合に追加学習を比較検証します。文書の参照が必要ならRAGも併用できます。以下は判断の目安です。
| 項目 | ファインチューニング | RAG |
|---|---|---|
| 変更する部分 | モデルのパラメータ | 検索して入力する情報 |
| 検討する用途 | 分類、文体、形式などの改善 | 社内文書や更新情報の参照 |
| 更新・管理 | 学習データ更新と再学習・評価 | 原文・索引・検索品質・アクセス権の管理 |
| 費用の比較 | データ準備、学習、推論、評価を合算 | 文書整備、検索基盤、推論、評価を合算 |
プロンプトエンジニアリングとの比較
プロンプトエンジニアリングは、LLMへの指示(プロンプト)を工夫することで、望んだ出力を引き出す技術です。これは、モデル自体には一切手を加えず、対話の方法を変えるだけなので、最も手軽で即時性のあるカスタマイズ手法と言えます。
しかし、複雑な要求を伝えようとするとプロンプトが非常に長くなりがちで、毎回同じ指示を繰り返す手間が発生します。また、指示の仕方によって出力の質が安定しないこともあります。
追加学習により長い指示や例を減らせる場合がありますが、短い指示で常に高品質になるわけではありません。データ準備・学習・モデル更新も含む総費用と品質を、プロンプトだけの方法と比べて判断しましょう。
ファインチューニングでできること・できないこと
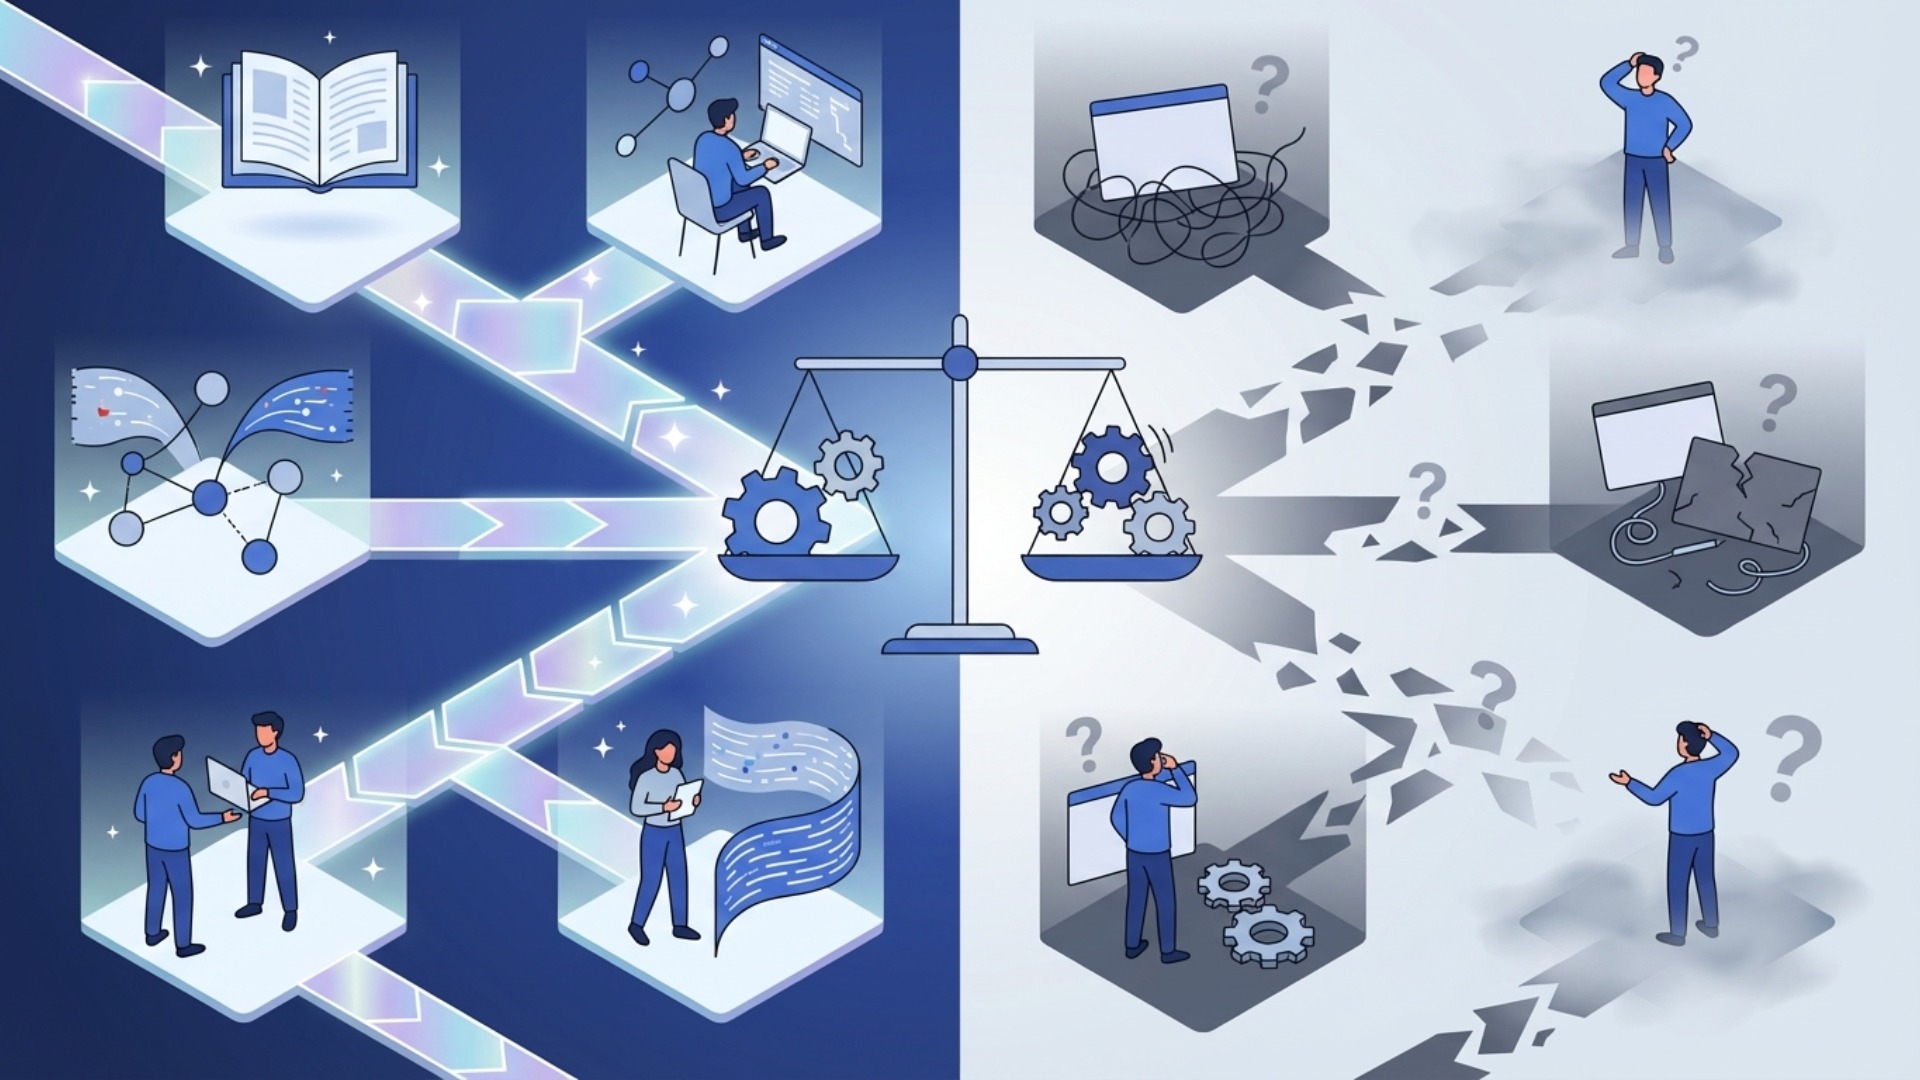
ファインチューニングには、文体・形式・タスクへの適応などの用途があります。新しい知識を学ばせることもできますが、事実の正確な保持・更新や誤回答の防止を保証する方法ではありません。目的ごとに評価が必要です。
ここでは、追加学習の対象にしやすいタスクと、追加学習だけでは保証できない性質を整理します。
得意なタスク:文体・口調の統一、出力形式の制御
文体や出力形式は追加学習の対象にできます。ただし、改善の程度や例外入力への対応は、学習データとモデルの条件によって異なります。次の用途でも、評価と出力検証を組み合わせましょう。
- 文体・口調の統一
- 特定の出力形式の遵守
- 専門用語への適応
- タスク特化の精度向上
指定した口調やJSON形式の出力を促すことはできますが、ファインチューニングだけで必ず形式を守るとは限りません。形式保証が必要な場合は、対応モデルの構造化出力機能の条件を確認し、スキーマ検証・エラー処理も組み合わせてください。コード生成でも、生成物のレビューとテストが必要です。
法人向けAI研修
AX CAMP 無料資料
追加学習だけでは保証できないこと:知識の正確性・更新と幻覚の防止
追加学習で知識が変化することはありますが、新事実を正確に記憶し、どの質問にも一貫して答えられるとは限りません。頻繁に変わる情報や出典の提示が必要な情報は、外部データの参照も検討します。
- 新情報の正確な記憶と継続的な更新の保証
- 事実誤認(ハルシネーション)の完全な抑制
- 安全性・公平性を追加学習だけで保証すること
新製品や社内規程のように更新する情報は、RAGや直接入力の方が管理しやすい場合があります。ただし、RAGも検索漏れや誤回答があり、権限管理と出典確認が必要です。追加学習と外部参照のどちらを使っても、重要な回答は人が確認してください。
LLMファインチューニングの具体的な手順
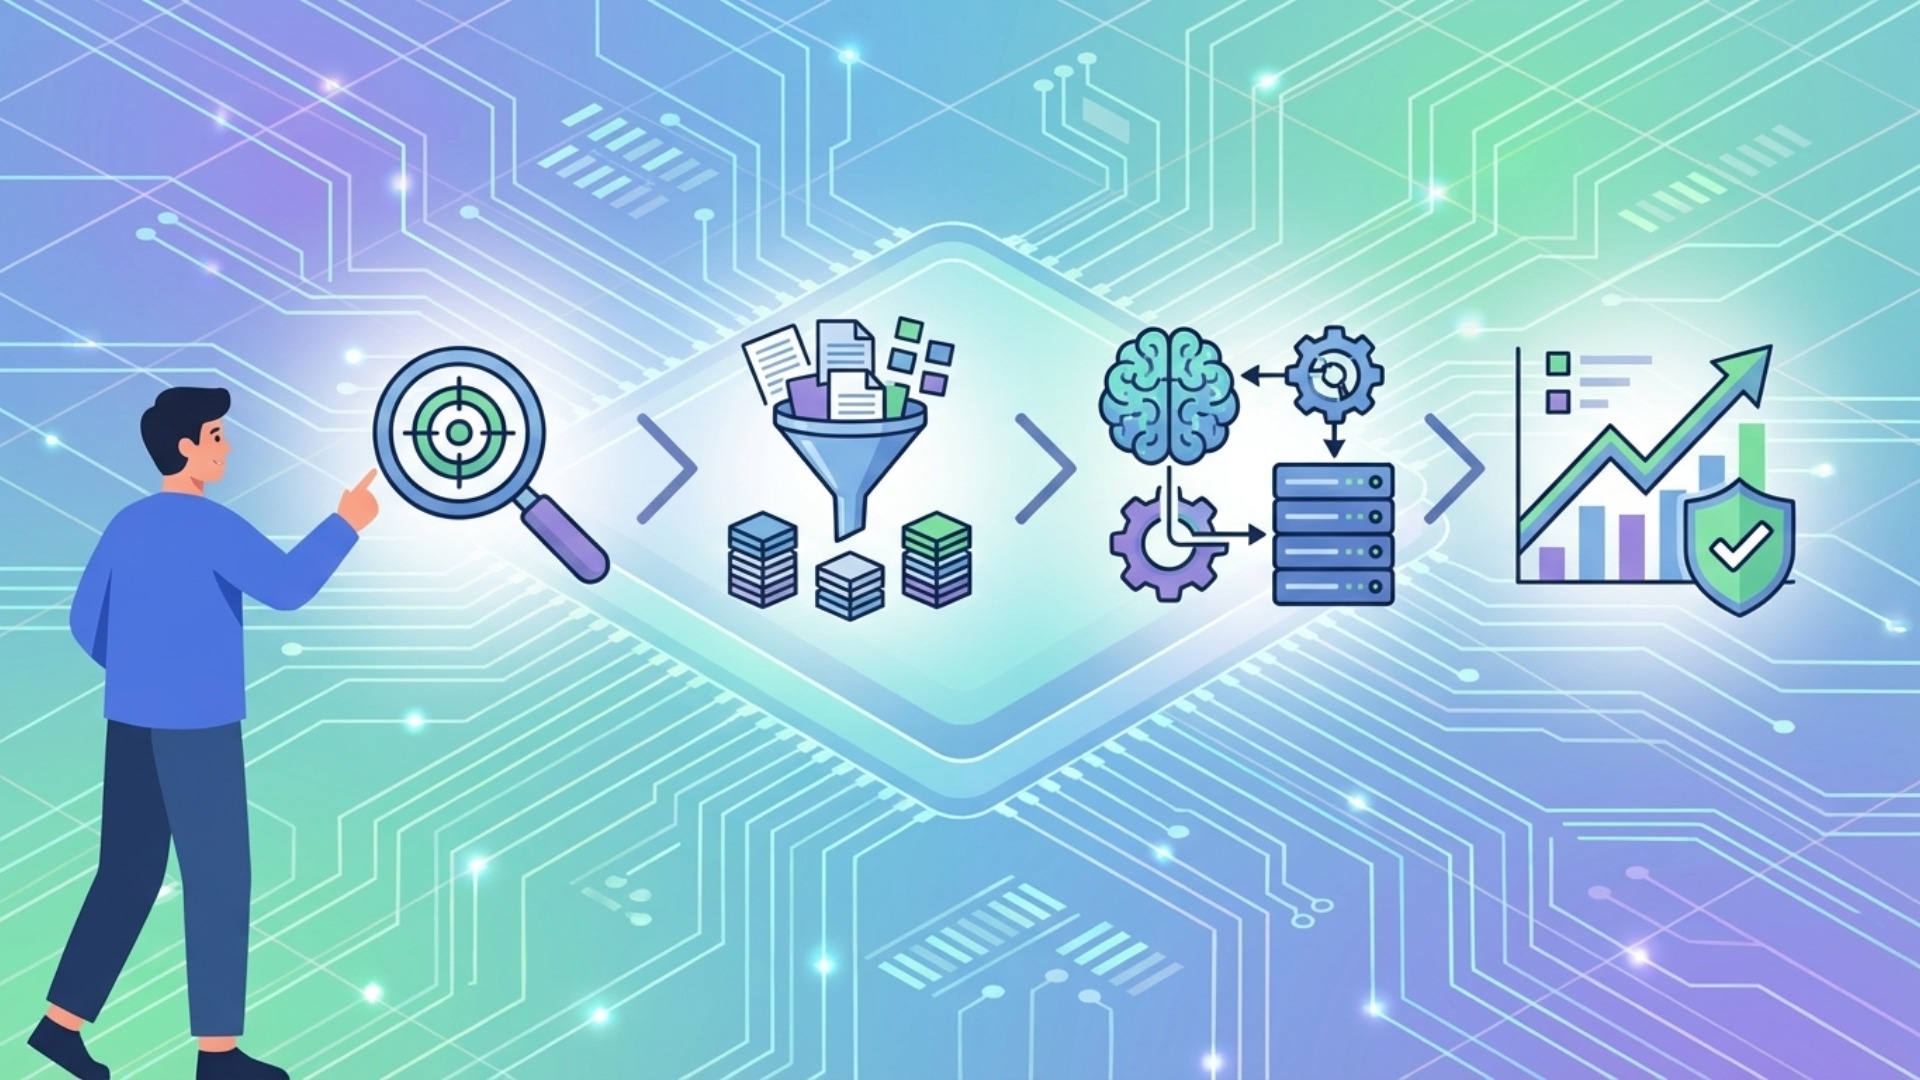
導入は、目的と評価基準の設定、データの準備、学習、評価という流れで進めます。学習前の基準値を取り、学習に使わない検証データで改善と副作用を比べられるようにします。
ここでは、ファインチューニングを実践するための具体的な手順を、ステップごとに解説していきます。
ステップ1・2:目的設定と高品質なデータセットの準備
最初のステップは、ファインチューニングによって「何を達成したいのか」を具体的に定義することです。例えば、「カスタマーサポートの一次回答を自動化する」「特定の文体でブログ記事の草案を生成する」など、目的を明確にすることで、必要なデータの種類や量が決まります。
学習データは提供元の指定形式で準備します。OpenAIのSFTでは、1行に1つのJSONを置くJSONLと、messages配列による会話形式が案内されています。以下は形式を示す架空の例で、実際の納期ではありません。(参考:OpenAI公式データ形式)
{"messages":[{"role":"user","content":"製品Aの納期は?"},{"role":"assistant","content":"通常3営業日です。"}]}
利用許諾、個人情報・機密情報の扱い、保存・削除条件を確認したうえで、誤りや重複を修正します。学習用と評価用を分け、提供元・モデルごとの最新の形式要件を確認してください。
ステップ3・4:トレーニングの実行とモデルの評価
対応モデル・利用資格を確認したサービス、または利用条件を満たす自社環境で学習します。OpenAIの提供範囲には制限があるため、下記の対応状況も確認してください。クラウドに送るデータについては、二次利用、保存期間、処理地域、アクセス権などの契約条件を確認します。
学習プロセスでは、学習率やエポック数(データセットを繰り返し学習する回数)などの「ハイパーパラメータ」を調整し、最適な性能を目指します。学習が完了した後は、最後のステップとしてモデルの評価を行います。事前に用意しておいたテスト用のデータセットを入力し、期待通りの応答が返ってくるか、精度は十分か、倫理的に問題のある回答をしないかなどを多角的に検証します。この評価結果に基づき、必要であればデータセットやハイパーパラメータを調整し、再度トレーニングを行うサイクルを繰り返します。
LLMファインチューニングの注意点とよくある失敗例
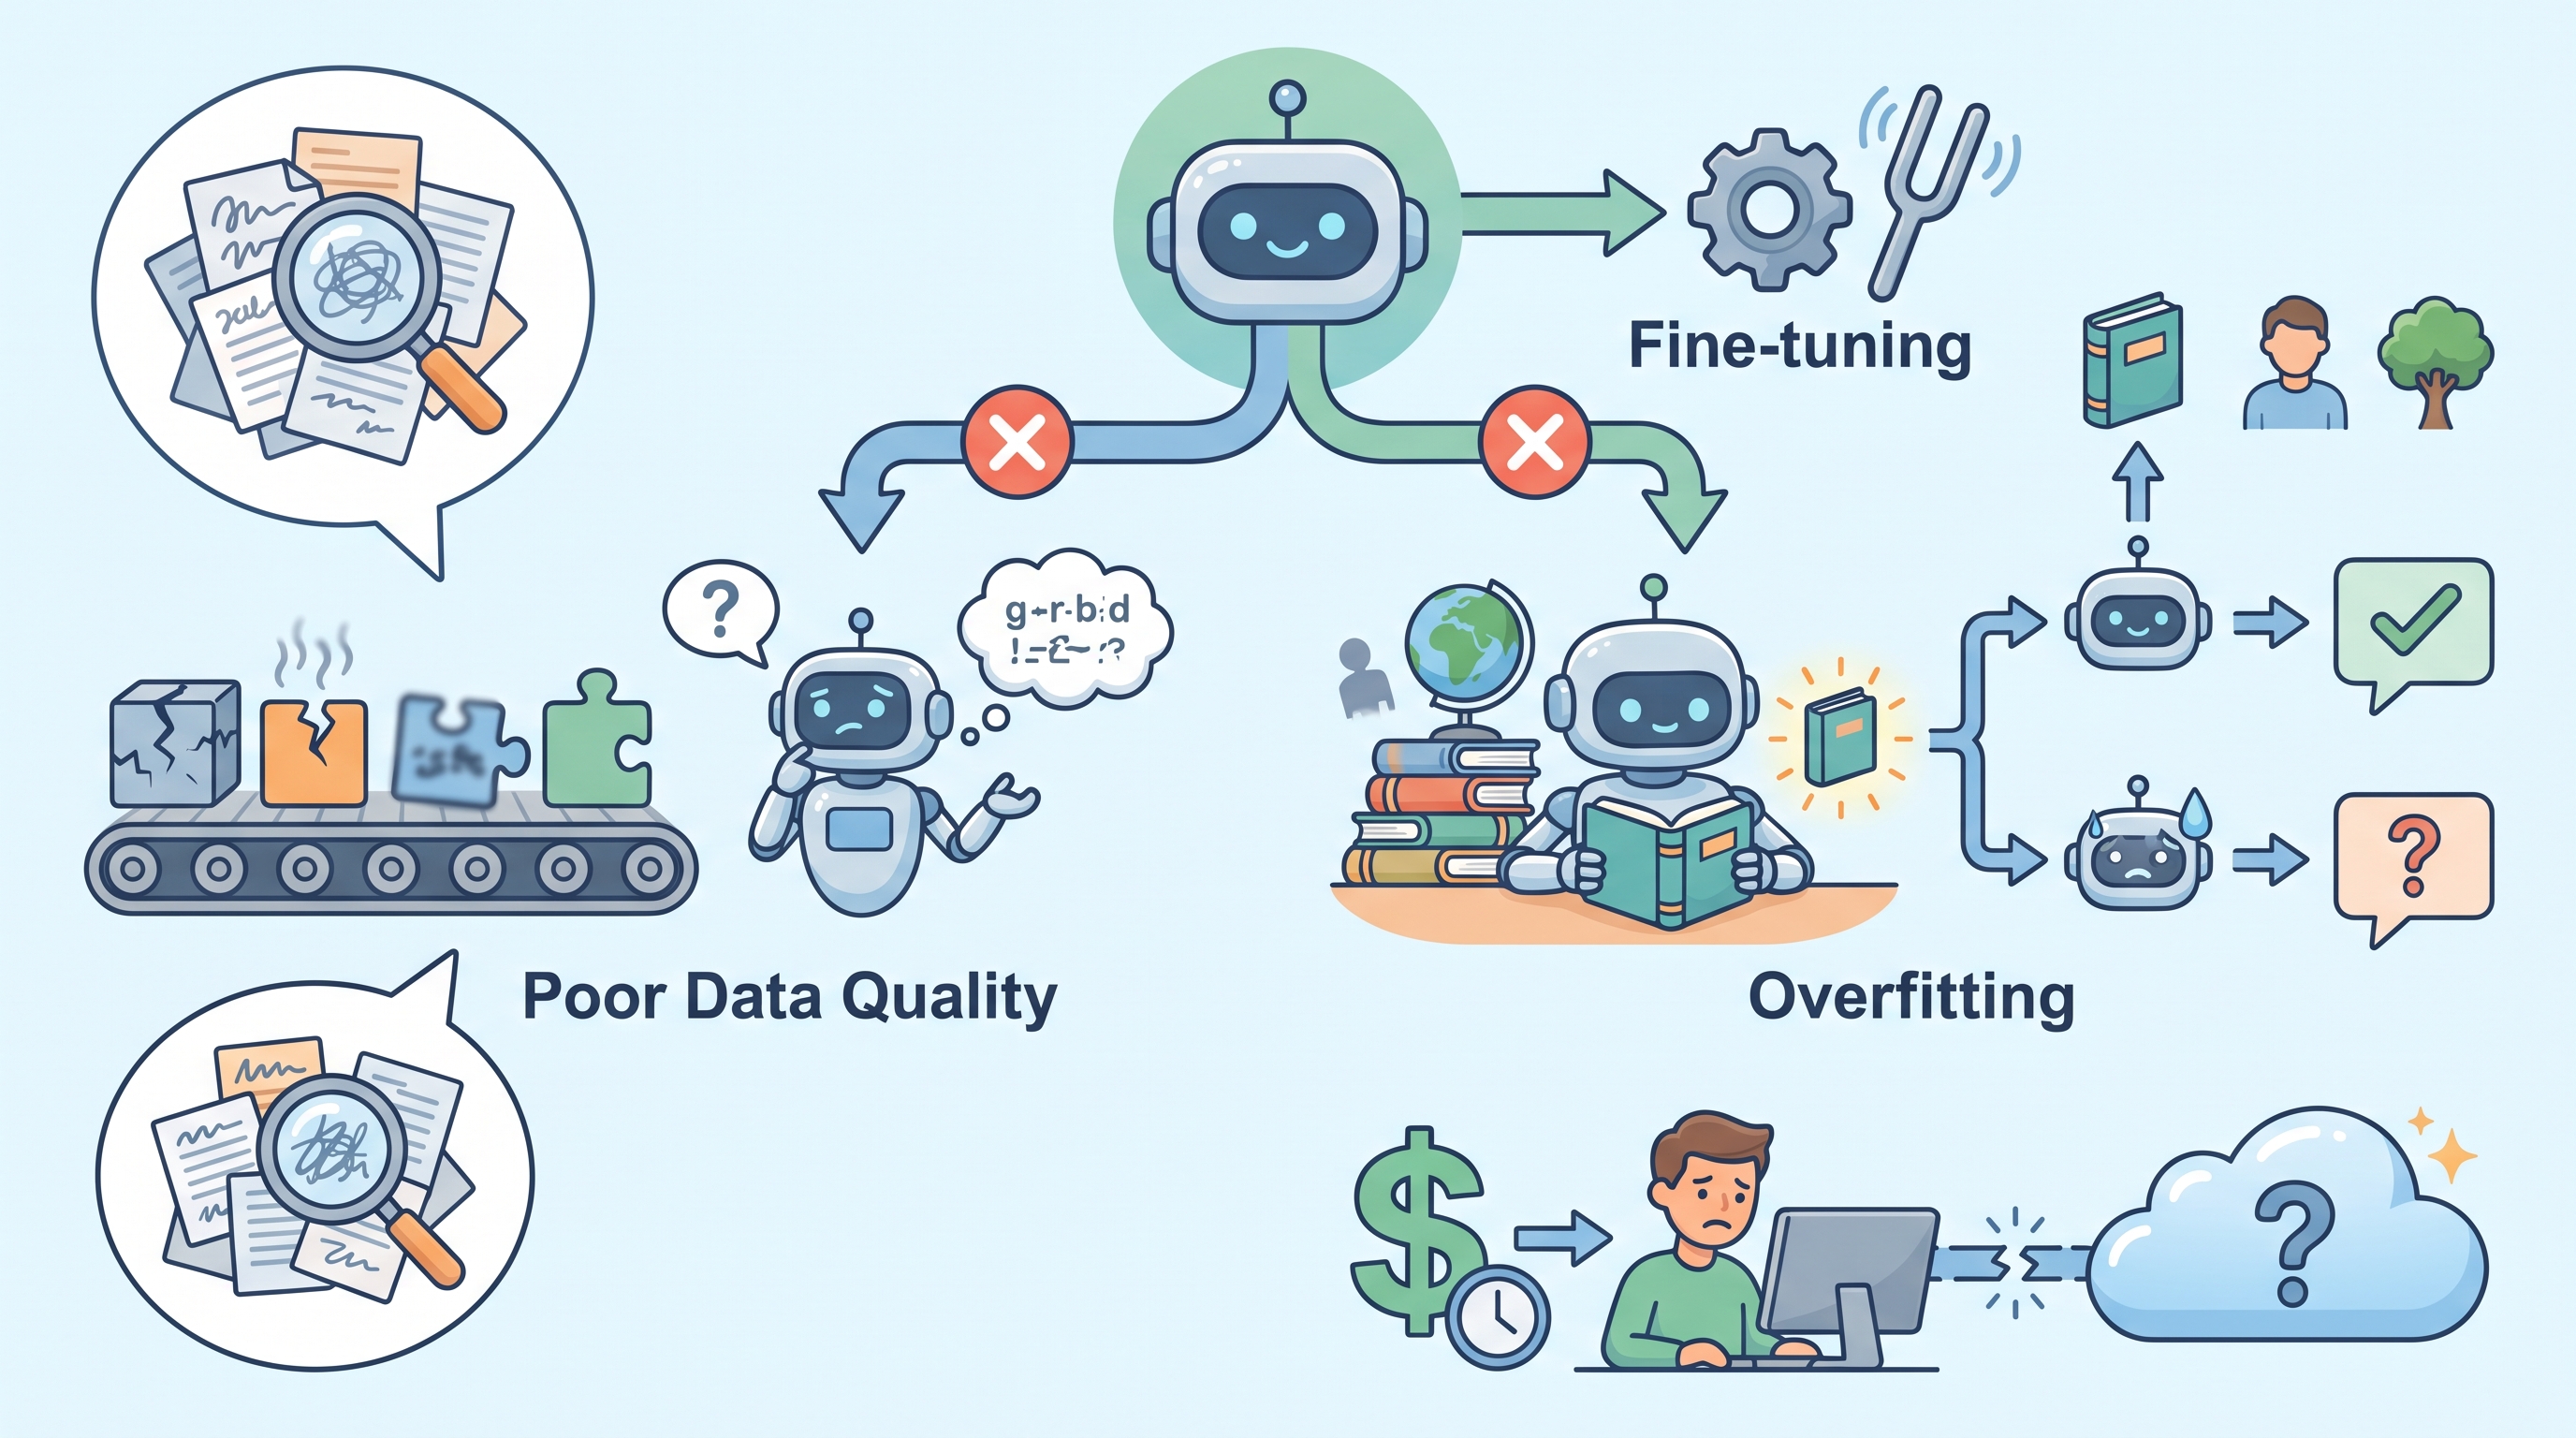
LLMファインチューニングは、モデルを特定のタスクに特化させる強力な手法です。しかし、いくつかの注意点を軽視すると、時間やコストをかけたにもかかわらず、期待した性能向上に繋がらないケースが少なくありません。特に、学習データの品質不足や過学習(Overfitting)は、よくある失敗例の代表格と言えます。
具体的には、以下のような失敗が挙げられます。
- データの質の低さ:目的とズレたデータや、誤字脱字が多いデータセットを使うと、モデルの性能は向上しません。最悪の場合、ファインチューニング前より精度が低下することもあります。
- 過学習:学習データへの適合が強くなり、未知の入力への性能が低下する状態です。学習に使わないデータで確認し、学習量やデータ構成を調整します。
- コストと目的の不一致:プロンプトや参照情報の改善だけで足りる課題に、追加学習を先に選ぶと、準備や運用の負担が増えることがあります。まず学習前の品質と費用を測定しましょう。
これらの失敗を避けるには、ファインチューニングが本当に必要なのかを見極めることが重要です。その上で、次のステップで解説する「目的の明確化」と、それに紐づく「高品質なデータ準備」が成功の鍵を握ります。
主要サービスの追加学習対応と費用の確認ポイント【2026年10月確認】
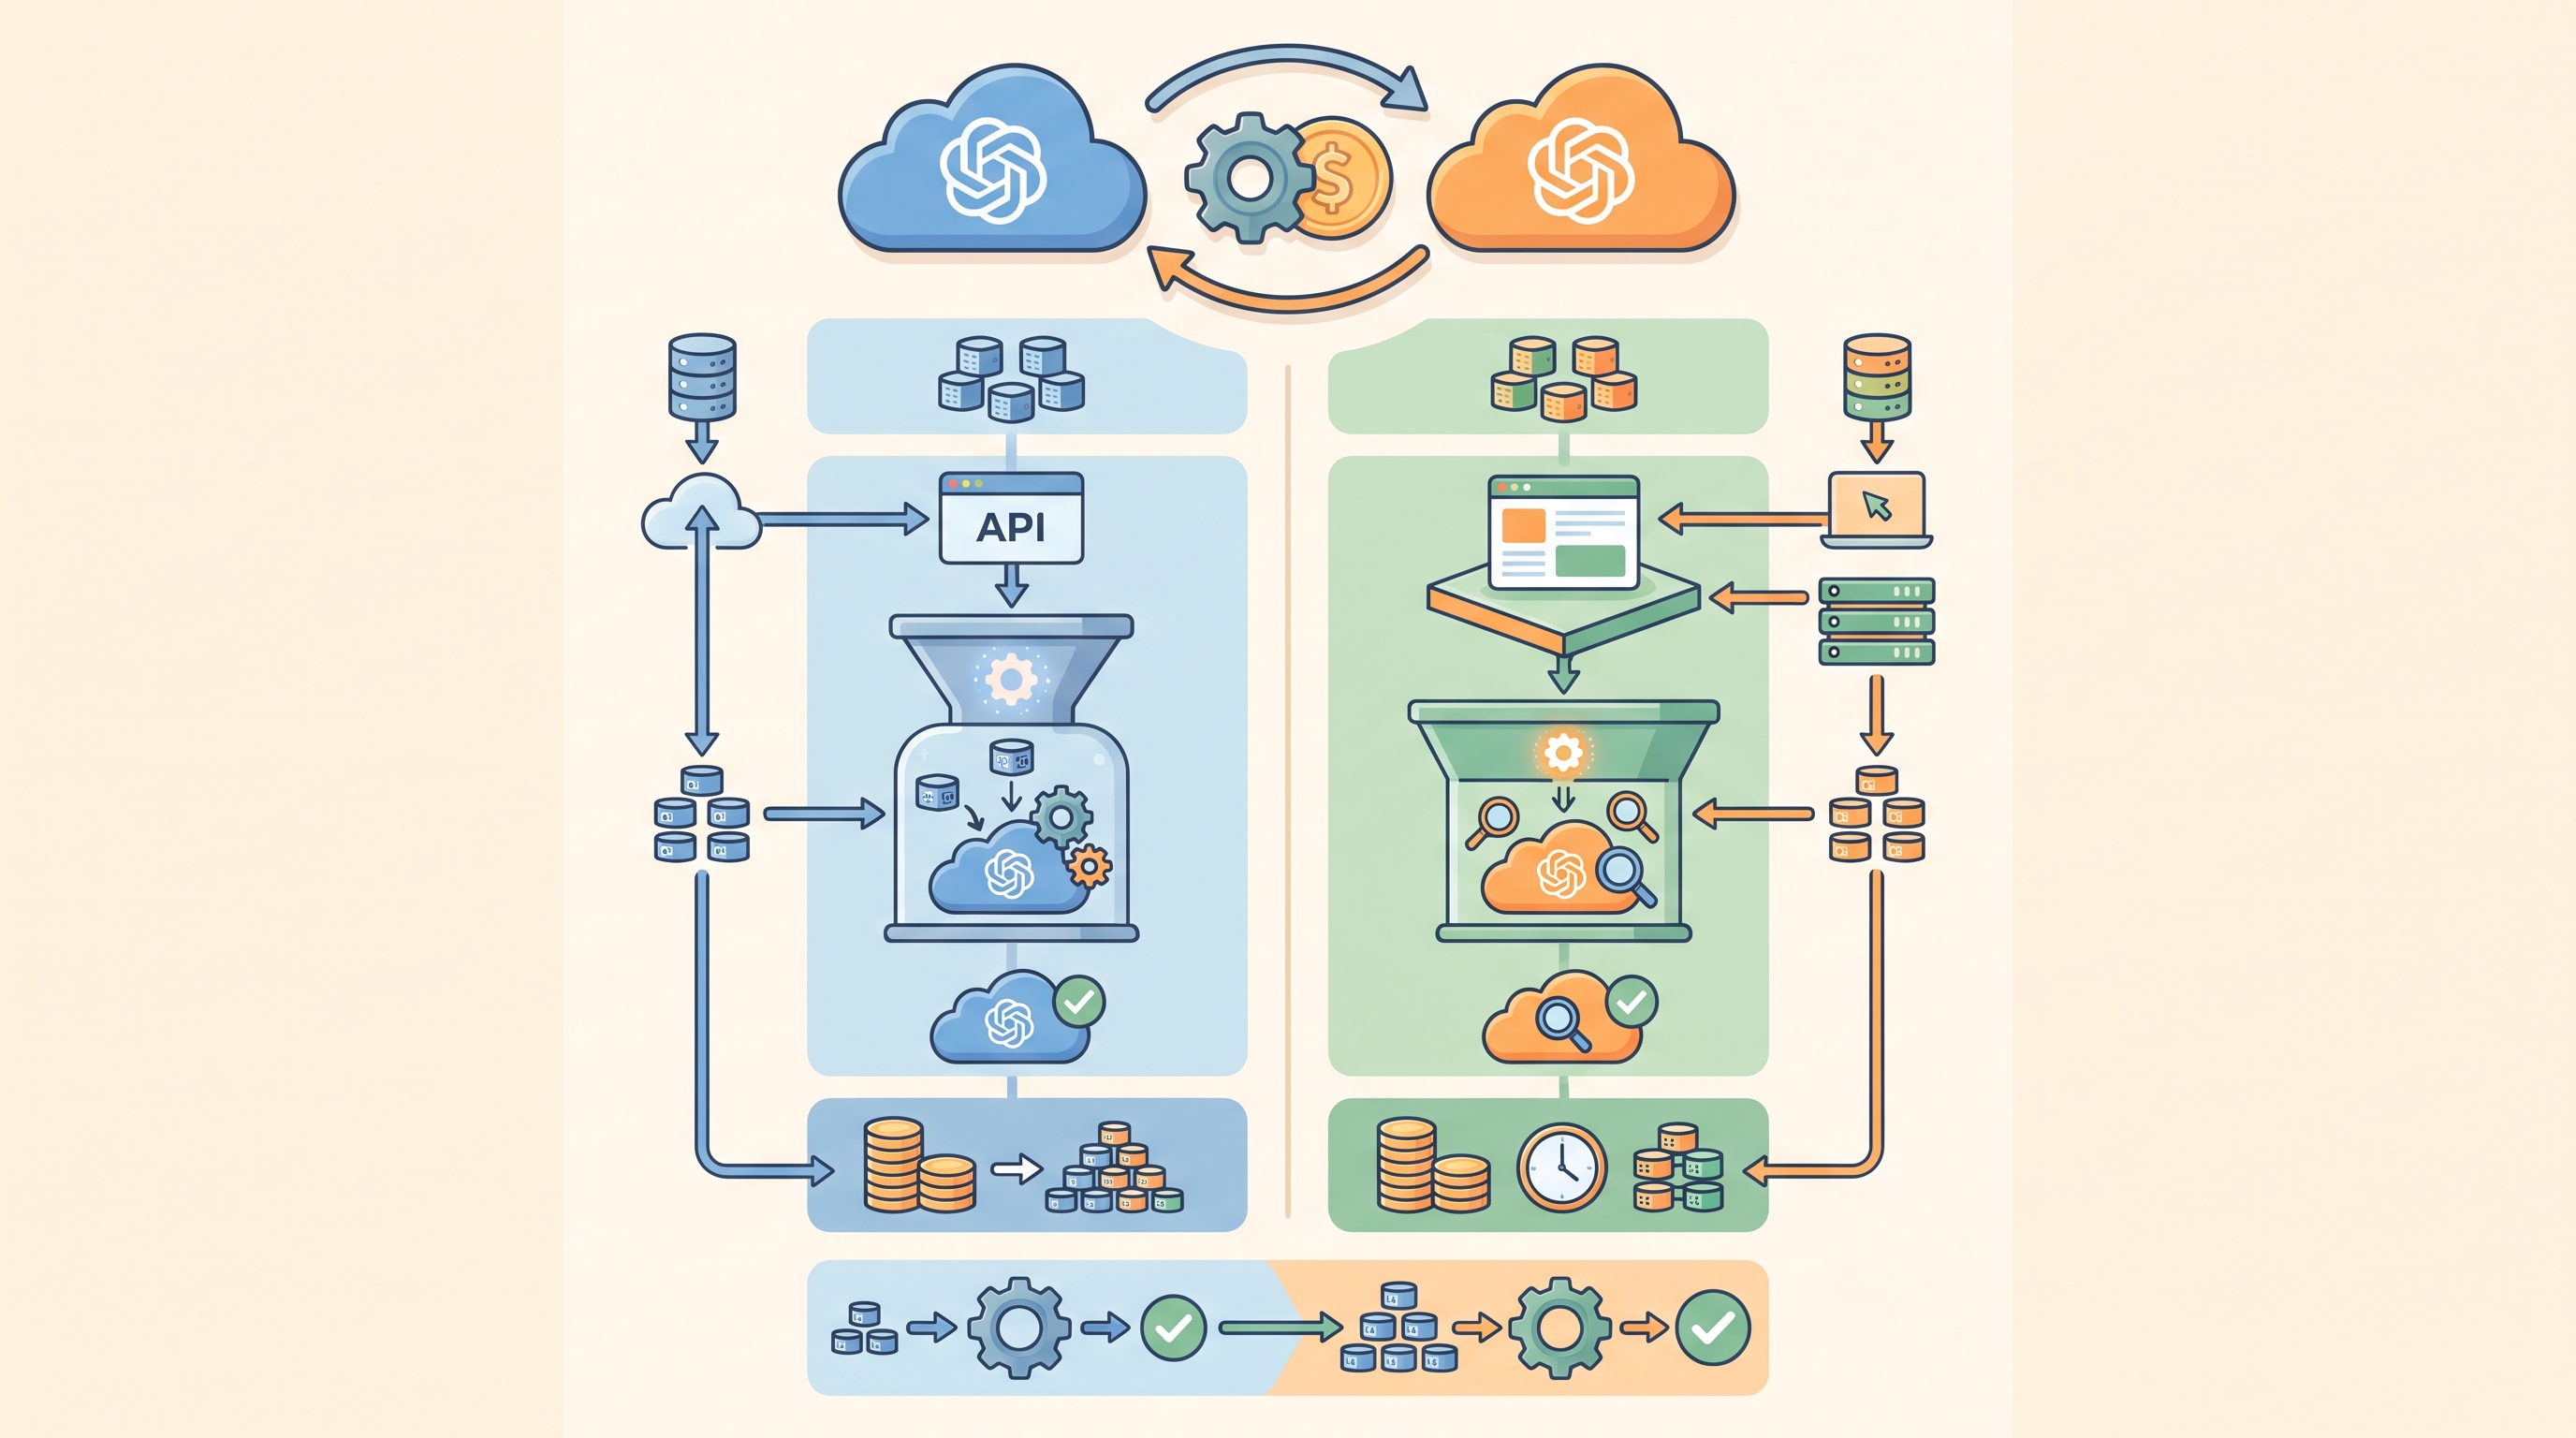
推論で利用できるモデルと、追加学習に対応するモデルは異なります。以下は2026年10月25日に公式資料を確認した内容です。契約・リージョン・モデルID・提供期限を、実行前に再確認してください。
対応モデルの新しさだけでなく、利用資格・終了日・移行方法と総費用を比較します。
- OpenAI:ファインチューニング基盤を縮小中で、新規利用者は利用できません。対象となる既存顧客は原則2027年1月6日まで学習ジョブを作成できますが、ベースモデルが先に終了する場合はその期限が優先されます。GPT-4.1 nanoの対象スナップショットは2026年10月23日に終了済みです。GPT-5系の推論提供を追加学習対応と読み替えないでください。(出典:公式SFT提供状況)
- Google:Gemini API/Google AI Studioには、現在追加学習できるモデルがありません。Google CloudのGemini Enterprise Agent Platformは別の提供枠で、公式対応一覧にはGemini 3.5 Flash、3.5 Flash-Lite、3.1 Flash-Liteや一部の2.5系などが掲載されています。3.6 FlashやDeep Thinkがそのまま学習できるという意味ではありません。(出典:Gemini APIの案内、Google Cloud対応一覧)
費用はモデル、学習方式、データ量、学習回数、推論量などで変わります。学習料金だけでなくデータ整備・評価・保存・推論・移行の費用も見積もり、公式価格表と契約条件を確認してください。本記事では一律の単価や最安サービスは断定しません。
LLMのビジネス活用ならAX CAMPのAI研修へ
LLMファインチューニングは自社専用AIを開発する強力な手段ですが、実行には高品質なデータの準備や専門知識、適切なコスト管理が不可欠です。「何から手をつければ良いかわからない」「推進できる人材がいない」といった課題に直面する企業は少なくありません。
AX CAMPでは業務課題を整理し、生成AI活用の進め方を学ぶ支援を提供しています。以下は公開インタビューで紹介された業務改善の例で、ファインチューニングを実装した実績と確認できたものではありません。数値は各社の申告で、再現を保証しません。
- グラシズ様:LP1本あたり約10万円のライティング外注費を削減、制作時間3営業日から2時間と2025年9月に報告。月額費用や総AI費用ゼロを意味しません。(出典:原取材)
- Route66様:従来の原稿執筆は最大24時間、短くても3時間、AI出力は10秒と2025年8月に報告。準備・編集・確認を含む総制作時間ではありません。(出典:原取材)
- C社様:テキスト系SNS運用の稼働を1日3〜4時間から1時間に短縮、月間1,000万インプレッションと2025年8月に報告。表示回数は売上ではありません。(出典:原取材)
- WISDOM様:2025年の採用見直しの話に続き、2026年4月の取材では広告運用の半自動化などを報告。代表者の判断・承認や土日対応が残っており、採用2名分の完全代替とは確認できません。(出典:続報の原取材)
本記事で解説したような高度な技術を使いこなすには、まず組織全体のAIリテラシー向上が欠かせません。AX CAMPでは、役員層から現場担当者まで、それぞれの階層に必要な知識とスキルを体系的に学ぶことができます。実践的なカリキュラムを通じて、自社でAIプロジェクトを主導できる人材を育成し、PoC(概念実証)で終わらない、本当に業務を変革するAI活用を実現しませんか。
「自社に最適なAIの活用法が知りたい」「失敗のリスクを最小限に抑えたい」とお考えでしたら、まずは無料の資料請求から、どのような支援が可能かご確認ください。

法人向けAI研修
AX CAMP 無料資料
LLMのファインチューニングに関するよくある質問(FAQ)
1. LLMのファインチューニングでよくある失敗例と注意点は何ですか?
LLMのファインチューニングにおける主な失敗例は3つあります。①特定のタスクに特化しすぎて元の知識を失う「破滅的忘却」。 ②学習データに過剰適合し、未知のデータに対応できなくなる「過学習」。 ③学習データの偏りにより、モデルの応答に意図しないバイアスが生じること。 これらを避けるには、質の高い多様なデータセットを準備し、学習率などの設定を慎重に調整することが重要です。
2. OpenAI APIを使ったファインチューニングの具体的な手順と料金は?
まず利用資格とモデルの終了日を確認してください。2026年10月25日現在、OpenAIのファインチューニングは新規利用者には提供されていません。対象の既存利用者は、指定JSONLの準備、アップロード、学習、未学習データでの評価という流れです。料金は対象モデルの学習・推論条件に従い、GPT-5.4の推論料金を学習料金として使うことはできません。(出典:公式SFTガイド)
3. ファインチューニングとRAG(検索拡張生成)はどう使い分ければ良いですか?
文体・分類・出力傾向を改善したい場合は追加学習、更新する文書を参照したい場合はRAGを検討し、併用もできます。どちらも正確性を保証しません。まずプロンプトと少数例で基準を取り、目的の品質・費用・更新負荷を比較しましょう。
まとめ:LLMファインチューニングで自社専用AIを実現しよう
本記事では、LLMファインチューニングの基本概念からメリット・デメリット、具体的な手順、そしてRAGなどの他手法との違いについて詳しく解説しました。最後に、重要なポイントを改めて振り返ります。
- ファインチューニングはLLMを特定タスクに特化させる追加学習技術である
- メリットは高精度化と業務への最適化、デメリットはコストと専門知識の要求
- 「振る舞い」を変えるのがファインチューニング、「知識」を参照するのがRAG
- 成功の鍵は「目的設定」と「高品質なデータセット」の準備にある
ファインチューニングを正しく理解し活用することで、汎用的なLLMを自社の強力な業務パートナーへと進化させることが可能です。応答品質の安定化やプロンプトの簡略化は、日々の業務効率を大きく改善する可能性を秘めています。
もちろん、こうした専門的な取り組みを自社だけで進めるのは容易ではありません。もし、より実践的な知識の習得や、専門家のサポートを受けながらプロジェクトを推進したいとお考えであれば、AX CAMPがお力になります。貴社の課題に合わせた最適なAI導入プランをご提案し、成果創出に向けて伴走します(※効果は個別の状況により異なります)。AIを活用してビジネスを次のステージへ進めるために、ぜひ一度ご相談ください。
法人向けAI研修
AX CAMP 無料資料
