自社に最適な大規模言語モデル(LLM)の選定に悩んでいませんか。2026年10月18日に確認した公式情報では、GPT-6.1 Sol、Claude Opus 5.5、Gemini 4 Argonなどが現行の比較候補です。用途、料金、提供条件を揃えて比較することが大切です。
「どのモデルが自社の課題解決に最も貢献するのか」を見極めるのはますます難しくなっています。性能や料金だけでなく、それぞれのモデルが持つ得意分野を理解せずに導入すると、期待した成果が得られない可能性さえあります。
この記事では、2026年10月18日時点の公式情報を基に、主要LLMの仕様、API料金、業務別の選び方を比較します。公開ベンチマークと自社業務の評価を区別し、データ保護や移行時の互換性も確認します。AX CAMPの支援を検討する場合は、現在のサービス資料で対象と提供内容をご確認ください。
法人向けAI研修
AX CAMP 無料資料
2026年10月の主要LLM:現行モデルと提供形態
LLMを比較する際は、モデル名だけでなく、固定バージョン、一般提供かプレビューか、APIとチャットアプリの違いを確認しましょう。後継モデルが登場していても旧モデルが利用できる場合があり、「利用可能」と「現在の推奨候補」は同じ意味ではありません。
本記事ではOpenAI、Anthropic、Googleの代表的なAPIモデルを比較します。特定の会社が文章作成、安全性、最新情報の収集で常に優れるとは限りません。同じ資料と指示を用い、出力の正確さ、応答時間、総費用で評価してください。
自社環境で動かせる公開重みのモデルも選択肢です。ただし、重みが公開されていることと、制限のないオープンソースであることは同義ではありません。Llamaなどはモデルごとのライセンスと利用条件を確認し、必要なGPU、運用要員、保守費用も比較しましょう。
【2026年10月18日確認】主要LLMの仕様・API料金比較表
以下は各社の直接提供APIにおける代表的な現行モデルの比較です。コンテキスト上限は処理可能なトークン数の枠であり、全文を常に正しく理解できる保証ではありません。API料金とChatGPTなどのアプリの月額料金は別です。
この表を活用し、自社の予算や想定するタスク(一度に処理したい情報量など)と照らし合わせながら、どのモデルが候補となり得るかを見極めましょう。
| モデル系統 | 開発元 | コンテキスト上限/最大出力 | 標準API料金(入力/出力、各100万トークン) | 主な特徴 |
|---|---|---|---|---|
| GPT-6.1 Sol | OpenAI | 1,050,000/128,000トークン | $2/$10(入力272K以下) | テキスト・画像入力、テキスト出力。性能と費用のバランスを重視する用途の候補。 |
| Claude Opus 5.5 | Anthropic | 1M/128Kトークン | $4/$20 | テキスト・画像入力、テキスト出力。長時間のコード作業や知識業務向け。適応的思考は常時有効。 |
| Gemini 4 Argon | 入出力合計1,048,576/通常出力65,536トークン | $2/$10(2026年11月30日まで) | テキスト・画像・動画・音声・PDF入力、テキスト出力。検索連携はツール設定が必要。 |
※USD建て標準料金。キャッシュ、Batch、優先処理、検索などの追加料金は含みません。GPT-6.1 Solは入力が272Kを超えると入力単価が2倍、出力単価が1.5倍になります。Gemini 4 Argonは2026年12月1日から入力$4/出力$20へ変更予定です。長い出力を使う場合は別の実行方式と上限条件を確認してください。(出典:OpenAI仕様、料金、Anthropic仕様・料金、Google仕様、料金)
表の仕様だけで総合的な優劣は決まりません。OpenAIは複雑な課題向けにGPT-6 Astraも案内し、Anthropicはさらに難しい推論でClaude Fable 5.1を候補にしています。Googleにも速度を重視するGemini 3.8 Flashがあります。高いモデルへ一律に切り替えず、必要な精度と待ち時間、入力・出力・ツールを含む総費用で絞り込みましょう。
このように、各モデルのスペックと料金を比較することで、自社の要件に合ったLLMの候補を絞り込めます。次のステップとして、それぞれのモデルが持つ具体的な強みを詳しく見ていきましょう。
法人向けAI研修
AX CAMP 無料資料
主要商用LLMを徹底比較!GPT・Claude・Geminiの強み
各シリーズには複数の価格帯とモデルがあります。ここでは現行の代表例と注意点を説明します。用途への適性は提供元の説明だけで決めず、自社の評価データで確認する必要があります。
OpenAI:GPT-6.1 Solを起点に性能と費用を比較
GPT-6.1 Solは、OpenAIが性能と費用のバランスを重視する候補として案内する現行モデルです。より複雑な課題ではGPT-6 Astraも比較対象になります。GPT-5.4は利用可能ですが現行の最新候補とは区別します。既存システムの移行では、モデルIDだけでなく、対応ツール、パラメーター、応答形式、費用を確認して回帰評価してください。(出典:公式モデル一覧、廃止情報)
既存のAPI連携や社内の運用経験がある場合は、その資産を使えるかも選定基準になります。ただし、関連情報の多さだけで導入の容易さや低コストを保証できません。出力トークン数、再実行、検索やツールの費用を含めて試算しましょう。
Anthropic:Claude Opus 5.5の長文・コード作業と移行条件
Claude Opus 5.5は2026年9月22日公開の現行モデルで、1Mトークンのコンテキストと通常128Kの最大出力に対応します。長いコード作業や資料処理の候補ですが、長文の読み落としや誤答はあり得ます。Claude Opus 4.7は2026年4月16日公開の旧世代で、現行モデルとは区別します。(出典:公式仕様、リリースノート)
安全性を重視した設計であっても、医療・法律・金融の判断を自動的に任せられるわけではありません。専門家の確認と用途ごとの検証が必要です。また、Opus 5.5では思考を無効化できず、強制的なツール選択など旧設定がエラーになる場合があります。既存連携は公式移行ガイドで確認してください。
Google:Gemini 4 Argonのマルチモーダル入力と検索連携
Gemini 4 Argonは2026年10月13日に一般提供された推論モデルです。テキスト、画像、動画、音声、PDFを入力できますが、出力はテキストで、画像生成には対応しません。他社モデルにも画像入力などの対応があるため、Geminiだけがマルチモーダルという比較は適切ではありません。(出典:公式仕様、リリース情報)
Google検索によるグラウンディングは、対応ツールを設定した場合の機能です。モデル単体が常に最新情報を参照するわけではなく、回答の出典と更新日を確認する必要があります。Gemini 3.1 Proはプレビュー版として区別します。4 Argonへ移行する場合は、明示的キャッシュ非対応、統合コンテキスト枠、出力上限や思考設定の変更を確認してください。(出典:変更点と移行チェックリスト)
公開重みのLLMと商用API:費用・ライセンス・運用の違い
公開重みのモデルは、ライセンスが許す範囲で自社環境への配置や追加学習を検討できます。自社で推論する場合に外部APIの従量料金が不要でも、GPU、電力、保守、セキュリティ対応の費用はかかります。同じモデルを外部のホスティングAPIで使えば利用料が発生することもあります。
1. Meta「Llamaシリーズ」:汎用性とカスタマイズ性の高さ
LlamaはMetaが重みを公開しているモデル群です。Llama 4などは独自のCommunity Licenseと利用ポリシーが適用されるため、無制限なオープンソースと一括りにしないでください。自社配置でもログ、外部通信、アクセス権限の管理が必要です。特定モデルの必要メモリは重み、量子化、同時実行数によって異なります。(出典:公式モデル一覧、Llama 4ライセンス)
2. Mistral AI:モデルごとの公開形態とライセンスを確認
Mistral AIは小型モデルから大規模モデルまで提供しています。例えばSmall 4はApache 2.0、Medium 3.5はModified MITであり、すべて同じ条件ではありません。Large 4は2026年10月6日公開のPublic Previewで、発表時点では重み公開予定とされています。導入時は現物の配布状況とライセンスを確認してください。(出典:公式モデル一覧、変更履歴、ライフサイクル)
3. DeepSeek:V3.2の過去の評価と現在の提供モデルを区別
2025年12月公開のDeepSeek V3.2について、提供元は当時GPT-5級、V3.2-SpecialeはGemini 3.0 Proと競う評価を報告しています。GPT-5.4やGemini 3.1 Proとの比較結果ではありません。V3.2の公開重みはMITライセンスですが、Specialeの一時APIは2025年12月15日までの提供でした。現在の公式APIにはDeepSeek-V4.1-Flash-1017など後継があるため、過去の評価と現行APIを区別してください。(出典:当時の発表、公開重みとライセンス、現行リリース)
法人向けAI研修
AX CAMP 無料資料
LLMベンチマークの見方と業務での評価方法
LLMの性能を客観的に比較する際、ベンチマークスコアは重要な指標ですが、その数値を鵜呑みにせず、あくまで参考情報として捉えることが肝心です。ベンチマークは、モデルの特定の能力を測定するために設計されたテストセットであり、必ずしも総合的な実用性を示すものではないからです。引用する際は、テスト名・実施日・スコア・出典を明記することが求められます。
LLMの評価でよく用いられる代表的なベンチマークには、以下のようなものがあります。
- MMLU (Massive Multitask Language Understanding): 高校レベルから専門家レベルまでの幅広い分野の知識を測る指標。
- HumanEval: Pythonのコーディング能力を評価する指標。
- GPQA:生物・物理・化学の専門家が作成した難しい選択式問題による評価。専門外の人がWeb検索を使っても解きにくい設計であり、「専門家は検索なしでは答えられない」という意味ではありません。(出典:GPQA原論文)
- SWE-bench: 実際のGitHubリポジトリの問題を解決できるかを測る、より実践的なコーディング能力の指標。
各社が公表するスコアは、モデル版、推論の設定、ツール使用、試行回数、評価用ハーネスが異なることがあります。同名のベンチマークでも条件が違えば直接比較できません。同じ条件の根拠を確認できない場合は、順位や総合的な優劣を断定しないでください。
したがって、ベンチマークスコアは初期のモデル選定における参考情報とし、最終的には自社の具体的な業務内容に即したテスト(PoC: 概念実証)を行い、実際の使い勝手や業務への適合性を評価することが最も重要です。スコアの高さが、必ずしも自社の課題解決に直結するとは限らない点を念頭に置いておきましょう。
ビジネス用途別!最適なLLMの選び方
LLMの選定で最も重要なのは、「どのモデルが総合的に優れているか」ではなく、「自社が解決したい特定のタスクに対して、どのモデルが最も適しているか」という視点を持つことです。各モデルの強みを理解し、ビジネス上の具体的な用途と結びつけることで、導入効果を最大化できます。ここでは、代表的な3つのビジネス用途別に、最適なLLMの選び方を解説します。
文章作成:指定した文体と事実の正確さで比較
文章作成では、GPT-6.1 Solなどを候補に、同じ素材と指示で比較します。「親しみやすい口調」「専門家向け」などの文体への追従、出典の扱い、修正にかかる時間を評価しましょう。自然な文章であっても事実が正しいとは限らないため、公開前の確認は必要です。
社内ナレッジ検索・要約:長文の正確さと参照権限で比較
Claude Opus 5.5など長い入力を扱えるモデルは、社内資料の要約や調査の候補です。ただし、文書が枠内に収まることと、必要箇所を漏れなく抽出できることは別です。原文への参照、回答に使ってよい資料の権限、検索の仕組みを整え、正答と引用箇所が一致するか検証しましょう。
データ分析・市場調査:検索と出典確認の仕組みで比較
市場調査では、Gemini 4 Argonなどの対応モデルと検索ツールを組み合わせる方法があります。検索機能を有効にし、引用先の公開日と本文が主張を裏付けるかを確認してください。非公開情報や取得できないSNS投稿まで参照できるわけではありません。チャットアプリの機能名とAPIモデルの仕様も区別しましょう。
法人向けAI研修
AX CAMP 無料資料
LLM導入前に確認したい性能・コスト・セキュリティ
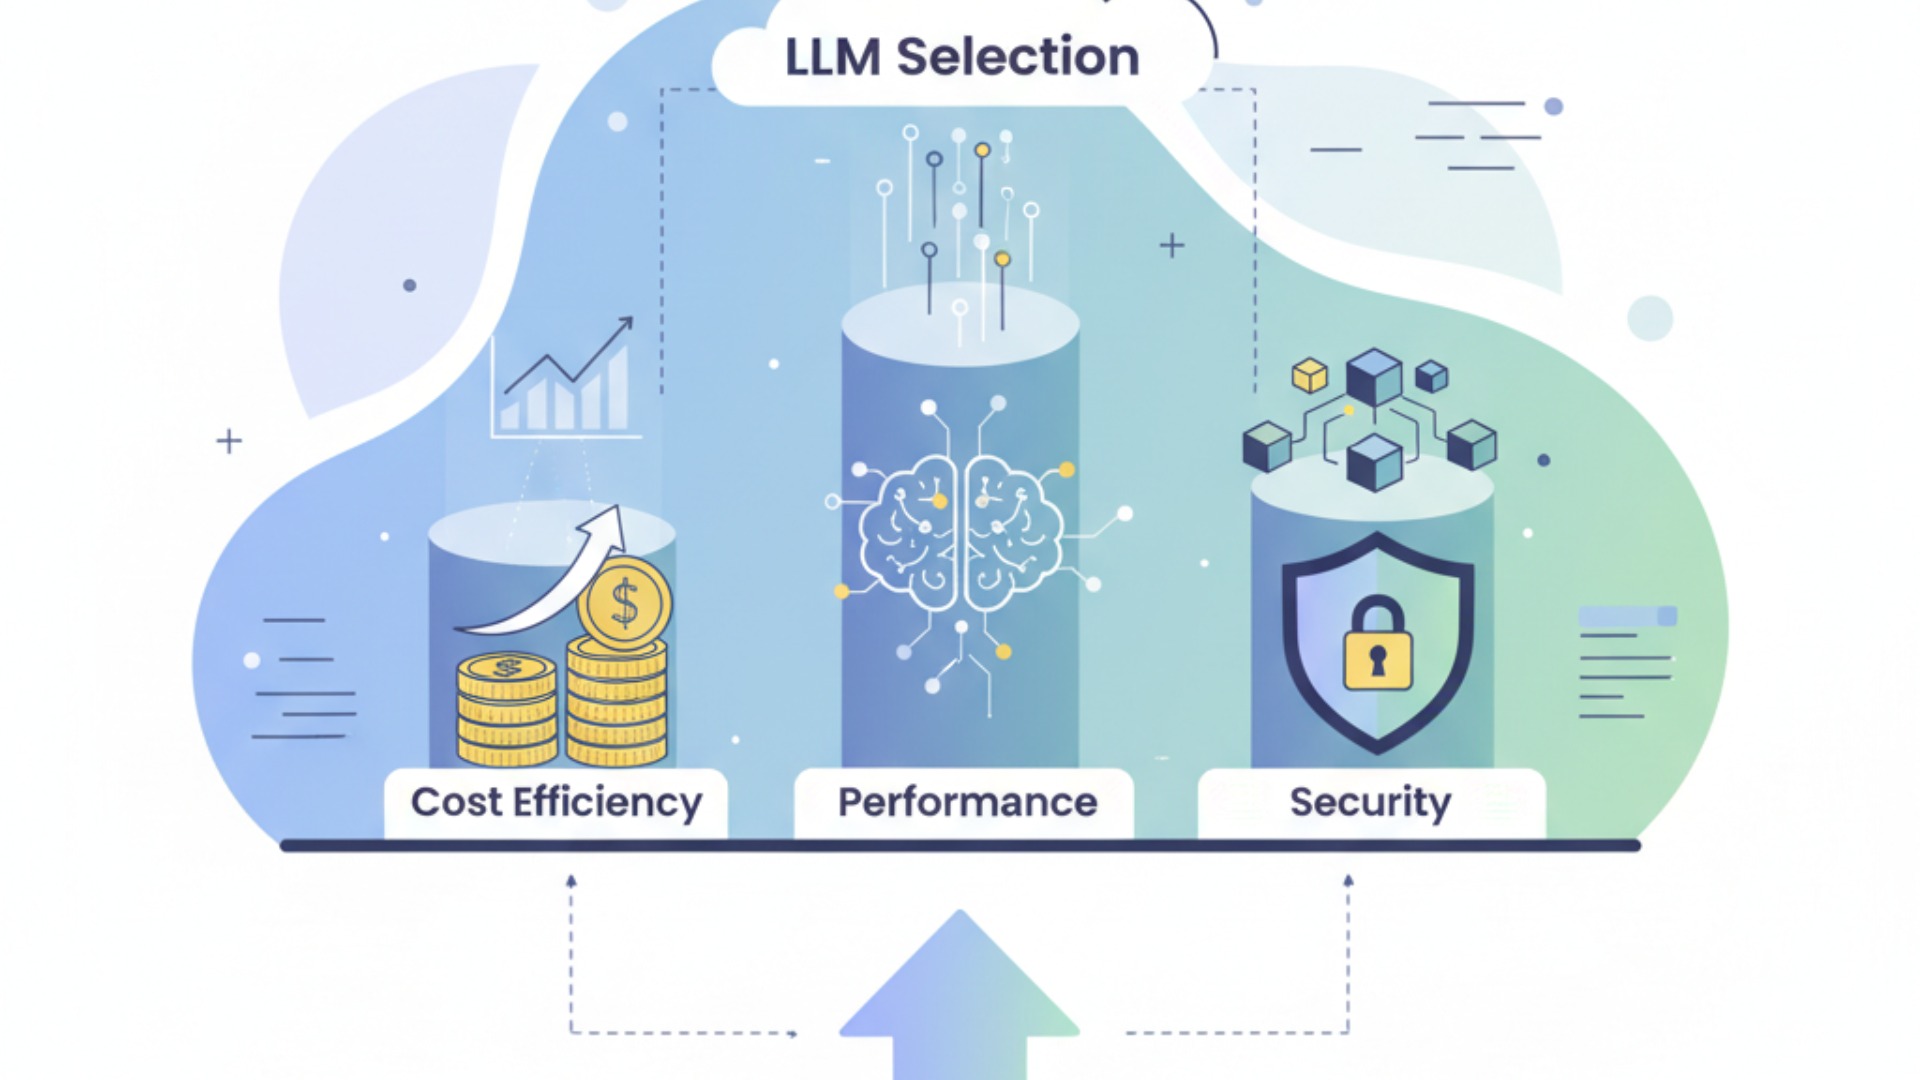
LLMの導入で失敗を避けるためには、性能の比較だけでなく、コスト効率とセキュリティというビジネスの根幹に関わる要素を総合的に評価することが不可欠です。どんなに高性能なモデルでも、予算を大幅に超えたり、情報漏洩のリスクを管理できなかったりすれば、ビジネスに貢献することはできません。ここでは、LLM選定において必ず押さえるべき3つの比較ポイントを解説します。
性能と精度:タスク要件を満たすか
性能は、公開ベンチマークだけでなく、自社の具体的なタスクで評価します。問い合わせ返信なら、利用が許可された匿名化サンプルを使い、事実の正確さ、文体、誤答時の処理、手直し時間を確認します。実際の顧客メールを無断で外部APIへ送らないでください。
コスト効率:API利用料と運用コストのバランス
総費用には、APIの入力・出力・ツール料金のほか、開発、監視、障害対応、評価の工数も含めます。公開重みを自社で動かす場合も、計算資源と運用費が必要です。外部のホスティングAPIは公開モデルでも有料の場合があります。同じ業務量で月額費用を試算しましょう。
セキュリティと導入基盤:データの安全性をどう確保するか
LLMの利用において、セキュリティは最も重要な検討事項の一つです。特に、顧客情報や社内の機密情報を扱う場合、データがどのように管理され、情報漏洩のリスクがどの程度あるのかを厳密に評価しなければなりません。入力したデータがAIの学習に使われないか、ベンダーのセキュリティポリシーを詳細に確認する必要があります。具体的には、以下の項目をチェックリストとして活用することをお勧めします。
- データの収集目的、保存場所、保存期間
- 入力データのAI学習への利用の可否(オプトアウトの可否)
- データの再販・第三者共有の有無
- ISO/IEC 27001の認証やSOC 2報告書など、第三者による評価の対象範囲と有効期間
- 契約上の保証(DPA: データ処理契約の締結可否など)
Azure OpenAIやVertex AIなどのクラウド基盤では、プライベート接続やアクセス制御を検討できます。ただし、利用する機能、契約、地域、設定によって条件が異なり、契約しただけで閉域化されるわけではありません。自社配置も含め、情報セキュリティ担当者が通信経路、保持期間、ログ、権限を確認してください。(出典:Azureのネットワーク設定)
開発現場のリアルな声とLLMの使い分け術
モデルの比較と業務改善の成果は分けて評価しましょう。以下はAXが公開した顧客インタビューの紹介です。特定の最新モデルの優位性を証明する比較実験ではなく、当時のツールと業務設計による個社の説明です。
Route66様の事例
2025年8月公開のRoute66社インタビューでは、従来3〜24時間かかった原稿執筆に対し、AI出力は10秒と説明しています。画像準備や挿入・装飾を含む制作全体が10秒という意味ではありません。公開記事からGPT系モデルによる成果とは特定できないため、モデルの優位性の根拠にはしません。(出典:Route66社インタビュー)
WISDOM合同会社様の事例
WISDOM社の公開インタビューでは、GASによる管理シートの自動生成などを紹介しています。一方、日程調整の自動化は取材時点で今後の実装と効果見込みの説明です。「採用予定2名分を実際に代替済み」といった実績に置き換えず、実装済みの取り組みと計画を分けて読む必要があります。(出典:WISDOM社インタビュー)
エムスタイルジャパン様の事例
2025年9月公開のエムスタイルジャパン社インタビューでは、GASで通話履歴と処理内容を集約し、月16時間ほどの確認工数と、全社で月100時間以上の業務を削減したと担当者が説明しています。個社の自己申告であり、独立した計測ログや特定のLLM版による効果は確認していません。(出典:エムスタイルジャパン社インタビュー)
法人向けAI研修
AX CAMP 無料資料
LLM活用で検討したいAIエージェント化と業務への適合
現行モデルには、外部ツールと組み合わせて複数段階の作業を進めるものがあります。導入ではモデル単体の性能だけでなく、実行権限、失敗時の扱い、監視と費用を設計する必要があります。将来の普及や成果を確定した事実として扱わないことが大切です。
AIエージェントは、目標に沿って計画し、検索やアプリ操作などのツールを使う仕組みです。例えば出張手配なら、候補検索と予約確定を分け、購入前の承認、予算、取消条件、誤操作時の復旧を設けます。単に指示するだけで全工程が正しく完了するとは限りません。
業界に合わせる方法には、プロンプトの調整、参照資料を検索するRAG、追加学習などがあります。追加学習すれば必ず精度が上がるわけではありません。まず誤りの原因と必要な知識を見極め、専門家の確認を含む評価で方法を選びましょう。
LLMのビジネス活用を実践的に学ぶならAX CAMP
ここまで様々なLLMを比較してきましたが、理論上の性能を理解することと、それを自社の業務に落とし込み、具体的な成果に繋げることの間には大きな隔たりがあります。最適なモデルを選定できたとしても、効果的なプロンプトの設計方法や、既存システムとの連携、社内での活用を推進する体制がなければ、宝の持ち腐れになってしまいます。
自社だけでLLMの導入・活用を進めることに不安を感じる企業担当者の方も多いのではないでしょうか。どの部署のどの業務からAI活用を始めるべきか、費用対効果をどのように測定すればよいか、そして従業員のリテラシーをどう向上させるかなど、検討すべき課題は山積みです。
AXは法人向けのAI研修・活用支援を提供しています。公式案内では従来のAX CAMPの新規申込受付は2026年4月20日に終了し、現在の法人向け支援を案内しています。過去の顧客事例と現在の契約内容は同一とは限りません。対象業務、研修、伴走支援の範囲を現行の公式案内で確認し、必要に応じて相談してください。成果は業務や運用体制により異なります。

法人向けAI研修
AX CAMP 無料資料
LLMを比較する際のよくある質問
LLMの導入を検討する企業担当者から寄せられる、よくある質問とその回答をまとめました。モデル選定や運用に関する疑問を解消し、よりスムーズな導入計画の策定にお役立てください。
無料で使える高性能なLLMはありますか?
重みが無償公開されたモデルはありますが、ライセンスと実行費用の確認が必要です。Llamaの独自条件、Mistralのモデル別条件などを確認してください。自社で推論すれば外部APIへの従量料金を避けられる場合でも、GPUや保守は無償になりません。アプリの無料枠とAPIの無料枠も別です。
LLMを導入する際のセキュリティリスクは何ですか?
主なリスクには、機密情報の漏洩、誤った回答、プロンプトインジェクション、連携ツールの過剰な権限による誤操作があります。入力の学習利用や保持はサービス、プラン、設定、契約により異なります。承認済みのデータだけを使い、権限を必要最小限にし、重要な判断や外部への変更には人の確認を設けましょう。
日本語の精度が高いLLMはどう比較すればよいですか?
日本語の品質は業務ごとに比較します。同じ原文と指示で、敬語、固有名詞、要約の抜け、出典の正確さ、修正時間を評価してください。導入前に複数の候補を試し、自社の文体や専門用語に合うものを選びましょう。
国産モデルも、必要な日本語業務と運用条件に合うかを同じ評価で確認します。開発国だけで文化理解や性能の優劣は決まりません。自社の資料、許容できる誤り、費用、応答時間を揃えて比較しましょう。
まとめ:LLM比較のポイントを押さえ、自社に最適なモデルを選ぼう
本記事では2026年10月18日に確認したGPT-6.1 Sol、Claude Opus 5.5、Gemini 4 Argonなどの現行仕様と、LLMの選び方を説明しました。モデルの利用可能性と最新性、APIとアプリの違いを踏まえ、以下を確認してください。
- 用途の明確化:まず「何を解決したいのか」を定義し、それに合った強みを持つモデルを選ぶ。
- 総合的な評価:性能だけでなく、コストとセキュリティのバランスを必ず考慮する。
- 実機テストの実施:ベンチマークスコアは参考に留め、必ず自社の業務でPoCを行う。
- 使い分けの視点:単一のモデルに固執せず、タスクに応じて複数のモデルを使い分ける。
自社だけで選定や導入を進めにくい場合は、業務整理や評価設計を支援する専門家への相談も選択肢です。AXの支援を検討する場合は、現行資料で提供内容と対象を確認してください。支援の利用だけで成果が保証されるわけではなく、自社の業務、データ、運用体制に応じて検証を続ける必要があります。
法人向けAI研修
AX CAMP 無料資料
