「社内データをAIに読み込ませて業務効率化を図りたいが、どのようにデータ基盤を整えればよいかわからない」「生成AIの精度が上がらず困っている」という課題には、用途に応じたデータの整理と検索環境の整備が求められます。AIデータベース構築は、データ分析や業務自動化を推進する有効な選択肢となります。
AIデータベース構築では、既存データベースの活用や検索機能の拡張も含めて検討します。生成AIやRAG(検索拡張生成)が必要な社内情報を参照できるようにするため、本記事では構築の基本手順からサービスの選択肢、成功させるポイントまで詳しく解説します。
法人向けAI研修
AX CAMP 無料資料
AI活用においてデータベース構築が注目される背景
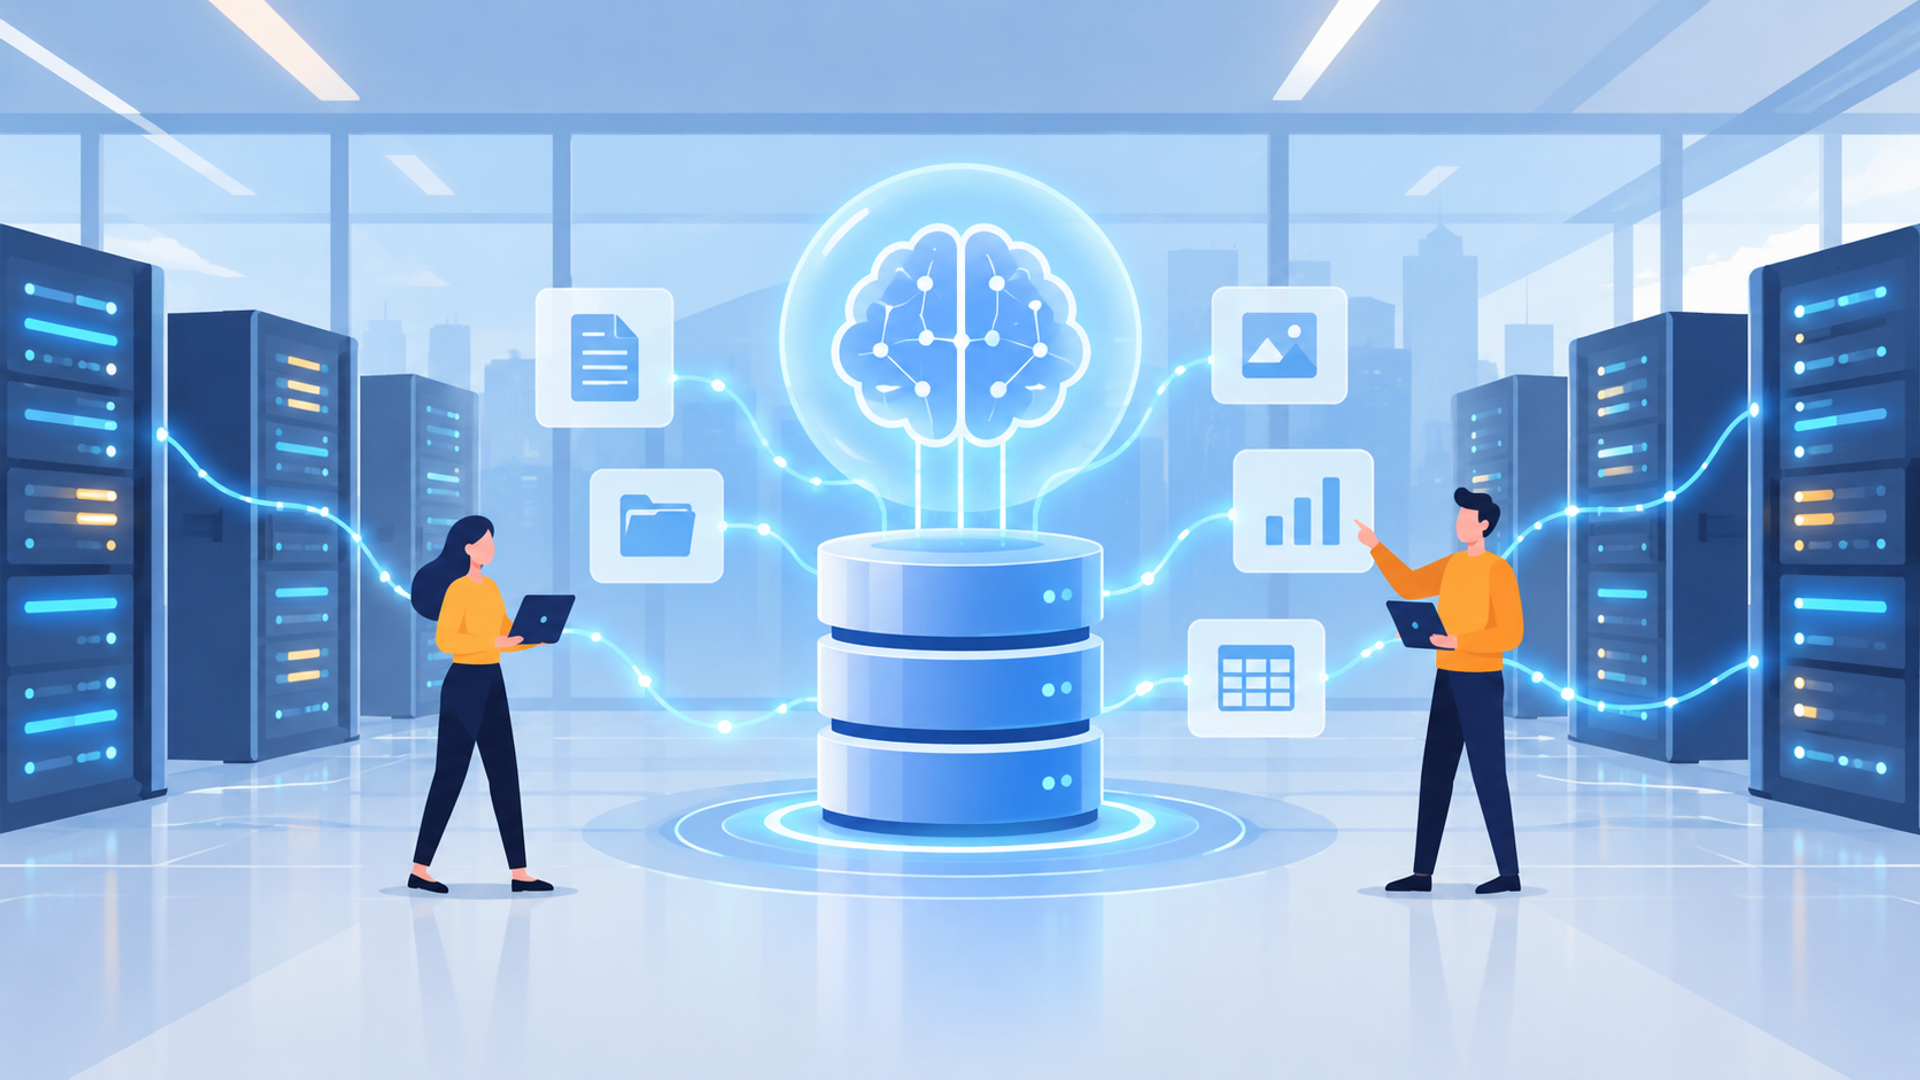
生成AIの社内活用で業務成果を出すには、用途に応じて社内データを整理し、AIが適切な情報を参照できる環境を整えなければなりません。AIデータベース構築においては既存のRDB(リレーショナルデータベース)も活用可能です。データの保存とAIによる解釈は異なる処理にあたるため、テキスト抽出や前処理、モデル連携の設計が進められます。意味検索が必要な場合には、既存RDBへのベクトル検索機能の追加や専用検索基盤の導入を検討してください。
2026年時点で社内AI活用を検討する際も、汎用的な大規模言語モデル(LLM)を導入するだけで自社固有の業務課題を解決できるとは限りません。自社のマニュアルや過去の顧客対応履歴といった社内資産をAIが効率よく検索・参照できる環境を作ることが、業務に合った活用につながります。
生成AIやRAGにおける回答精度の向上
RAG(検索拡張生成)の回答精度を高めるには、検索対象データの内容や分割方法、検索条件の最適化が欠かせません。誤回答(ハルシネーション)のリスクを抑えるため、必要な情報を的確に検索し、回答の根拠を確認できる仕組みを構築しましょう。なお、個人情報の扱いは個人情報保護委員会の生成AIサービス利用時の注意喚起、著作権は文化庁のAIと著作権に掲載された資料を踏まえて運用ルールを定めてください。
全文検索は語句の一致や関連度を利用する一方、ベクトル検索は埋め込みモデルが数値化した意味的な近さを活用します。表現が異なる関連文書を探す際に有効で、キーワード検索との併用も選択肢となります。検索結果を文脈情報(コンテキスト)としてLLMに渡せば、社内固有データに基づく回答生成を後押しします。ただし、検索結果や生成内容の正確性については個別に検証を行わなければなりません。
非構造化データの収集と統合的な利活用
企業データでは、非構造化データが80%以上を占めるとする概算もあります(IBMの技術資料)。割合は企業ごとに異なるものの、PDFやWord文書、画像、音声なども活用対象に入ります。既存RDBでもテキストやバイナリ、JSONなどを格納のうえ、全文検索の適用も対応しています(PostgreSQLのデータ型、全文検索の公式資料)。保存した情報をAIで活用するためには、用途に応じた抽出・前処理や検索機能との連携設計を進めます。
非構造化データから抽出したテキストや画像などを、対応するモデルで数値の配列である「ベクトルデータ」に変換(エンベディング)することで、意味的な類似性を活かした検索が実現します。複数の形式を横断して検索する場合は、モデルの対応範囲や形式ごとの前処理を事前に確認しましょう。元データや出典、アクセス権限もあわせて管理すれば、部署を越えたスムーズなナレッジ共有につながります。
主なデータベースの種類とAIとの相性
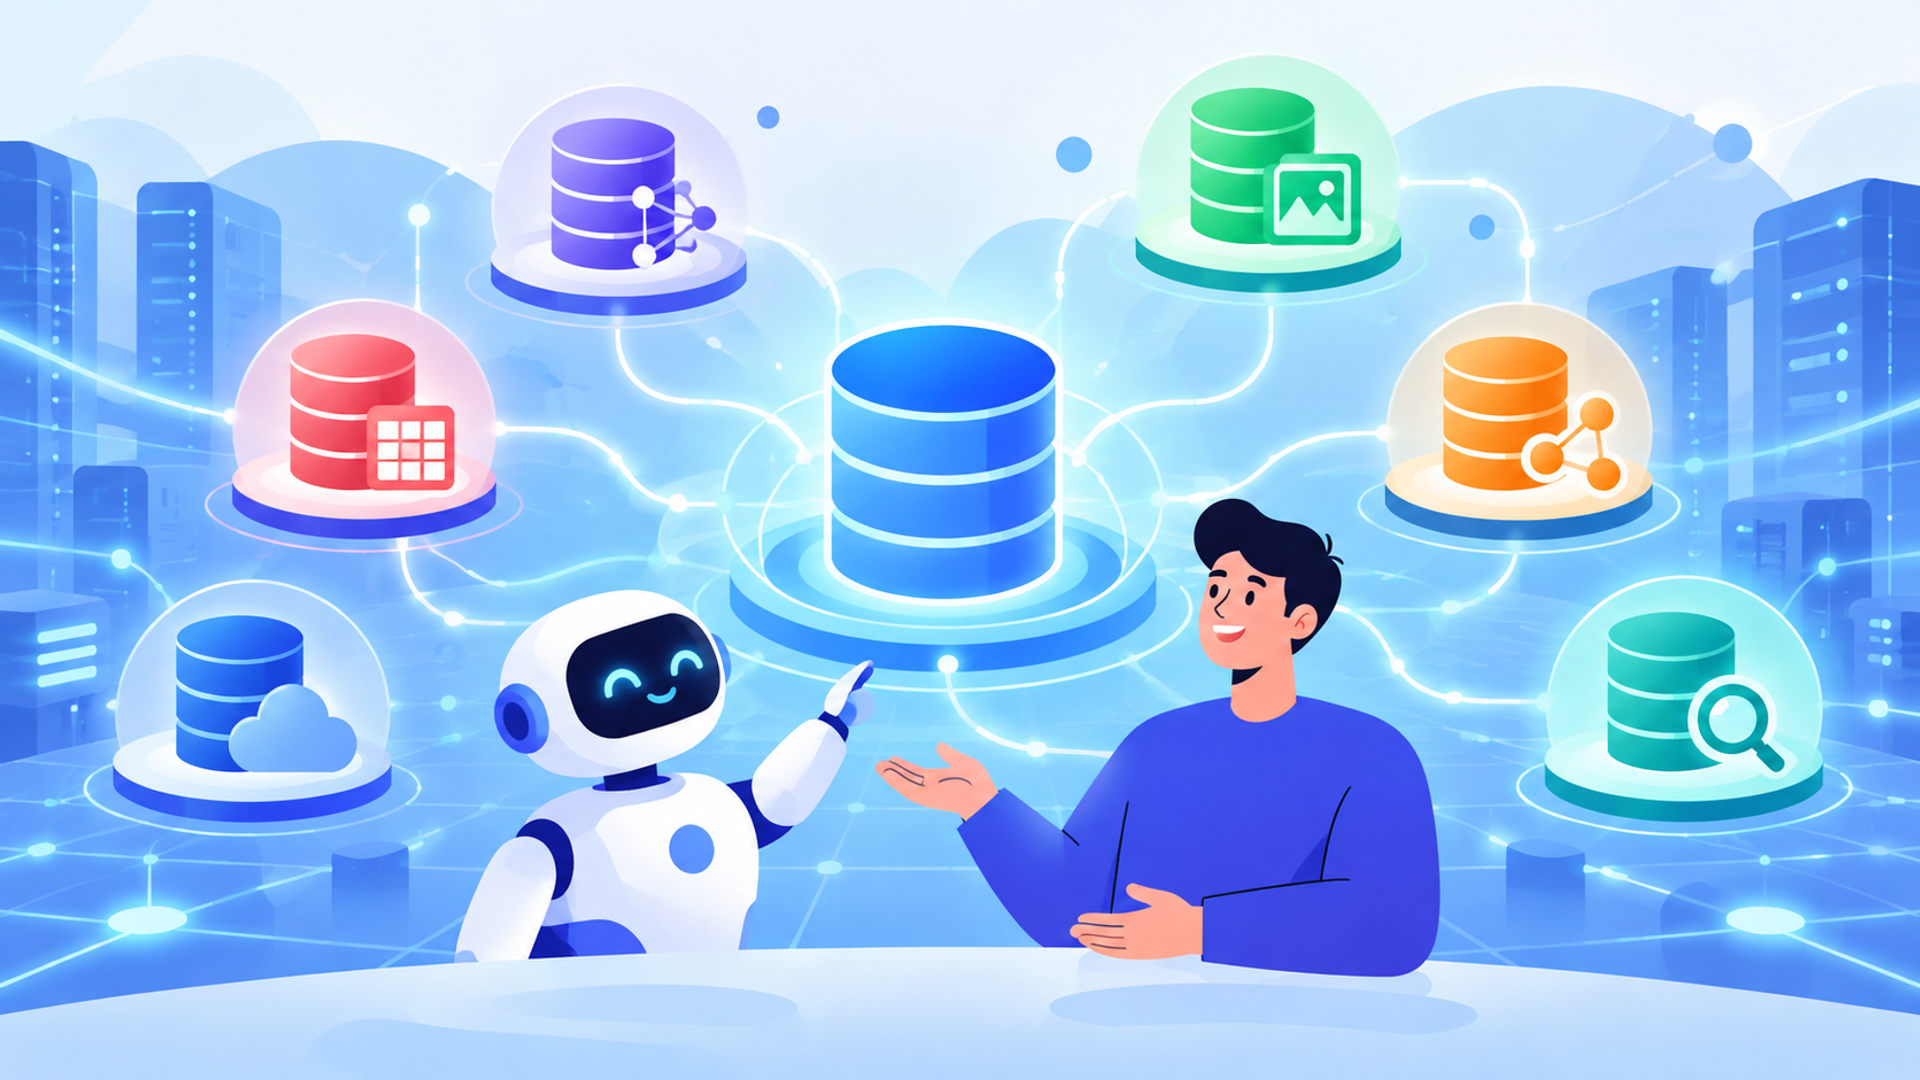
AIデータベース構築を進める際は、取り扱うデータの形式やシステム要件に適合する技術基盤の選定が成否を分けます。各データベースの特性によって得意・不得意の領域が異なるため、自社の利用目的に対応できるかを事前に評価しておきましょう。
従来のRDB(リレーショナルデータベース)にベクトル検索機能を拡張するアプローチも選択肢となりますが、用途によっては専用の検索エンジンやグラフ構造を活用した方が費用対効果が高くなる場合もあります。自社の活用目的に合わせて最適な基盤を見極めましょう。
ベクトルデータベース(Vector DB)
ベクトルデータベースは、高次元の数値データを類似性検索によって処理することに特化したデータベースです。文章や画像などの意味的な近さを計算して検索できるため、LLMと連携したRAGシステムの構築に利用されます。
非構造化データから生成したベクトルを使い、「意味や文脈が似ている情報」を探し出せる点が強みです。自然言語による問い合わせに対して関連文書を提示するシステムなどで力を発揮します。検索速度や関連性はデータ量、埋め込みモデル、検索条件、システム構成によって左右されるため、実際の業務データを用いた検証を推奨します。
グラフデータベース
グラフデータベースは、データそのものだけでなくデータ同士の「関係性」をノードとエッジの網状構造で管理する技術です。複雑に絡み合うナレッジグラフや、組織内の人間関係、部品の供給網などの表現に適しています。
専門用語の関連性や、特定の業務手順における前後関係を検索・参照させたい場面で役立ちます。ベクトル検索とグラフ検索を組み合わせ、関連情報とそのつながりを生成AIに渡す設計も選択肢となります。
法人向けAI研修
AX CAMP 無料資料
ビジネスにおけるAI×データベースの主な活用事例
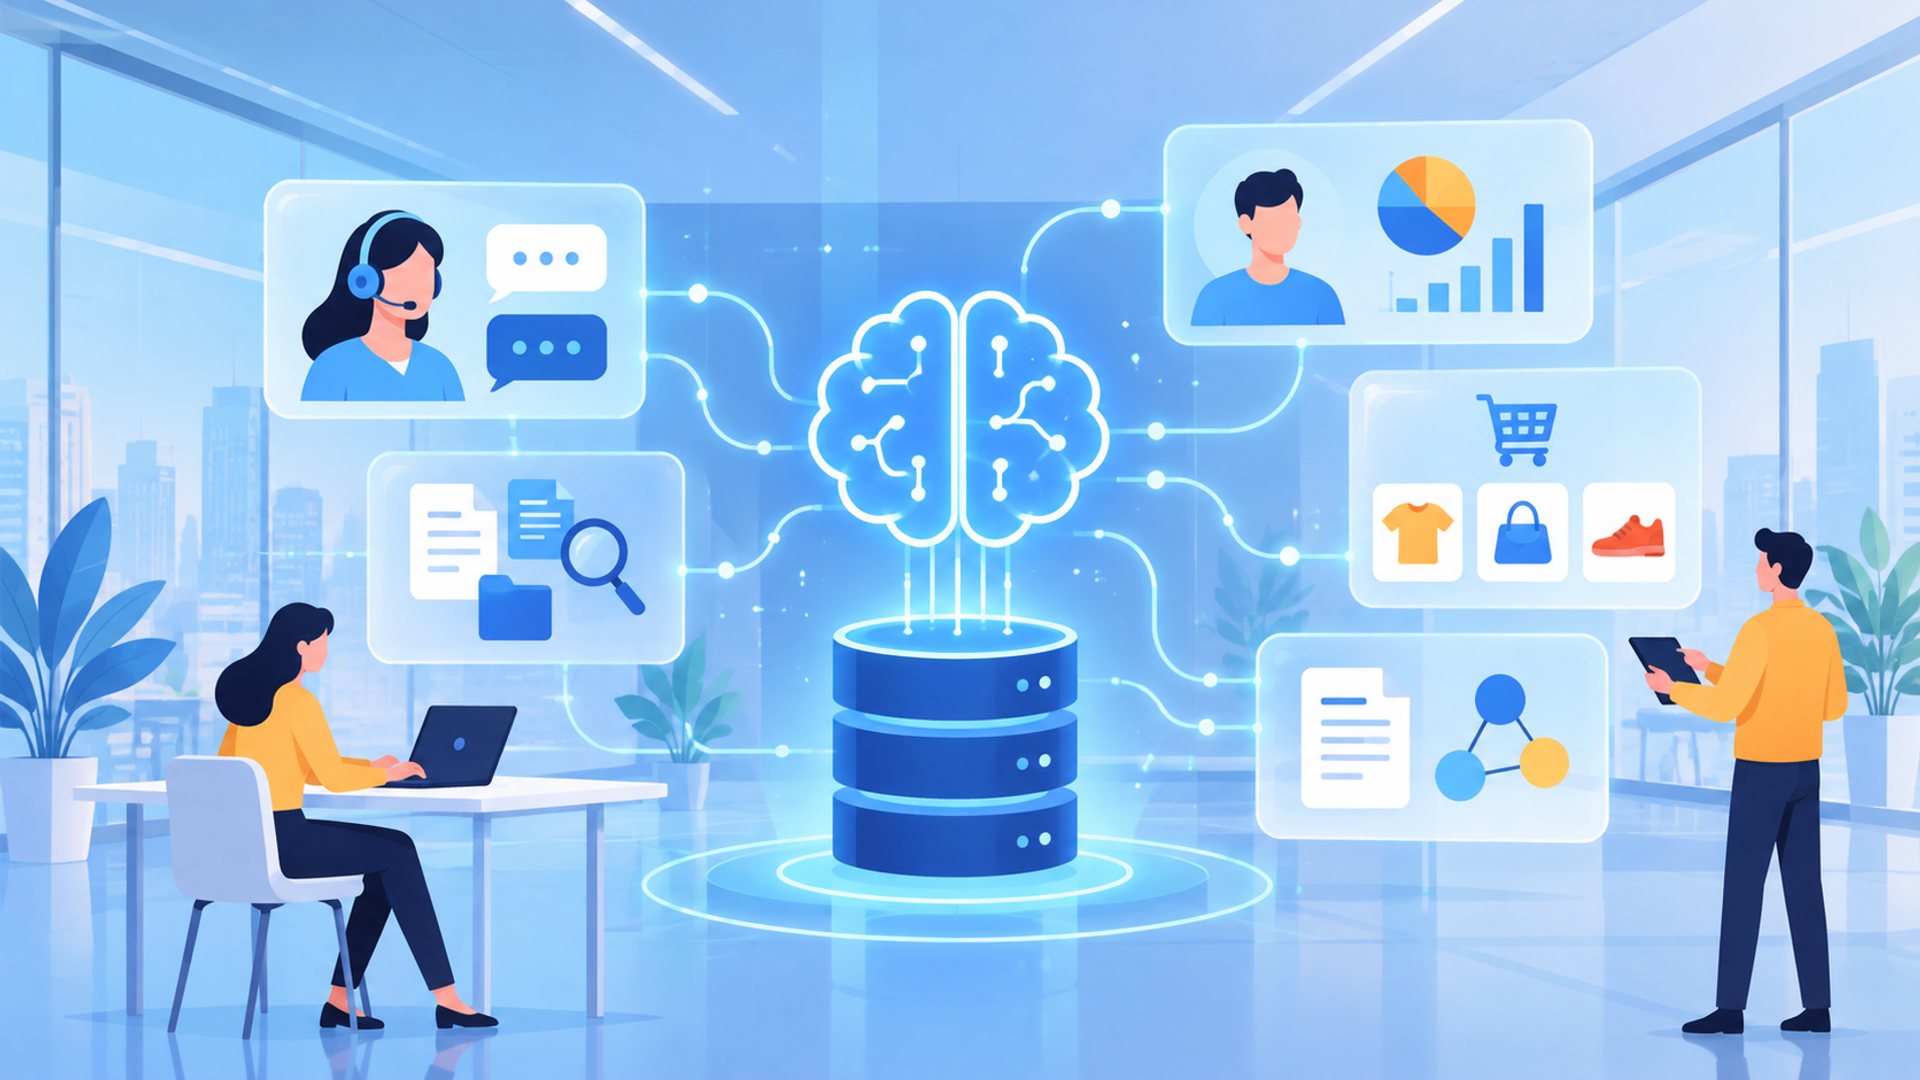
AIとデータベースを組み合わせる用途には、社内問い合わせ対応の支援や顧客分析などがあります。ここでは、業務への適用を検討する際に想定される活用例を紹介します。ベクトル検索の用途としては、AWSの公式資料でも意味検索、レコメンド、RAGなどが挙げられています。
例えば、広範な製品マニュアルを保有する製造業やハウスメーカーでは、技術的な問い合わせに関連するマニュアルや過去事例を検索し、AIが回答案を作成する仕組みが考えられます。回答案には参照元を示し、担当者が内容を確認してから顧客対応に利用する運用を設計します。導入時には、検索結果の関連性、回答の正確性、担当者の確認を含む対応時間を測定しましょう。
マーケティング分野では、顧客の購買履歴や行動ログを分析し、関連する商品候補を提示するレコメンドへの活用が想定されます。営業部門では、過去の商談履歴を検索・参照してトークスクリプトや提案書の案を作成する用途が考えられます。効果は対象データや運用によって異なるため、作成時間や提案内容の品質などを導入前後で定量的に比較・確認してください。
データ基盤を構築する具体的な手順
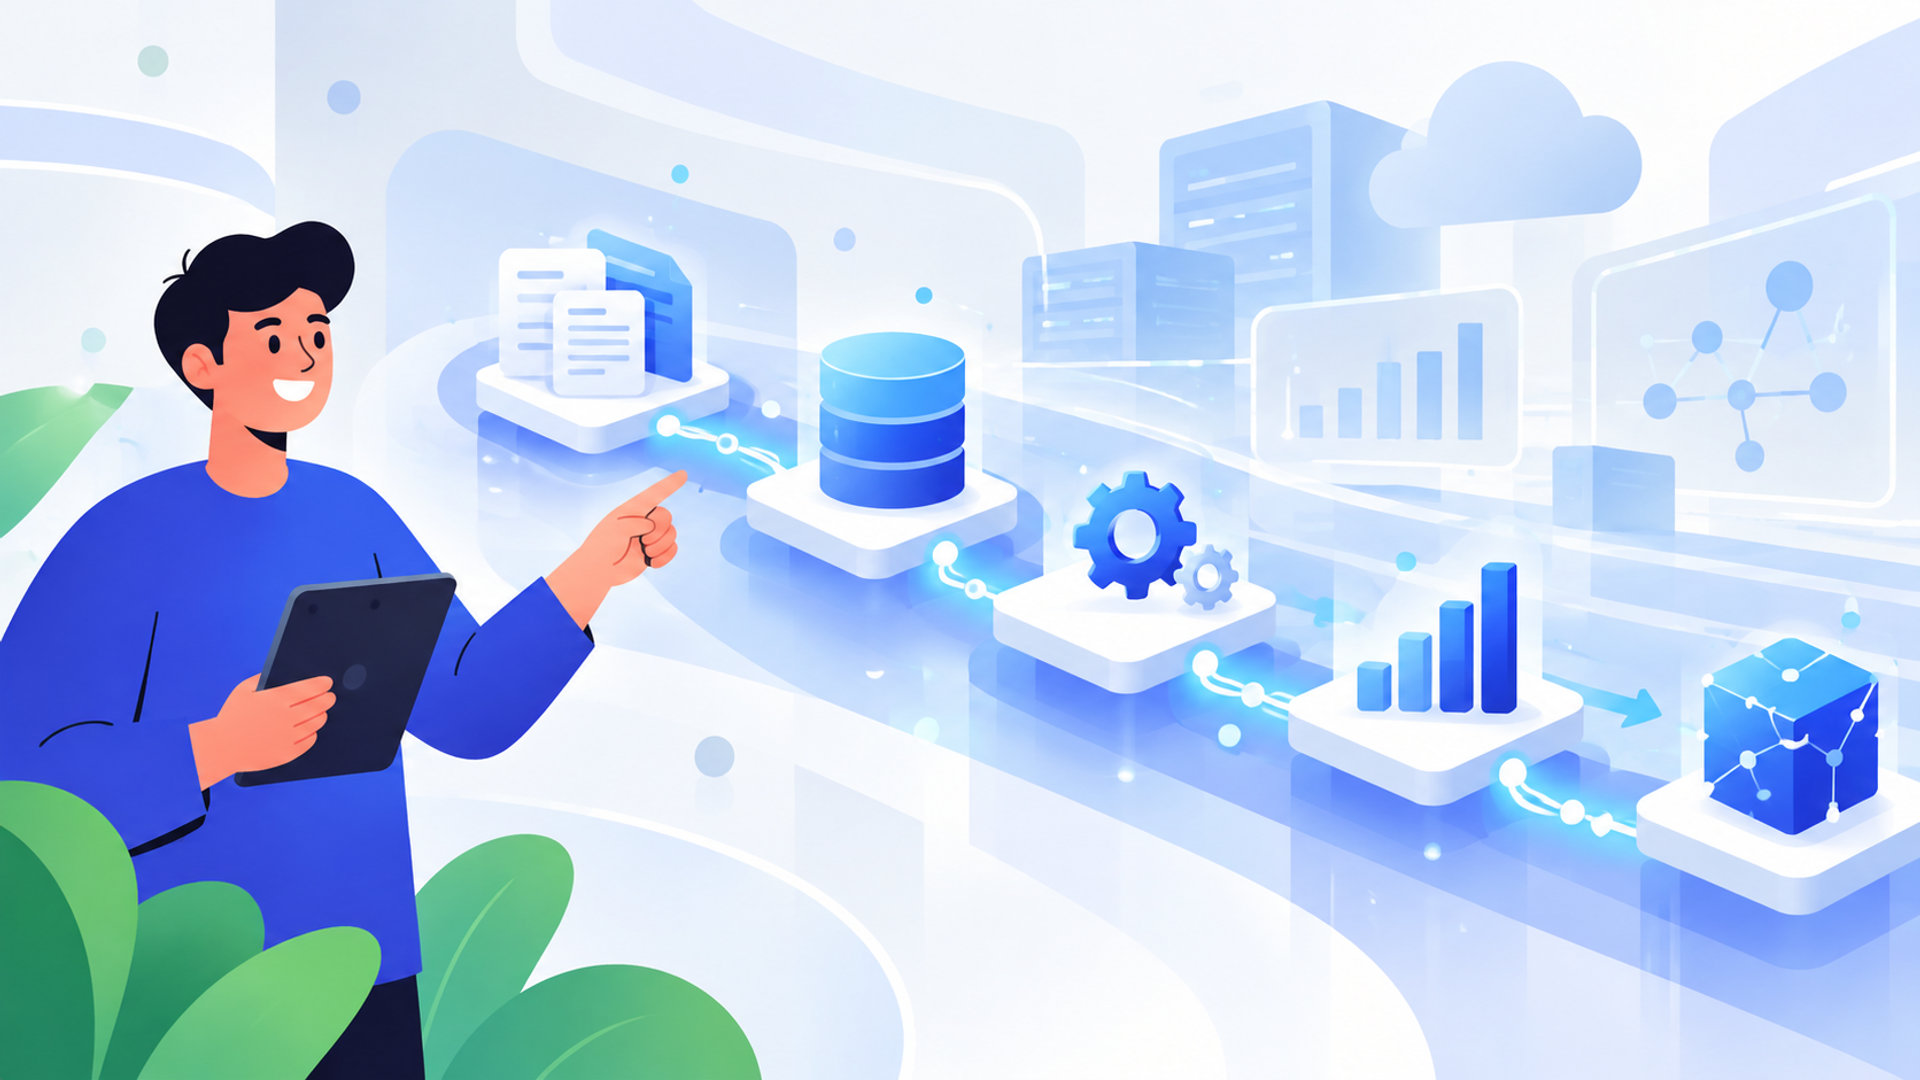
データ基盤構築プロジェクトを進めるには、事前のデータ整理からモデル連携に至る各工程を段階的に実施する計画性がポイントとなります。各フェーズにおける注意点をあらかじめ把握しておくことで、手戻りの防止につながります。
特に初期段階のデータ整備を軽視すると、高性能なAIモデルを接続しても期待した精度が得られないことがあります。技術的な実装と業務要件の摺り合わせを同時に推進する意識を持ちましょう。
要件定義とデータ整理・前処理
最初のステップでは、AIデータベース構築の「利用目的」と「対象データ」を明確に定義します。どのようなユーザーがどの業務課題を解決するためにAIを使うのかを整理し、必要なセキュリティレベルや応答速度の目標数値を設定します。
続いて、取り込むデータの抽出・クレンジング(ノイズ除去)を実施し、検索に適した単位へ分けるチャンク分割を行います。適切なサイズは、文書の構成、質問の内容、埋め込みモデルの入力上限によって異なります。意味の区切りを考慮し、複数のサイズで検索精度を比較して調整しましょう(Pineconeのチャンク分割に関する解説)。
データベース構築とAIモデル・アプリケーション連携
ベクトル検索を利用する場合は、前処理したテキストデータをエンベディングモデル(埋め込みモデル)で高次元のベクトルデータへ変換し、データベースへ格納します。データ量や更新頻度、使用するサービスに応じて、インデックス手法(HNSWやIVFなど)や検索設定を検討しましょう。
最後に、APIを介してLLMや自社の業務画面(Web UI、Slack、Teamsなど)とシステムを統合します。ベクトル検索を用いたRAGでは、ユーザーからの入力質問をベクトル化し、データベースから関連情報を取得した上でLLMに回答を生成させる一連のワークフローを構築してテストを重ねます。
構築・運用におすすめのデータベースサービス3選
自社に最適なサービスを選択する際は、検索レイテンシや運用負荷、コストパフォーマンスを総合的に比較することが大切です。ここでは、ベクトル検索基盤の構築・運用で比較候補となる3つのサービスを取り上げます。
| サービス | 主な対象 | 特徴 | 確認ポイント |
|---|---|---|---|
| Pinecone | ベクトル検索を容易に構築したい企業 | フルマネージドで大規模なベクトル検索に対応 | 利用量に応じたコスト設計とリージョン選択 |
| Google Cloud Vector Search | 大規模データの類似検索を行いたい企業 | 大規模なベクトル検索に対応しGoogle Cloud製品と連携 | インデックス作成時の費用とクラウド構成 |
| Amazon OpenSearch Service | AWS環境で全文検索とベクトル検索を統合したい企業 | テキスト検索とベクトル検索のハイブリッド運用が可能 | インスタンスサイズの最適化と設定負荷 |
1. Pinecone
Pineconeは、ベクトル検索に対応するフルマネージドのクラウドデータベースサービスです。インフラ管理の負担を抑えながら検索基盤を構築・運用したい場合において有力な選択肢となります(Pinecone公式資料)。
大規模なベクトル検索に対応しており、検索速度はデータ量・次元数・検索条件・同時実行数・構成によって異なります。公式の性能掲載例も特定条件での結果として確認し、自社のデータと想定負荷で評価しましょう。導入の手軽さに加え、利用量や必要な処理能力に応じた運用コストをあらかじめ比較精査しておく必要があります。
2. Google Cloud Vector Search
Google Cloud Vector Searchは、Googleが自社サービスで培った検索技術をクラウド上で利用できる検索基盤です。Google Cloudの公式解説では数十億件規模のベクトルへの拡張が説明されており、大規模なデータセットの類似検索において有力視されます。実際の検索性能については、構築する構成や検索条件に応じた個別検証が求められます。
BigQueryやVertex AIといったGoogle Cloudのサービスと組み合わせられるため、すでに同社のクラウド環境を運用している組織では、既存構成との連携を検討しやすい選択肢です(Vector Search公式資料)。
3. Amazon OpenSearch Service
Amazon OpenSearch Serviceは、全文検索やベクトル検索に対応するAWSサービスです。従来のキーワード検索とベクトル検索を組み合わせた「ハイブリッド検索」を構築する選択肢となります(Amazon OpenSearch Service公式資料)。
AWS環境でのセキュリティ設定やアクセス権限管理を含めた柔軟なシステム構成を組むことが可能です。キーワードの厳密性と意味検索の柔軟性を両立させたい用途に適していますが、利用者ごとの検索対象制限などは実務要件に合わせて個別に設計してください。
セキュリティ対策と運用面における注意点
社内の機密文書や顧客情報を集約するAIデータベース構築においては、堅牢なセキュリティ設計と最新データを維持する同期プロセスの確立が欠かせません。適切なアクセス権限の設定を怠ると、権限のない社員へ重要情報が露出するセキュリティリスクが生じるため注意してください。
役割に応じたアクセス制御であるRBAC(ロールベースアクセス制御)などを用い、検索を行うユーザーの役職や所属部署に応じて参照可能なデータを制限する仕組みを実装しましょう。また、保管時および通信時の暗号化(TLS/AES-256など)についても、利用するサービスの仕様と自社の要件に合わせて設定します。
あわせて、社内マニュアルや製品情報が更新された際に、データベース内のベクトルデータも同期されるパイプラインの構築が推奨されます。データ更新の遅れはAIが古い情報に基づいた誤回答を出力する原因となるため、差分更新の自動化ルールをあらかじめ整備しておきましょう。
ツールや基盤を比較・選定する際のチェックポイント
自社に最適なデータ基盤を選ぶ際は、システムの技術仕様だけでなく運用耐性やコスト構造を総合的に評価します。現場のビジネス要件を満たせるかどうか、複数の視点からチェックシートを作成して比較・検討してください。
- 検索レスポンスの速さ(要求するレイテンシ基準を満たしているか)
- データ更新時のインデックス再作成コストと所要時間
- 既存の基幹システムやクラウド環境との接続の容易さ
- ユーザー権限に応じたフィルタリング検索がネイティブで可能か
- データ量の増加に伴う従量課金体系の予測可能性
初期費用だけでなく、例えば1年〜3年間運用を継続した際のトータルコスト(TCO)を事前に試算しておきましょう。社内運用担当者のスキルセットに合わせて、完全マネージド型かカスタマイズ重視型かを選択してください。
組織内での定着化と活用の進め方
どれほど高度なAIデータベース構築を実現しても、現場の社員が日常の業務プロセスで活用しなければ十分な投資対効果は得られません。システムを納品して終了とするのではなく、組織全体へスムーズに浸透させるための定着プログラムを組み込みましょう。
実務上の課題抽出からスモールスタートでの検証、効果測定に至るプロセスを段階的に実施し、現場の疑問や負担を把握しながら活用を進めましょう。
利用目的の明確化と対象部署の選定
導入を成功させる第一歩は、「どの部署のどんな作業をどれくらい効率化するのか」というターゲットを明確に設定することです。全社一括でスタートさせるよりも、課題が明確で効果を測定しやすい部署から段階的に適用範囲を拡大させることが望ましいアプローチです。
現場の担当者が抱える具体的な業務課題をヒアリングし、AI検索をどのような作業に使うかを共有します。初期段階では「社内規定の確認」や「ヘルプデスク業務」などを候補に、対象データの整備状況や回答確認のしやすさを踏まえてテーマを選定しましょう。
運用後の効果測定と継続的な支援設計
システム稼働後は、利用回数や作業時間の削減量、回答精度に対するユーザーの満足度などを定期的に数値化して効果を測定します。収集したフィードバックをもとに、データの追加選定や前処理プロセスのチューニングを継続して実施しましょう。
AI活用の組織定着に関する関連事例として、株式会社JIMOSの導入事例が参考になります。同社は役員・管理職層から3段階で全社展開を進め、AI活用の土台づくりを推進しています。こうした段階的な展開を参考に、継続的な勉強会や相談窓口など、自社に合ったサポート体制を整えましょう。
AX CAMPなら社内データのAI活用に向けた人材育成と実務定着を支援できます
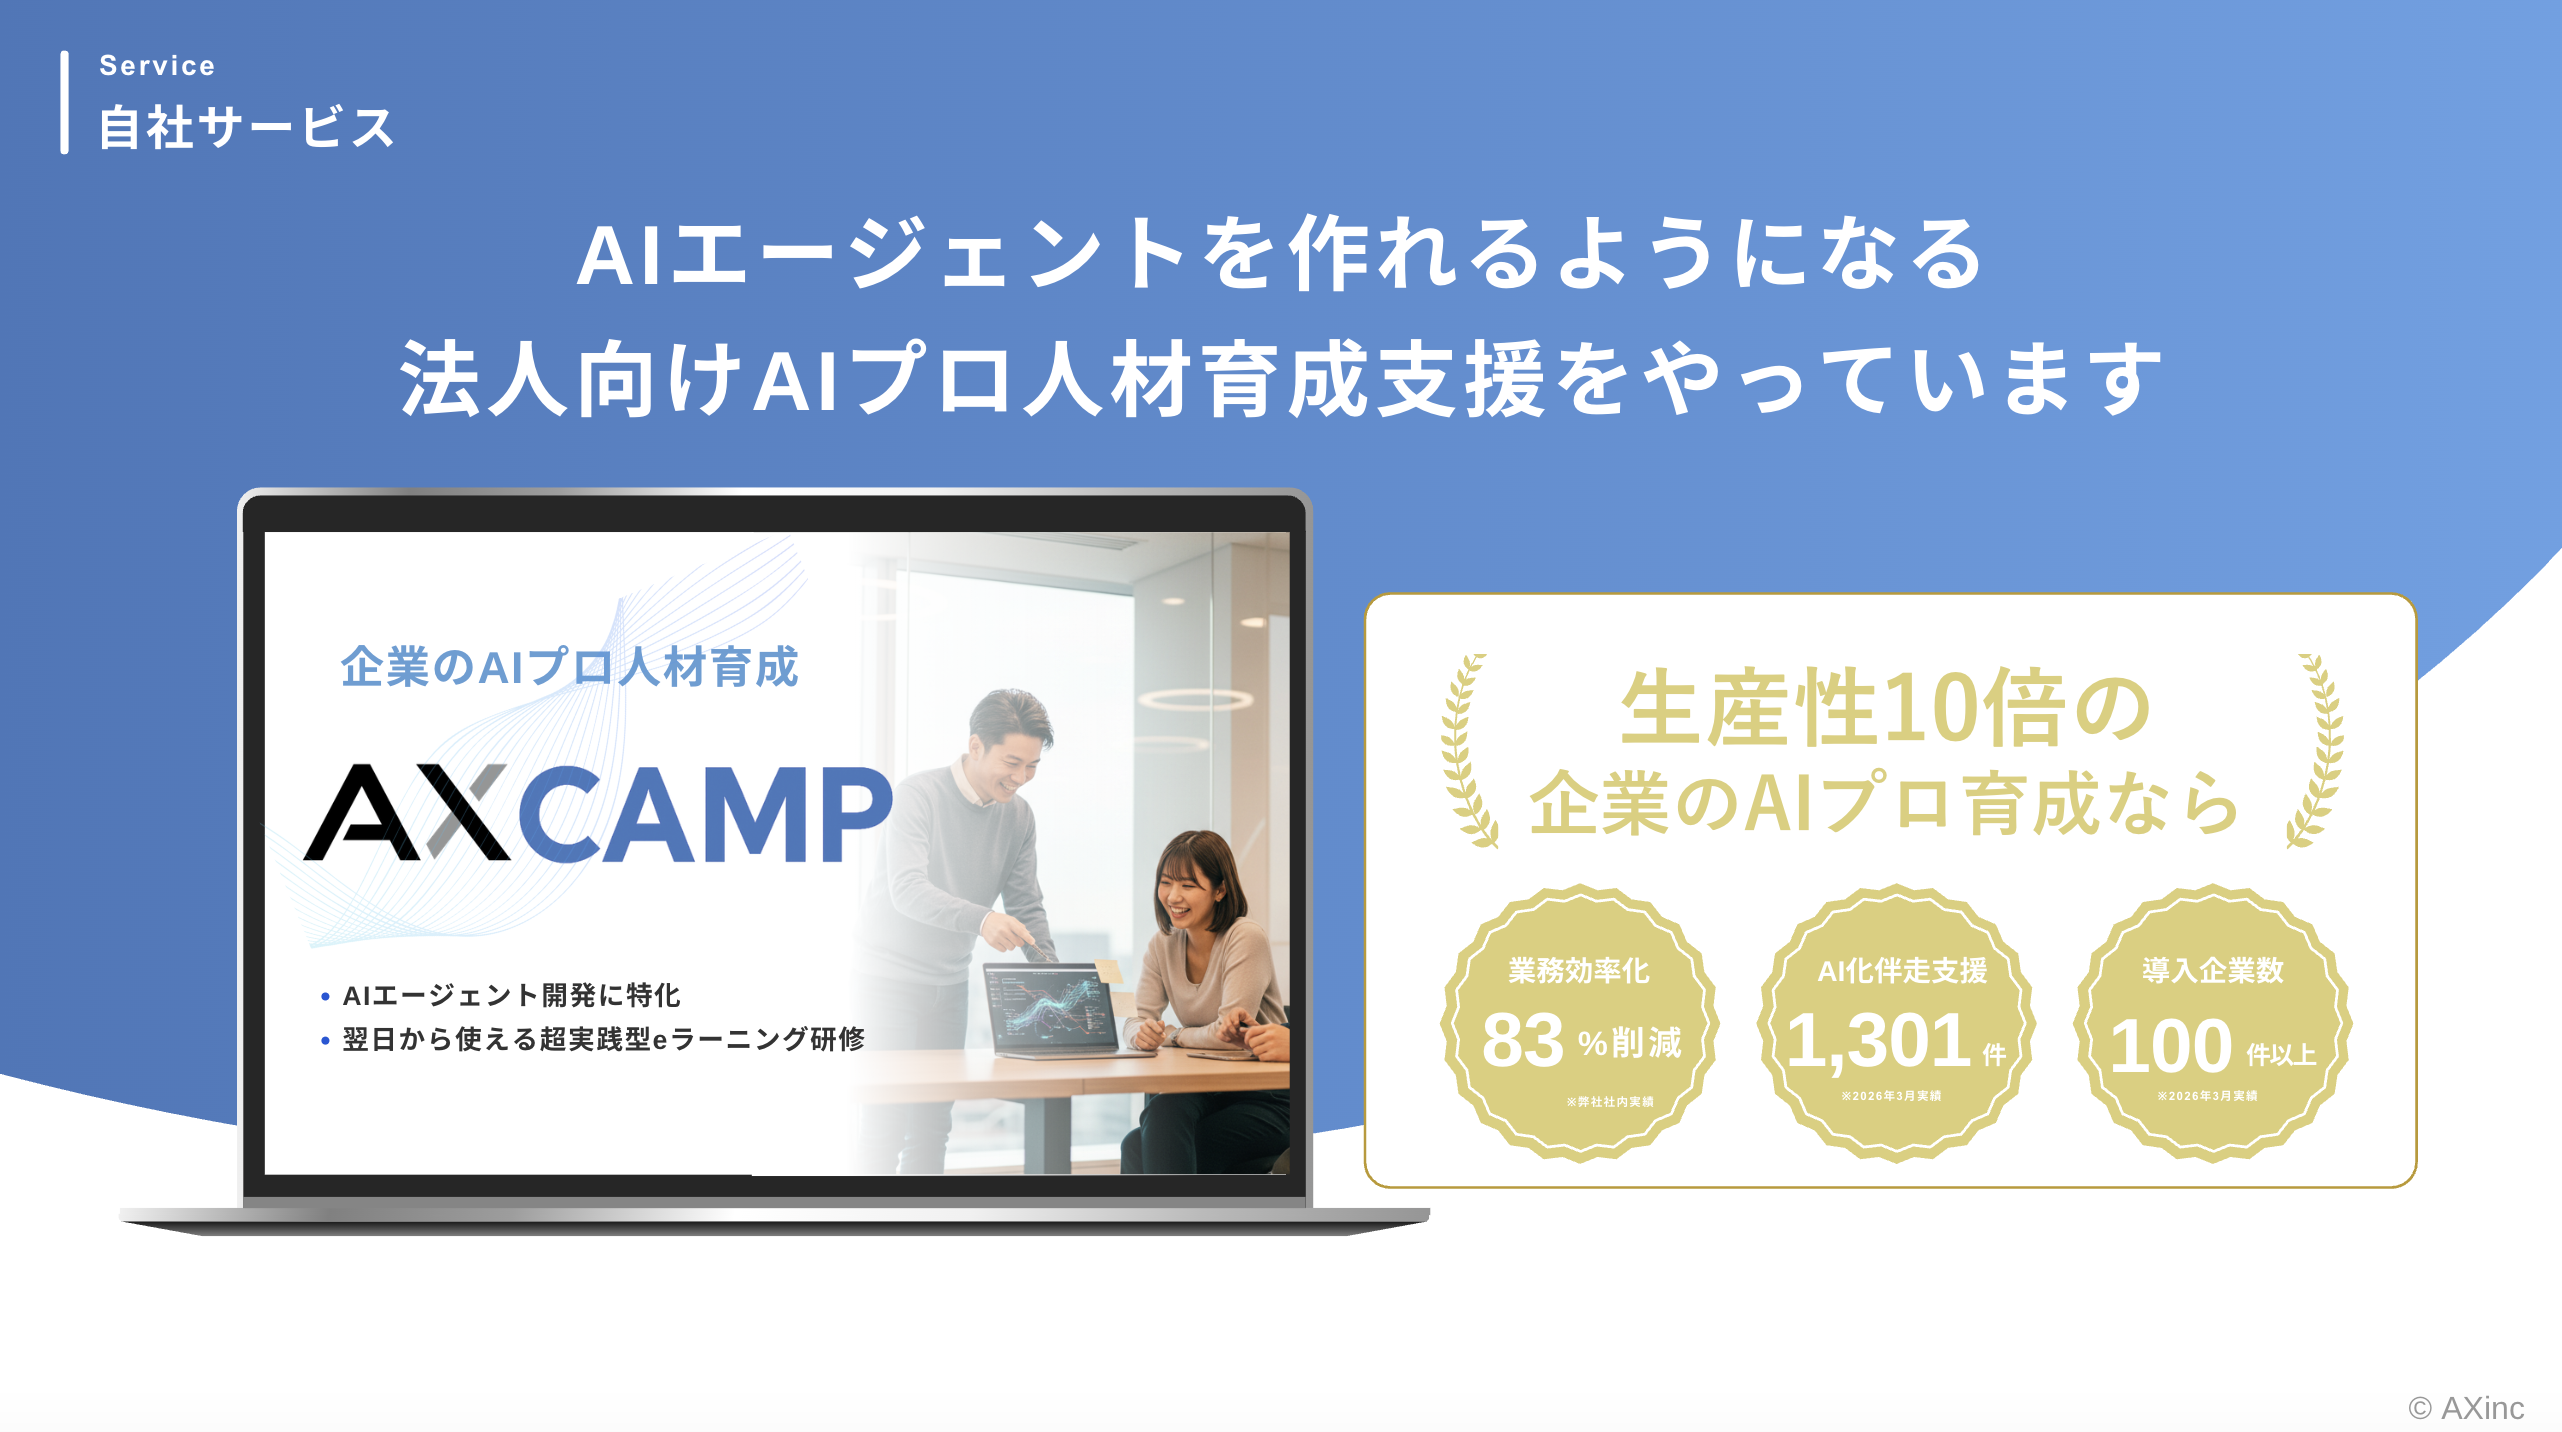
株式会社AXが提供する「AX CAMP」は、現場の業務課題解決から逆算した実践的なAI活用スキルを身につける法人向けAI研修プログラムです。プログラミング不要でPCの基本操作から受講可能で、非エンジニア層を含めた組織全体のAIリテラシー向上を支援します。
完全オンラインで、14時間のeラーニングとAI化計画のプランニング、伴走支援を組み合わせた研修設計です。さらに、半年〜年間の伴走支援を通じて、業務課題の分解から実務への落とし込みまで支援します。AIエージェント開発などの学習を実務につなげ、受講中に作成したAIツールをそのまま業務で活用できる状態を目指します(AX CAMPのサービス詳細)。
AI活用による業務改善の関連事例として、Route66株式会社の事例があります。同社へのインタビューでは、記事1本の原稿執筆に従来最大24時間を要していた一方、導入後はAIによる原稿出力が10秒になったと報告されています。
この10秒はAIの出力時間であり、画像の準備・挿入・装飾や人による確認などを含む記事制作全体の所要時間を示す数値ではありません。AX CAMPは「研修を終えること」ではなく「実務で成果を出すこと」をゴールに、業務課題の整理、AI化計画のプランニング、AIツールの実務活用まで伴走します。


法人向けAI研修
AX CAMP 無料資料
まとめ:効率的なAI活用のためのデータベース構築で社内データを資産化しよう
AIデータベース構築は、生成AIやRAGが社内の知見を参照し、業務で活用するための施策の一つです。既存RDBの活用や検索機能の拡張も含め、自社の目的に合った基盤を選択しましょう。
丁寧なデータ前処理と適切なセキュリティ対策を実施のうえ、実際の業務において回答の品質や作業時間の短縮効果を検証してください。
基盤を構築した後は、現場の利用目的に寄り添った定着化支援や効果測定を繰り返し、組織全体で使いこなす環境を育てていきましょう。対象業務を絞って検証を始め、確認できた効果をもとに活用範囲を広げてください。
法人向けAI研修
AX CAMP 無料資料
