「生成AIの学習データに社内データを活用したいが、個人情報漏洩やプライバシー侵害が懸念される」「どのようなデータ加工を行えば法務や情報システム部門の承認を得られるかわからない」とお悩みではありませんか?
社内データを用いたAI活用を推進するにあたり、セキュリティや法規制の遵守は欠かせません。本記事では、AIデータ匿名化の基礎から具体的な技術手法、ツール選定基準まで分かりやすく解説します。データ保護とAI分析の精度のバランスを検証し、組織内で適切にデータ利活用を進めるための知見を深めましょう。
法人向けAI研修
AX CAMP 無料資料
AIによるデータの匿名化の基礎知識と従来加工との比較
AIデータ匿名化とは、AIの学習や分析に用いるデータについて、個人の再識別リスクを低減し、利用目的に必要な有用性との両立を図る処理です。識別子の削除や属性の一般化などを組み合わせ、加工後のデータに残るリスクと分析への影響を評価します。
生成AIや機械学習にデータを活用する際は、単に個人名を隠すだけで十分とは限りません。データの分布や変数間の相関関係をどの程度保持する必要があるかを整理し、外部情報との照合による再識別リスクも考慮して加工方法を選びます。
マスキング・仮名化・匿名化の概念整理
データ保護の文脈で使われる「マスキング」「仮名化」「匿名化」は、処理の目的や元データとの対応関係が異なります。以下は技術的な加工方法の比較であり、各手法の名称だけで法令上の区分やAI学習への適性が決まるわけではありません。
| 加工手法 | 主な特徴 | 復元可能性 | AI学習適性 |
|---|---|---|---|
| マスキング | 氏名や住所などの一部を「*」等で覆い隠す | 処理方式による。表示のみの加工では元データが残る | 加工する項目や欠損の範囲によって精度への影響が異なる |
| 仮名化 | 識別子を別のIDや符号に置き換える | 対応表などとの照合で本人を識別できる場合がある | 同じ対象の履歴を分析しやすいが、照合可能性や利用条件の確認が必要 |
| 匿名化 | 識別子の削除や属性の一般化などで再識別リスクを低減する | 加工方法や利用環境に応じて復元・再識別のリスクを評価する | 加工強度と学習目的による。相関関係や予測精度の検証が必要 |
マスキングは画面上の情報露出を抑えるのに有効ですが、単に表示を隠すだけでは保存済みの元データまで保護することは不十分です。そのため学習データから特定の項目を消去する際は、予測精度に影響する重要要素まで損なわれていないか慎重に検証する手順を踏みます。
単なる技術的仮名化と、個人情報保護法が定める「仮名加工情報」は明確に分けて捉えます。法令上の仮名加工情報を作成した事業者は、元データや削除情報等を保管していることから、原則として個人情報として取り扱われます。なお照合可能性などの条件により個人情報該当性は変化し、仮名加工情報には第三者提供の原則禁止といった運用規律が存在します。実務における具体的な線引きは、個人情報保護委員会の匿名加工情報と仮名加工情報に関するFAQやガイドライン(仮名加工情報・匿名加工情報編)を参照しながら判断を整理してください。
一般的な匿名化処理を施したデータが、直ちに法令上の「匿名加工情報」とみなされるわけではありません。これに該当させるには法律で規定された加工基準や運用義務の遵守が求められます。ただし識別防止要件は、あらゆる技術による識別リスクを完全にゼロにすることまで求めてはいません。自社の利用目的やデータの提供先、加工後に残留するリスク量を照らし合わせて手法を選定してください。(出典:個人情報保護委員会ガイドライン(仮名加工情報・匿名加工情報編))
AI学習用途で求められる構造保持と精度確保
一般的な集計用途では平均値や総計といった巨視的な統計量を揃えることが主体となります。それに対し、AI学習用途では多変量間の相互関係や全体的なデータ分布が分析精度を左右するため、匿名加工を行いつつもモデル生成に必要なデータの特徴を残せているかを念入りにテストする運用を行ってください。
匿名化処理を強めると、データに含まれる重要なパターンが失われ、AIの予測精度が低下する場合があります。逆に加工強度を弱めると、外部情報との照合などによる再識別リスクが残りやすくなります。
AIデータ匿名化においては、プライバシー保護とAIモデルの予測精度の維持というトレードオフの関係を考慮しなければなりません。データごとの利用目的に合わせて、必要な情報と許容できるリスクを整理し、加工強度を検証する姿勢が大切です。
AI活用でデータ加工が必要とされる背景と課題
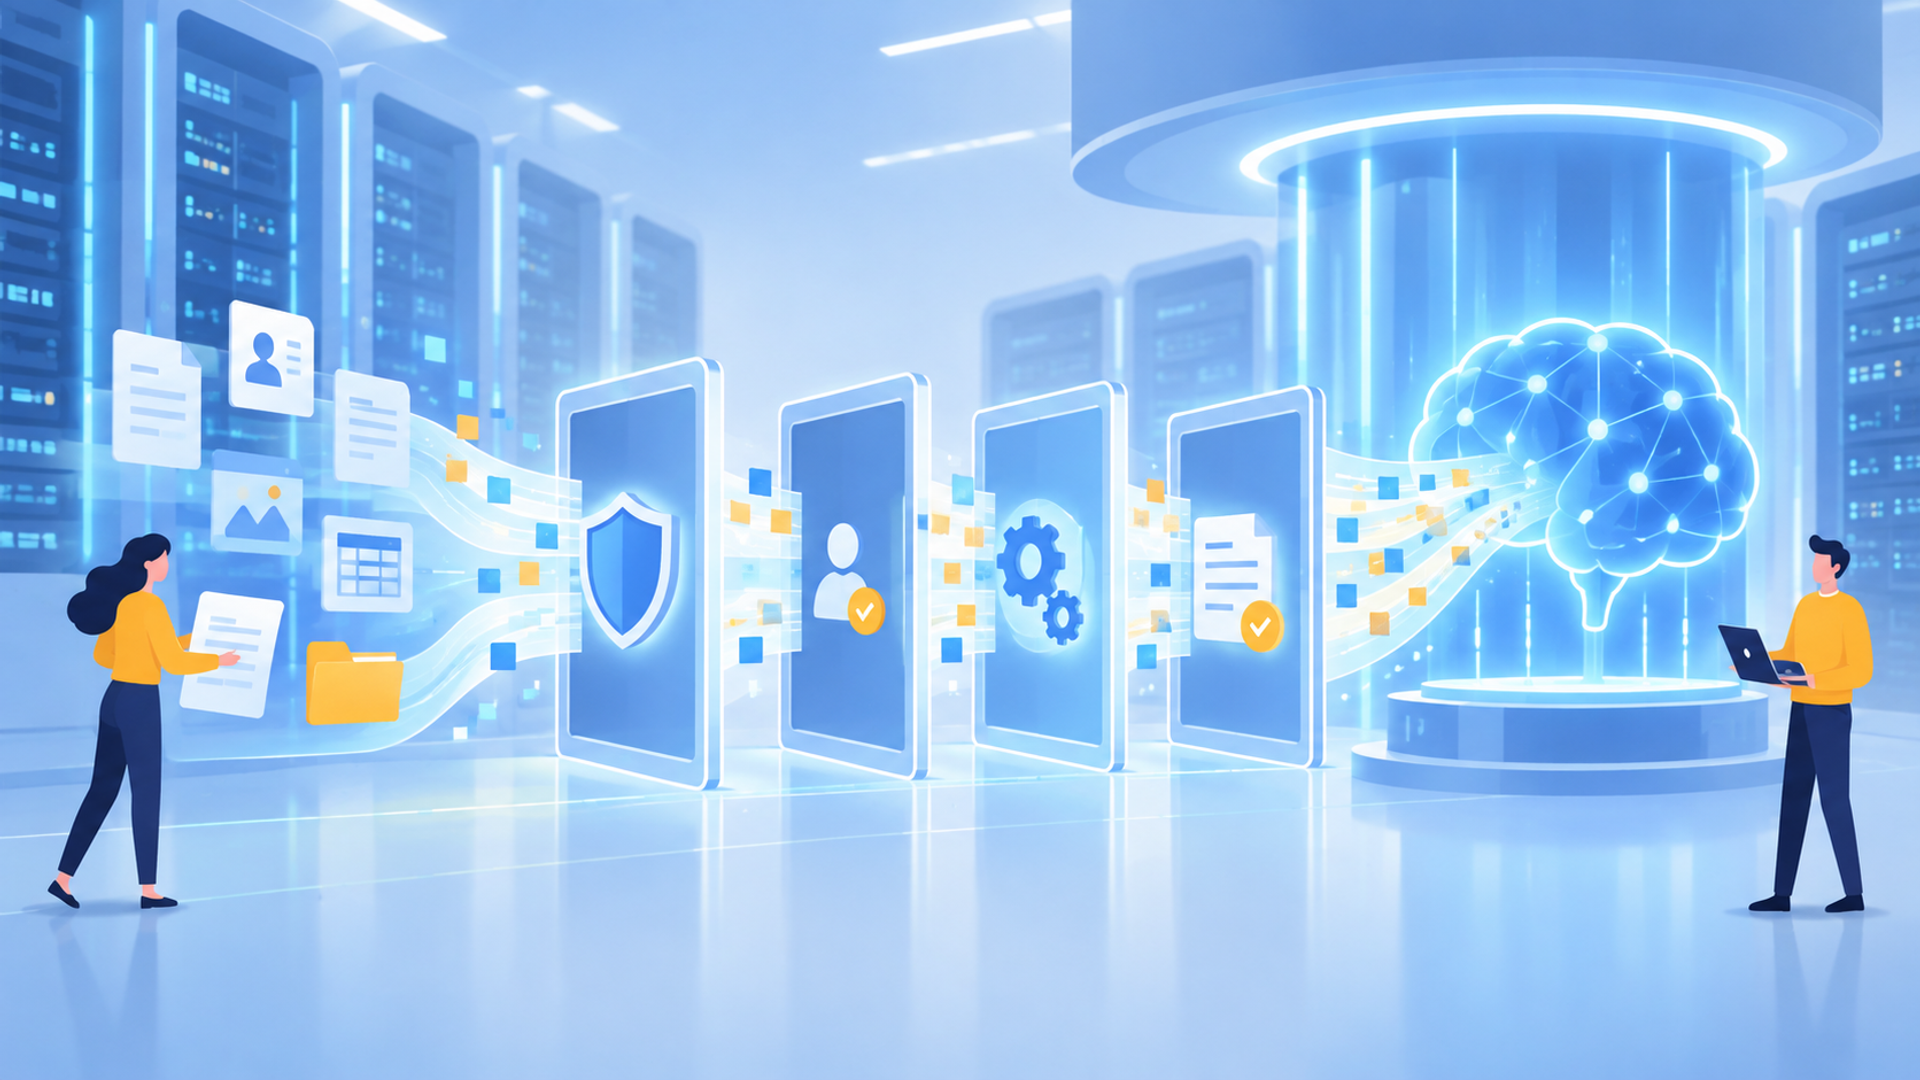
社内データをAIや大規模言語モデル(LLM)へ投入する運用が広がるにつれ、ガバナンスとコンプライアンスの厳格化が現場に求められています。特に個人情報を含むデータを扱う際は、テキスト入力・文書参照(RAG)・追加学習などのアプローチごとに、データ加工の深さやアクセス権限の制御を個別に設計して運用に組み込みます。
法務部門や情報システム部門との社内合意を取り付ける局面では、送信先インフラ・参照権限・保管期間・利用用途の4点を網羅した明確な説明が欠かせません。懸念される流出リスクに対してどのような技術的・運用上の対策を講じているか、具体的な対応表をあらかじめ作成して協議に臨むのが確実です。
個人情報の再識別化によるプライバシー侵害リスク
一見すると個人が特定できないように見えるデータであっても、外部データとの突合などによって元の個人が特定される場合があります。このような再識別化の手法の一つが、複数の情報を結び付けるリンケージ攻撃です。
たとえば購買履歴、位置情報、年代といった単体では特定できない属性情報(準識別子)であっても、複数重なることで特定の個人が照合・追跡されるリスクが生じます。氏名やIDといった直接的識別子を取り除いた場合でも、属性を組み合わせた際の再識別可能性に対する対策を怠らないように判断します。(出典:NIST SP 800-188の準識別子とリンケージ攻撃に関する説明)
そのため、単一の属性を隠すだけでなく、他の情報と組み合わされた場合のリスクまで想定した多角的な安全管理を取り入れることが望まれます。
LLM学習データへのデータ混入と法令順守の課題
LLMへのプロンプト入力、RAGによる関連文書参照、追加学習(ファインチューニング)の3者は、技術的挙動が異なるため切り分けて整理します。一般的なRAGは検索されたテキストを一次的な入力文脈として組み込む構造であり、モデル内部のパラメータ(重み)自体を書き換える学習プロセスとは異なります。(参考:RAGの原著論文)
入力やRAGの利用時は、提供事業者によるデータの保存設定・学習利用条件に加え、利用者ごとの文書の参照権限を確認します。個人情報保護委員会は、個人情報の入力が利用目的の達成に必要な範囲内であることや、本人同意なく個人データを入力する場合に、提供事業者がそのデータを機械学習に利用しないことなどの確認を求めています。(出典:生成AIサービス利用時の注意喚起)
追加学習を実施する際には、データセットへの個人情報の混入やモデル内でのデータ再現・漏洩リスクを事前に査定します。プロンプトを介してモデルが記憶したデータを返答として出力する事例は学習データ抽出に関する研究でも実証済みです。さらに、学習済みモデルから特定データを抹消したい場合は、単に元ソースを削除するだけでは不十分であり、フル再学習や機械的忘却(Machine Unlearning)の適用と効果の確認が不可欠となります。(参考:機械的忘却に関する原著論文)
法務・規約面からは、個人情報の利用目的の範囲内での制限、および第三者提供にかかる原則・除外規定を取り決めます。業務委託に伴うデータ提供は第三者提供制限の対象外とみなされるケースがあるものの、その場合でも委託先に対する適切な監督責任が伴います。自社の利用契約内容と実データの取り扱いフローを突き合わせながら、法的な整合性を維持してください。(出典:個人情報保護委員会ガイドライン(通則編)の利用目的による制限・第三者提供・委託先の監督)
匿名化はリスク低減策の一つであり、すべてのAI利用で法令上必須になるわけではありません。法務部門や情報システム部門と連携し、利用目的やデータの法的な区分、契約・保存条件に応じて、必要な加工とアクセス管理を組み合わせましょう。文書や画像を利用する場合は、著作権についても文化庁のAIと著作権を確認してください。
法人向けAI研修
AX CAMP 無料資料
安全性と利便性を両立する主要な技術手法
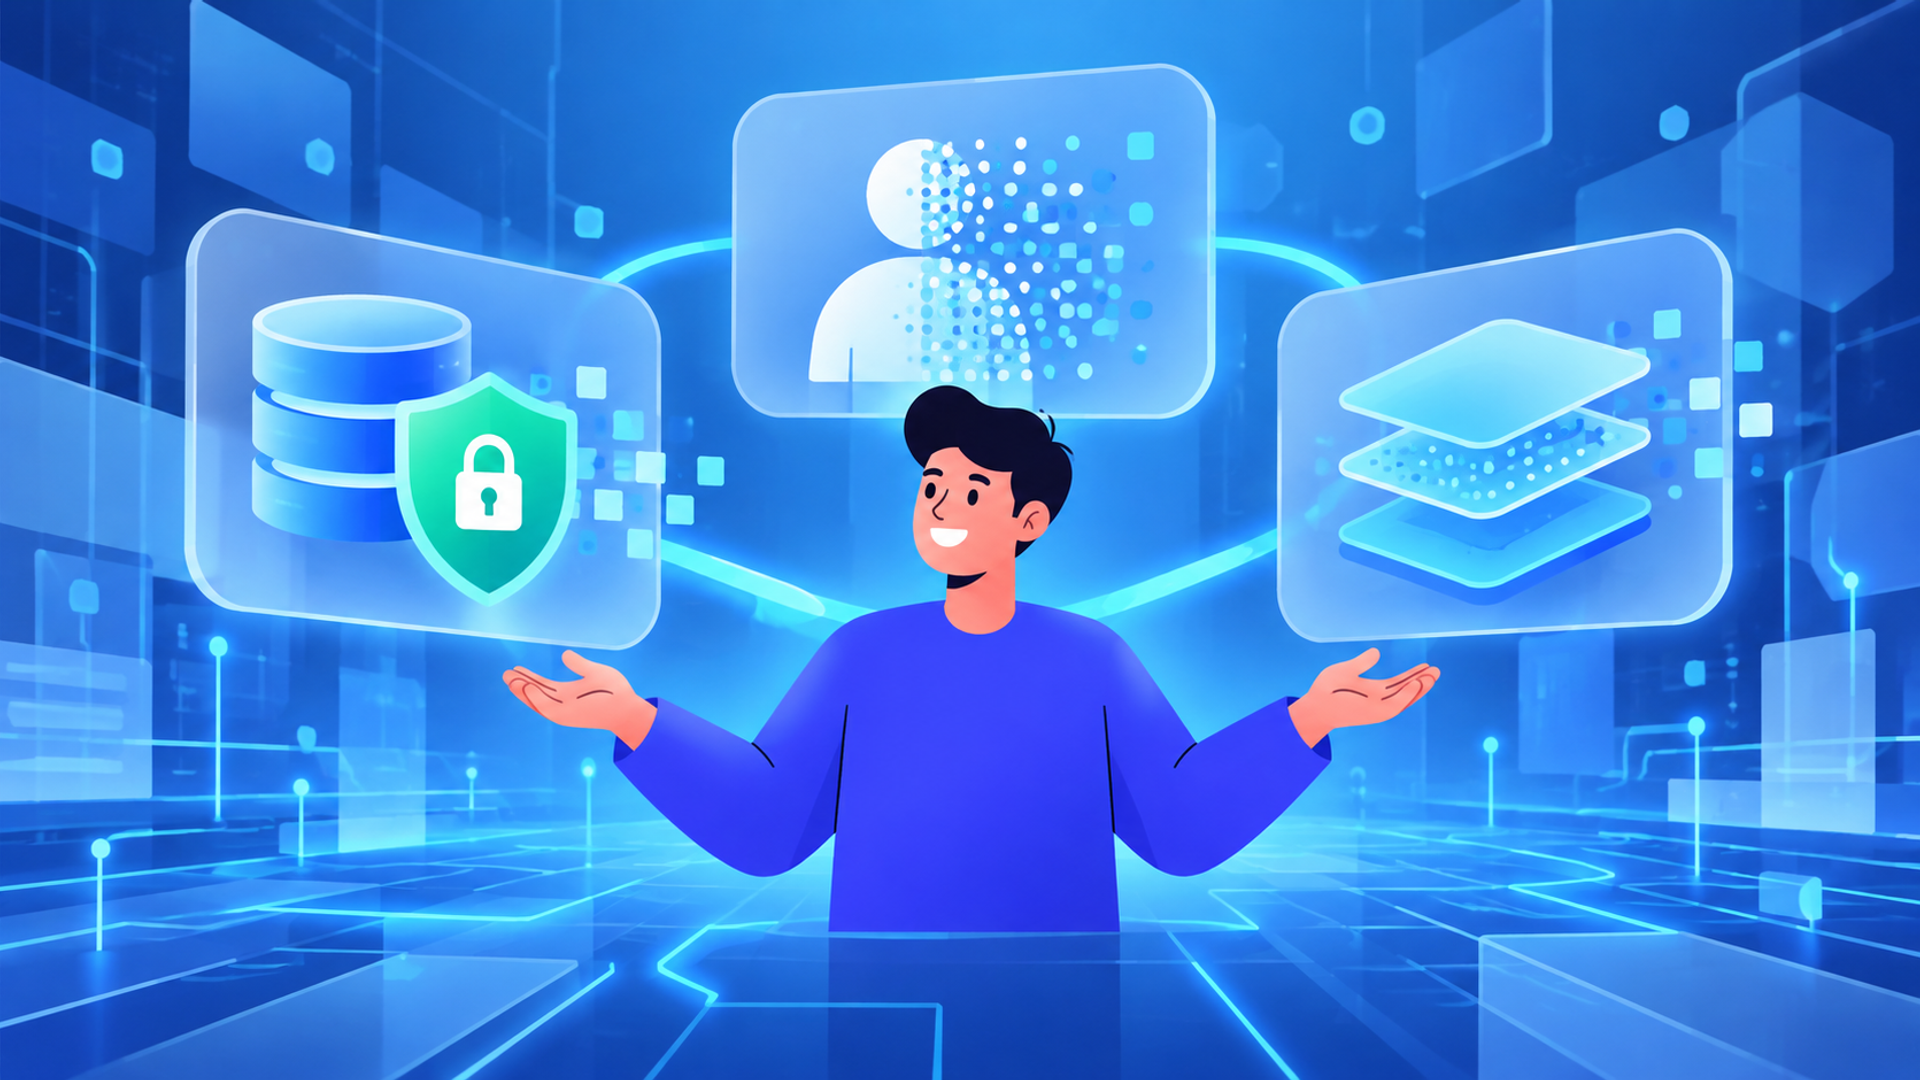
AIデータ匿名化では、データの利用目的に合わせた技術手法の選択がポイントになります。代表的な手法として、差分プライバシー、合成データ生成、トークナイゼーションがあり、それぞれ保護の仕組みや適用条件が異なります。いずれも、採用するだけで法令上の匿名加工情報になるわけではありません。
それぞれの仕組みや利点、限界を理解することで、自社のセキュリティポリシーとAI活用目的に合う手法を検討しやすくなります。
統計的プライバシーを保護する差分プライバシー
差分プライバシー(Differential Privacy)は、個人のデータの有無によって、処理結果の出力確率分布が変化する程度を数学的に制限する仕組みです。個人について追加的に得られる情報を制限する枠組みであり、その人のデータの有無について推測を完全に不可能にする保証ではありません。(出典:NIST SP 800-226)
差分プライバシーの実装では、生データそのものだけでなく集計結果や学習時の勾配などに制御されたノイズ(雑音)を付与するアプローチを取ります。安全性の強さはパラメータε(イプシロン)で制御し、近似差分プライバシーではδ(デルタ)を設定することで確率的な上限にゆとりを持たせます。パラメータの設定のみならず、保護対象を特定の1レコードとするか個人単位とするかといった前提定義まで揃えて運用設計を進めてください。
同じ個人のデータを使って処理を繰り返す場合は、プライバシー損失の累積を評価し、プライバシー予算を管理します。保護の強さと分析精度はパラメータやデータ量、処理方法によって変わるため、顧客全体の傾向分析やAIモデルの学習など、実際の用途で有用性を検証しましょう。(出典:NIST SP 800-226)
実データを再現してリスクを抑える合成データ生成
合成データ(Synthetic Data)生成とは、元データの統計的特性や関係性を学習したモデルなどを用いて、人工的なデータを生成する手法です。元データの分布や相関関係を再現することを目指しますが、その再現性は生成方法や対象データによって異なります。
合成データは実データを外部に露出させない手段として有効ですが、合成データという形式だけで強固な匿名性が担保できるわけではありません。アルゴリズムによっては元データの特徴を過剰に記憶し、個人の属性を逆引き・分析される危険が残るためです。生成元データの過学習による再現や属性の推測リスクについて事前検証を行う体制を整備してください。(出典:合成データのプライバシーと有用性を評価した原著論文、NIST SP 800-226の合成データに関する説明)
機械学習モデルのトレーニングや開発環境のテストデータへの活用を検討する際は、生成方法に応じて差分プライバシーの適用や漏洩リスクの検証を組み合わせます。あわせて、加工後の予測精度や属性ごとの偏りなどを確認し、安全性と有用性の両面から利用の可否を判断しましょう。(出典:NIST SP 800-226)
特定の値を置き換えるトークナイゼーションと暗号化
トークナイゼーションは、氏名やクレジットカード番号などの機密データを、元の意味を持たない代用値(トークン)に置換する処理手法です。
対応表を使う方式では、トークンから実データを参照するための対応関係を別に管理します。この方式で元の値を取得する際は、暗号鍵による復号とは異なり、保管した対応関係を参照します。対応表へのアクセスを制限することで、データベースやAIパイプライン内で元の値を直接扱う範囲を減らせます。(出典:カナダ・サイバーセキュリティセンターのトークン化に関する技術資料)
あるいは、暗号技術に基づいて無作為なトークンを生成する方式も選ばれます。トークナイゼーションと一般的な暗号化は完全に独立した技術群というわけではなく、アーキテクチャに応じて元のデータとの対応表や暗号鍵の厳重なアクセス権限管理が求められます。(出典:Google Cloudの仮名化に関する公式資料)
標準的な暗号化技術は保存中や通信経路での盗聴防止を主目的としており、データを暗号化する手続きのみで法的な匿名化が達成されるとは言えません。さらに暗号化されたままの文字列をAIに入力しても、元のデータ構造を理解した学習や推論は困難です。暗号状態を保持したまま演算を実行したい場合には、秘密計算(同型暗号など)をはじめとする専用技術の導入やアーキテクチャの追加開発を伴います。(参考:NIST SP 800-188の暗号化・アクセス制御と安全な計算に関する説明)
実データとの紐付けを許可するシステムと利用者を限定し、アクセス権限や操作履歴を管理しましょう。トークンへの置換だけで、他の属性との照合による再識別リスクまで解消されるわけではありません。
匿名化ツールの選定における評価ポイント
AIデータ匿名化ツールを選ぶ際は、セキュリティ強度だけでなくAIの分析精度を維持できる評価機能を備えているかどうかの検証が欠かせません。また、自社の既存データパイプラインにスムーズに統合できるシステム連携性にも着目しましょう。
ツールのスペック比較を行う際は、以下の評価軸を中心に総合的な導入効果を検討すると選択ミスを防ぎやすくなります。
| 評価項目 | 重視すべき確認ポイント | 運用上のメリット |
|---|---|---|
| 加工精度と有用性 | k-匿名性(準識別子の組み合わせが同じレコードを少なくともk件にする考え方)では、準識別子の設定を含む評価ができるか。差分プライバシーではε・δ、保護単位、累積損失を確認できるか | 保護の条件とAIモデルの予測精度への影響を比較できる |
| 自動検出能力 | 自然言語処理などによる個人情報の検出範囲と、見逃し・誤検出を評価できるか | 手作業の負担を減らし、必要な確認作業を把握しやすくなる |
| パイプライン連携 | API連携や主要クラウド基盤(AWS/Snowflake等)に対応しているか | 既存のデータ運用フローへの組み込みを検討しやすくなる |
| ガバナンス機能 | 加工履歴の監査ログ保存や再識別リスクの評価結果を確認できるか | 法務や情報システム部門に、処理内容と残るリスクを説明しやすくなる |
kは、同じ準識別子の組み合わせを持つレコード数の下限を表します。ただし、準識別子の選び方や外部情報との照合可能性によって残るリスクが変わるため、kの値だけで安全性全体を判断しないことが大切です。k-匿名性は属性の組み合わせに基づく識別のしにくさを扱い、差分プライバシーは個人のデータの有無による出力確率分布の変化を制限するため、保証の性質が異なります。(出典:NIST SP 800-188のk-匿名性と差分プライバシーに関する説明)
データの加工強度とAI分析の有用性のバランス
ツールの評価において重要なのが、加工強度をコントロールできるパラメータ調整機能の有無です。加工を強めることで必要な情報が失われ、分析結果の有用性が損なわれる場合があります。
匿名加工ツールを吟味する際は、元のデータ構造や統計量を維持している度合いを表す指標(有用性スコア)の算出機能や、再特定リスクの分析モジュールが備わっているかを確かめます。指標の算出ロジックや想定される攻撃モデルの範囲も併せて評価し、最終的には自社が構築するAIモデルで期待通りの実用精度が出せるかを検証するアプローチをとってください。
客観的な数値でリスクと有用性のトレードオフを確認しながら設定を変更できるツールを選択すると、法務部門との合意形成にも役立ちます。
既存のデータパイプラインやAI基盤との連携性能
AIデータ匿名化を日常的な業務プロセスに組み込むためには、システム間の連携がスムーズに行える仕組みを整えましょう。手動によるデータ出力やアップロードを前提としたツールでは、運用負荷が高まり継続的な活用が難しくなる場合があります。
データウェアハウスやクラウドストレージと直接連携させ、データの取得・蓄積タイミングに応じて自動で加工処理を差し込むデータパイプラインを設計します。万一、匿名化の失敗や過不足(検出漏れ)が発生した場合は、異常検知アラートによって後続のAI学習・分析フローを即座にストップ・検疫できるリカバリー運用を整備してください。
WebAPIの提供有無や、主要なデータ基盤とのコネクタが用意されているかを事前に確認しておくことで、導入後の運用自動化が進めやすくなります。
組織内で安全に運用するための注意点とガバナンス
どれほど優れたツールを導入しても、組織全体での運用ルールやガバナンスが確立されていなければ形骸化してしまいます。アクセス権限の最小化や定期的なリスク監査を組み込んだ運用プロセスの構築に取り組みましょう。
データ匿名化は一度実施して終わりではなく、新たな脅威や法改正に対応できるよう継続的な見直しを行う体制づくりを意識することが大切です。
まず取り組むべきは、データへのアクセス権限を最小限に制限する最小権限の原則の徹底です。匿名化前の生データにアクセスできる担当者を限定し、誰が・いつ・どのデータに対して加工を行ったかの監査ログを記録する仕組みを整えます。
また、生成AIやLLMの技術革新に伴い、従来安全とされていた加工データから新たな再識別手法が発見される可能性もあります。定期的にリスク評価を実施し、加工ガイドラインを最新の状況に合わせてアップデートしていく運用を徹底しましょう。
導入に向けた具体的なステップとロードマップ
AIデータ匿名化をスムーズに定着させるには、段階的な導入ステップを踏むことが効果的です。データの洗い出しから実証実験(PoC)、本番環境への組み込みまで計画的に進めていきましょう。
焦って全社展開を目指すのではなく、まずは特定のプロジェクトやデータ種別に対象を絞って検証を重ねるアプローチが着実です。
ステップ1:対象データの特定とリスク分類
社内に存在するデータの種類を整理し、個人情報や機密情報の有無、データの機密度レベルを分類します。利用目的や提供先も確認し、どのデータに対してどの程度の加工やアクセス制限が必要かを定義します。
ステップ2:技術手法およびツールの選定
利用目的に適した手法(差分プライバシー、合成データ等)を検討し、必要な機能を備えたツールを比較・選定します。手法ごとの保護対象と保証の条件も確認します。
ステップ3:PoC(概念実証)の実施と精度検証
小規模なデータを用いて実際の加工処理を行い、再識別・情報漏洩リスクの評価とAIモデルの学習精度への影響を検証します。法務部門とも協議を行い、自社で定めた利用条件と安全基準を満たしているか確認します。
ステップ4:本番環境への組み込みと運用モニタリング
データパイプラインへ加工処理を組み込み、本番運用を開始します。運用開始後もログの点検や定期的なリスク評価を継続し、差分プライバシーを使う場合は繰り返し処理によるプライバシー損失も管理します。
AX CAMPなら現場成果から逆算したAI活用を学べます
AI活用を進める上で「学んだ知識を自社の業務にどう結び付けるか」は多くの企業が直面する課題です。株式会社AXが提供する法人向けAI研修「AX CAMP」では、プログラミング不要でPCの基本操作から受講でき、実践的なAI活用スキルの習得を目指せます。
研修プログラムは完全オンラインに対応し、14時間のeラーニングとAI化計画のプランニング、半年〜年間の伴走支援を組み合わせて設計されています。研修を終えることではなく、現場で成果を出すことをゴールに、AI顧問として業務課題の分解から実務への落とし込みまで伴走します。
受講中に作成したAIツールを、そのまま業務で活用できる状態を目指す点が特長です。(サービスの詳細:AX CAMP公式サービスページ)
AI活用の組織展開に関する関連事例として、株式会社JIMOSの導入事例では、役員・管理職から3段階で全社展開し、AI活用の土台づくりを推進しています。
また、原稿作成の効率化に関する関連事例として、Route66株式会社の導入事例では、記事1本の原稿執筆に最大24時間かかっていた業務について、AIによる原稿出力が10秒になったと紹介されています。この10秒はAIの出力時間を指し、画像の準備・挿入・装飾や人による確認など、記事制作に関わる全作業の所要時間を示すものではありません。
これらは、組織へのAI活用の展開や原稿作成の効率化を紹介する関連事例です。自社の業務課題を整理し、現場で活用できるAIスキルを身につけたい企業は、AX CAMPをご検討ください。


法人向けAI研修
AX CAMP 無料資料
まとめ:適切なデータ保護を実施して安全なAI活用を推進しよう
AIデータ匿名化は、個人の再識別リスクを低減しながら、社内データの有用性との両立を図るアプローチです。一般的な匿名化と法令上の匿名加工情報を区別し、利用目的に合う技術とツール、運用ルールを選びましょう。
差分プライバシーでは保証の条件と累積するプライバシー損失を確認し、合成データでは情報漏洩リスクと有用性を検証することが大切です。また、LLMへの入力・RAGによる文書参照・追加学習を分けて、保存設定や学習利用条件、参照権限を確認してください。
法務や情報システム部門と連携し、自社の目的やデータ特性に合った保護策を継続的に見直しながら、事業成長につながるAI活用を推進しましょう。
法人向けAI研修
AX CAMP 無料資料
