「CRMやSFAの顧客データに表記ゆれや重複が多く、分析に活用できない」「手作業でのデータ修正に膨大な時間がかかっている」とお悩みではありませんか?データの利活用が進む2026年において、データ品質の向上は企業の競争力を支える重要な要素です。
手作業による修正工数を削減し、RAGや分析AIで活用するデータの品質を高める手段がAIデータクレンジングです。本記事では、仕組みの基礎や手作業との違い、導入メリット、おすすめツール、失敗を防ぐ構築手順まで解説します。
法人向けAI研修
AX CAMP 無料資料
AIによるデータクレンジングとは?基礎知識と手作業との違い
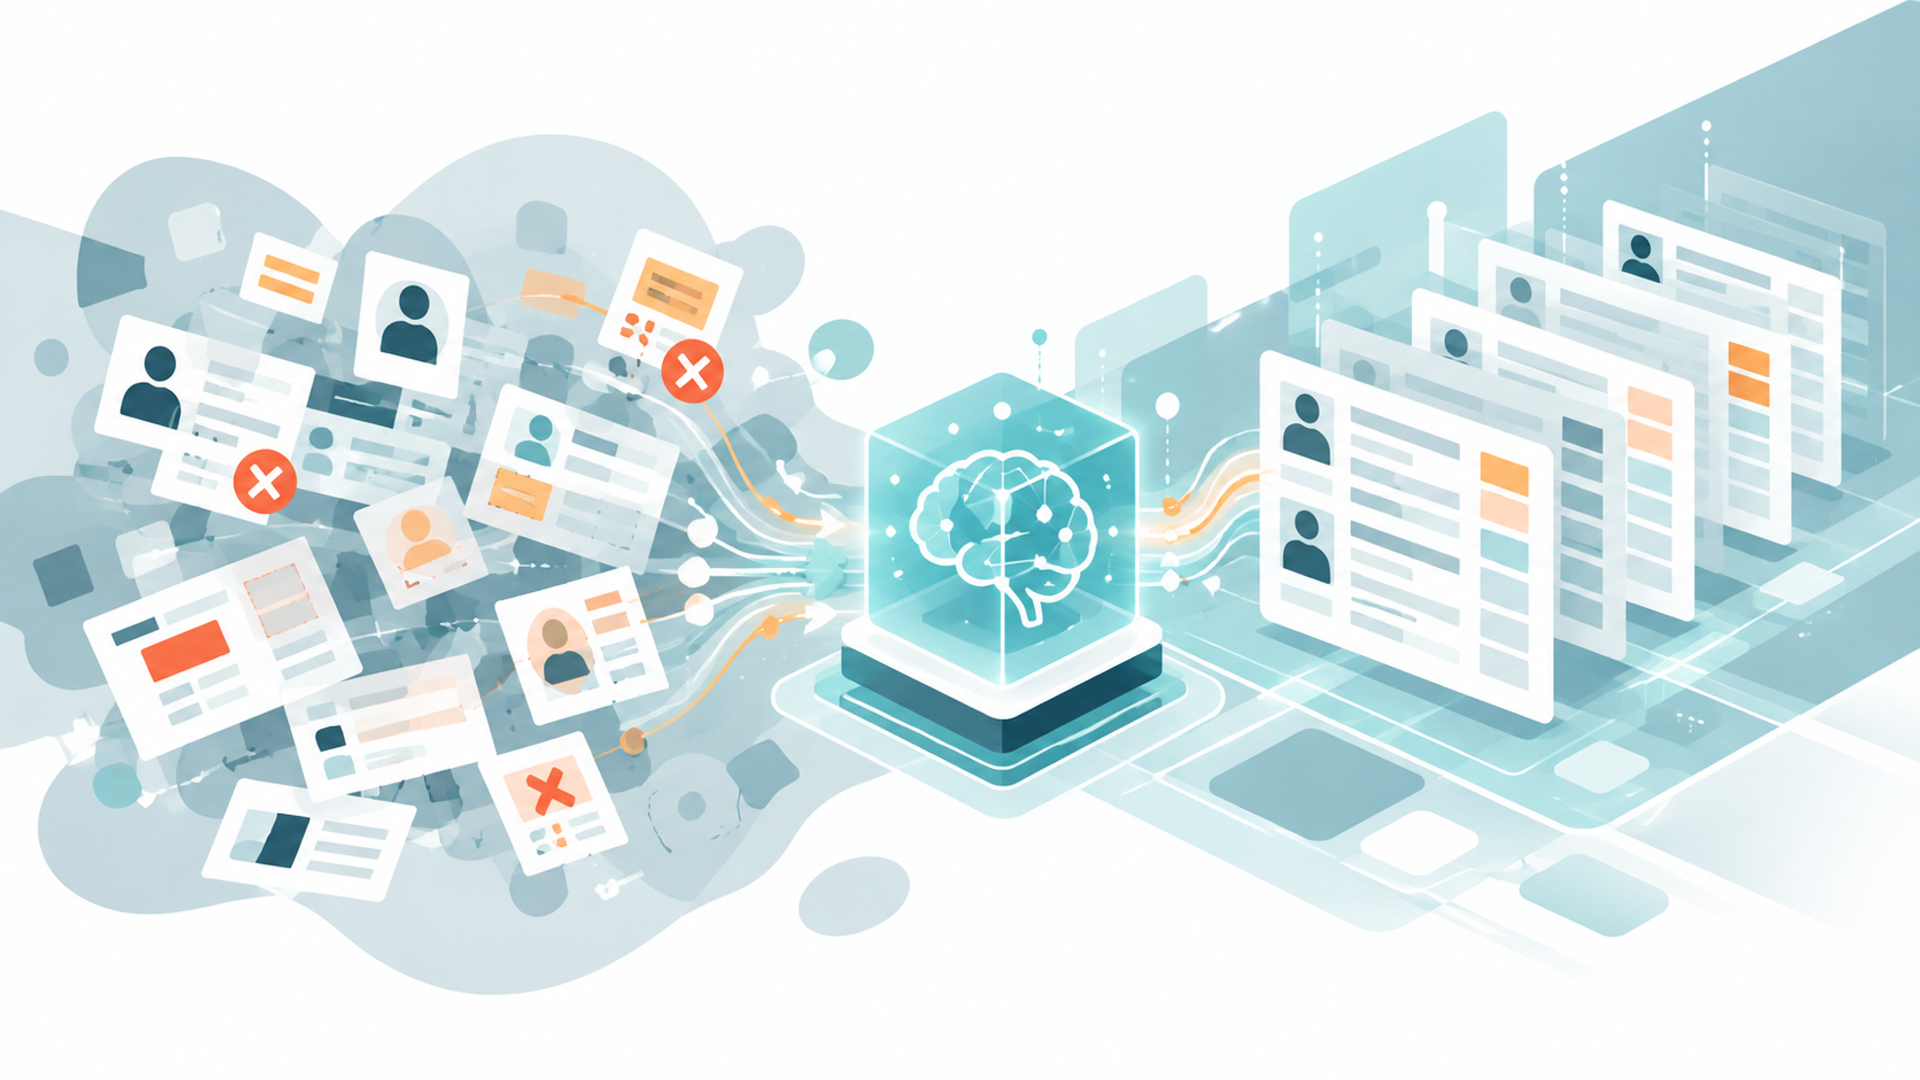
データベース内に混在する誤り、重複、表記ゆれの検出や修正を、人工知能で支援する技術を指します。目視確認やExcel関数による処理と組み合わせ、ルールだけでは扱いにくい曖昧な表記の判定などを効率化します。対応範囲や精度は、製品と対象データによって異なります。
仕組みと処理の基本プロセス
自然言語処理(NLP)や機械学習を用いるツールでは、テキストや数値のパターン、文脈、関連属性を解析し、表記統一や同一データの照合候補を提示します。実際の処理では、あらかじめ定めた変換ルールや参照データベースとの照合を併用する場合もあります。
基本プロセスは、データの傾向や不整合を把握するプロファイリング、修正候補の作成、検証、承認した結果の反映という流れです。精度はルール・モデル・入力データ・検証体制に依存します。継続学習に対応した製品や、評価結果を基に再学習する運用では改善を図れますが、すべての製品が運用中に自動学習するわけではありません。
手作業やExcel処理との決定的な違い
目視確認は担当者が業務上の事情や例外を判断しやすい反面、確認対象の増加に伴い作業負担が膨らみます。全角半角の統一や完全一致による重複検出といった条件を厳密に定義できる処理には、Excel関数やマクロを用いた自動処理の導入が効果的です。
AIによる推定は、表記が一致しないデータや文脈を含む文章の判定を支援します。ただし、処理時間は件数だけでなく、項目数、データ構造、照合方式、実行環境、人による確認範囲によって変わります。目視、ルールによる自動化、AIによる推定を使い分け、修正候補の確認まで含めて比較することが大切です。
2026年にAIデータクレンジングが注目される背景
社内文書やデータベースと連携して回答を生成するRAG(検索拡張生成)では、参照データの誤りや古い情報がそのまま回答精度を低下させます。データ整備による精度向上に加え、検索方式の最適化や出力制御、人間の目による事前検証を組み合わせて運用を設計します。個人情報の扱いについては個人情報保護委員会の生成AIサービス利用時の注意喚起を、著作権リスクに関しては文化庁のAIと著作権を事前に把握しておくと安心です。
企業のDX推進に伴い、複数システムに点在するデータを横断活用する機会が急増しています。データ形式や更新ルールを揃える際は、AIを活用した自動処理と人による最終チェックを組み合わせた体制づくりが欠かせません。実践的なデータ活用の指針としては、独立行政法人情報処理推進機構(IPA)が提供する各種ガイドラインが役立ちます。
AIで自動化できる主なデータ処理機能
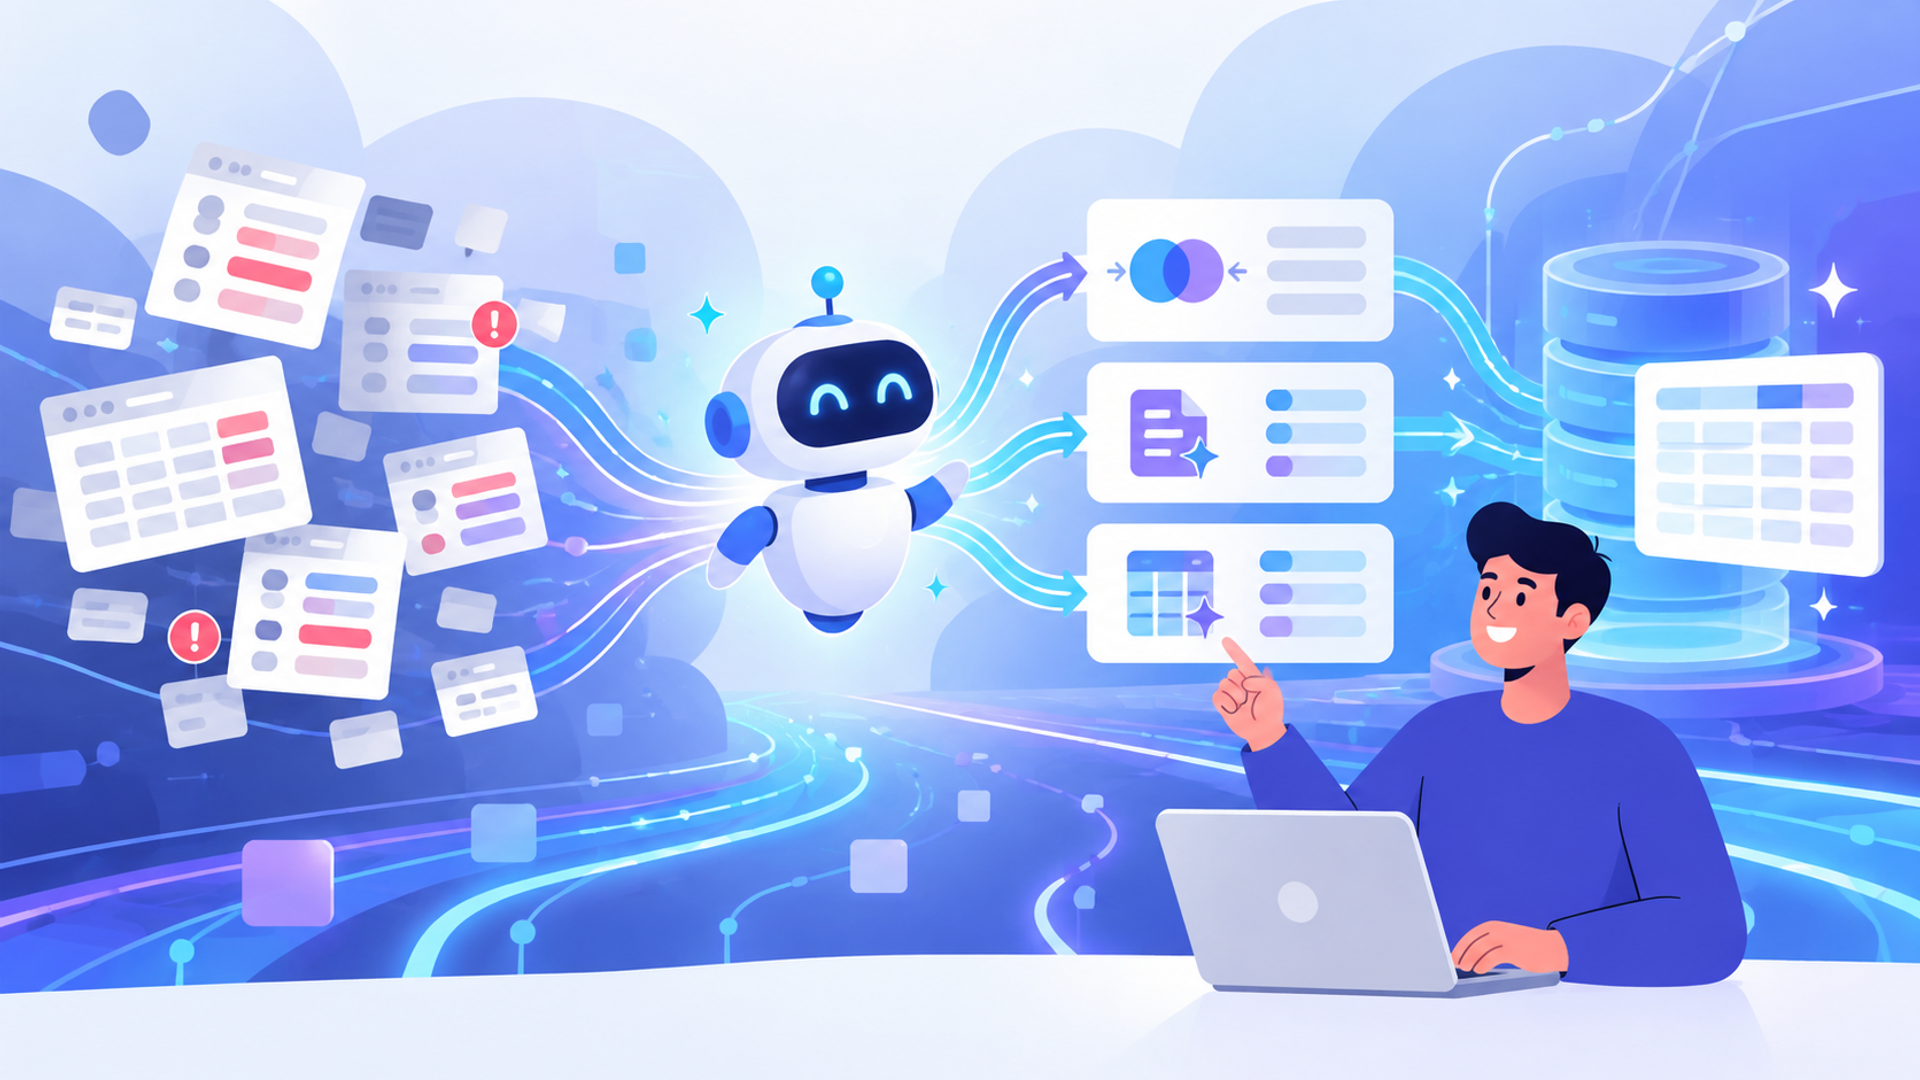
AIはデータの不整合検出や修正候補の提示に威力を発揮し、名寄せや表記統一、欠損値の穴埋めを円滑に進めます。ただし、外部データベース等の事実に基づき補完する処理と、統計的に推測する処理を明確に分け、業務インパクトの大きさに合わせて段階的な承認フローを設けてください。
重複データの自動検出と名寄せ処理
企業データベース内に存在する「同一の人物」や「同一の取引先」の情報を識別し、統合する処理が名寄せです。AIを用いる方式では、名前の漢字・カナ表記、電話番号、住所などを照合して候補を評価します。類似度スコアの尺度は製品ごとに異なり、パーセンテージで表示されても、そのまま同一性の確率を意味するとは限りません。
例えば「株式会社AX」と「(株)AX」、「東京都渋谷区1-2-3」と「東京都渋谷区一丁目2番3号」のような表記ゆれを検知し、同一候補として提示させることが可能です。ただし、同名異人の法人や同居テナントが存在するリスクを考慮し、名称・住所の類似度のみで即座に名寄せを行わないよう配慮してください。誤検知の防止策を講じた上で運用することで、営業アプローチの重複や案内メールの不達を未然に防げます。
表記ゆれや全角半角の統一
全角・半角の混在や和暦・西暦の表記ゆれ、ハイフンの有無といった規則的な差異は、条件式や正規表現を用いた一括変換で手際よく整理します。一方、文脈に依存する複雑な表記にはAIによる修正候補の自動抽出が有効です。AIによる推測変更を行う際は、固有名詞の誤変換や本来の文脈が損なわれていないかを忘れず精査してください。
住所の番地分けや電話番号の区切り方など、自社の管理基準を定めて変換処理に反映します。統一された形式を維持することで、基幹システムやCRMとの連携時に生じる形式不一致のエラーを減らせます。
欠損値の補完と異常値の不整合検知
空白項目(欠損値)を補う際、顧客マスタでは郵便番号や信頼できる企業データベースなど、参照情報による照合を優先します。AIで年齢層や都道府県を推定しても、本人・企業の事実を確認したことにはなりません。分析目的で推定値を利用する場合は原値を残し、別項目に推定値、推定フラグ、補完方法、参照情報や根拠を記録してください。
また、「電話番号の桁数が規定外」「売上金額がマイナス表記」「年齢が200歳」などの異常値を自動抽出し、人的確認が必要なデータとしてリスト化できます。もっとも、マイナスの売上数値は返品処理等の正当な取引に基づくケースもあるため、数値の異常さだけを根拠に即時除外するのではなく、元の取引伝票や現場の処理手順に照らして真偽を確かめる手順が求められます。
法人向けAI研修
AX CAMP 無料資料
効果を最大化できるデータ領域と活用シーン
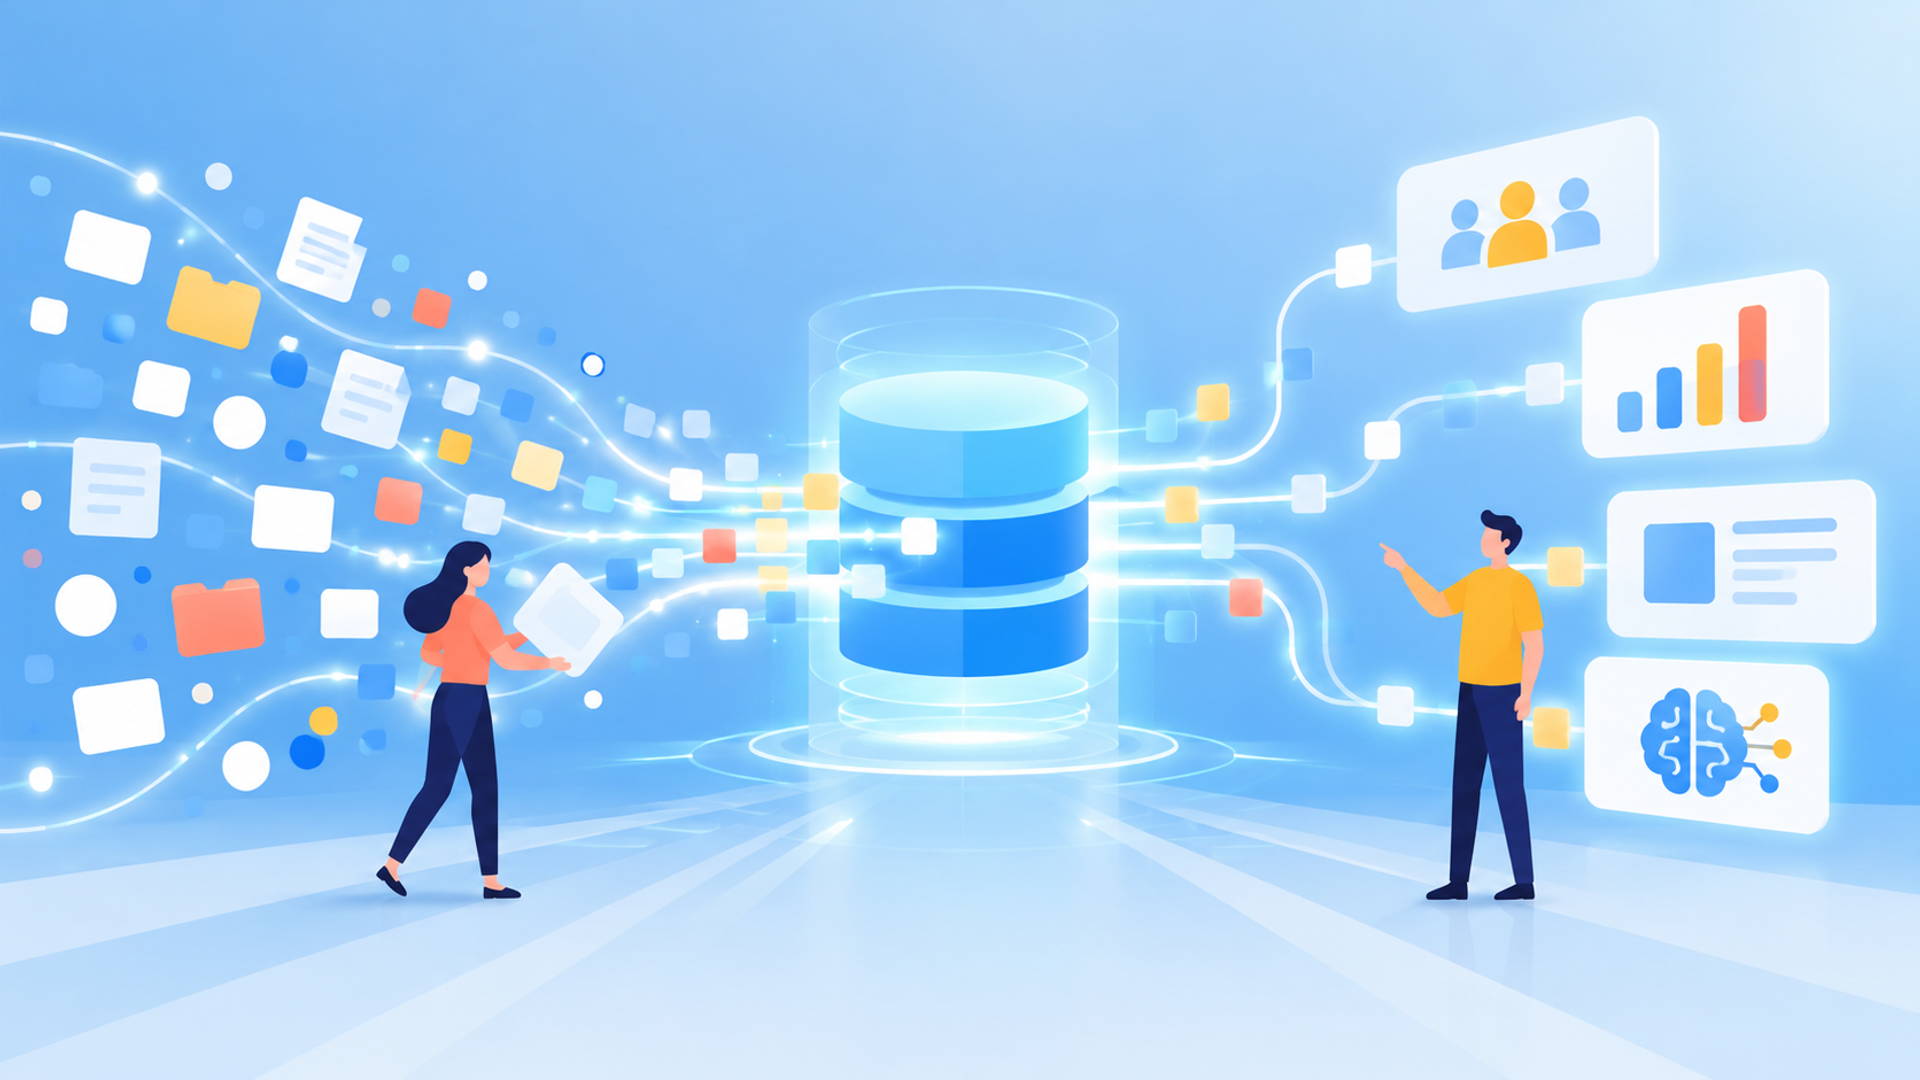
これらの整形手法を組み込むことで、情報が散逸しがちな顧客データベースや社内ナレッジをスムーズにクレンジングできます。データ利用目的に合わせた前処理を徹底すれば、アプローチの重複による営業ロスを防ぎ、社内AIエンジンが参照する情報資産の質を底上げすることが可能です。
SFAやCRMなどの顧客・営業データ
営業活動の土台となるSFA(営業支援システム)やCRM(顧客管理システム)には、手入力ミスや多角的な流入チャネルに起因する重複・表記ゆれが混入しがちです。取り込んだ名刺情報やWeb問い合わせデータを精緻にクレンジングし、アプローチすべき見込み顧客の情報を常に正確な状態へ保つ運用が成果に繋がります。
データ取り込み時の自動化パイプラインを組むことで、名寄せ候補のスクリーニングや企業属性情報の自動補完をバックグラウンドで実行させます。商談・契約履歴を正しい顧客レコードへ正確に統合できるよう、一意の識別子と名寄せ基準を定義すると同時に、誤紐づけを速やかに検知・リカバリーできるチェック工程を組み込みましょう。
BI分析や生成AIのRAGで利用するデータ
BIツールのダッシュボード上で経営指標を可視化する場合、データ形式や集計軸の不揃いは誤った意思決定を引き起こすリスクがあります。商品カテゴリや顧客名の表記ゆれ・重複登録は売上集計の数値にズレを生じさせるため、ダッシュボード化に着手する前段階でのデータ標準化が不可欠です。
社内FAQや業務マニュアルを生成AIに参照させるRAG構成では、誤字脱字や重複文書、古い情報の整理が有効です。原文の意味や更新日、参照元を保持しながら整備し、検索結果と回答が業務上正しいかを併せて検証しましょう。
ツール導入で得られる3つのメリット
専用ツールを活用すると、繰り返し発生するデータ整備を効率化し、分析業務へ時間を振り向けやすくなります。人による確認が必要な範囲を定め、処理ルールと評価方法をそろえることが効果を得るための前提です。
1. データ前処理工数の大幅な削減
データ前処理は、抽出・形式変換・結合・クレンジングといった複数のステップを経て完了します。このうち、表記統一や重複探知などの定型化しやすい反復作業をシステム化できれば、作業工数の大幅な圧縮につながります。実際の削減幅は、既存データの乱れ具合や手動確認を要する割合によって変化します。
効果を測る際は、同じ対象データと作業範囲で、修正候補の確認や再処理を含む導入前後の所要時間を比較します。削減した時間を、分析結果に基づく施策の立案や新規事業の企画などへ振り向けられれば、データ整備を業務改善につなげられます。
2. 人的ミスの削減によるデータ品質の安定
手動によるデータクレンジングでは、作業者によって表記整形の解釈や例外処理の判断に不揃いが生じがちです。複数名のチームで作業を進める際は、事前に表記統一ルールと例外ハンドリング手順を明文書化し、作業品質を一定レベルに保つ工夫が求められます。
ツールで共通のルールを適用すれば、入力ミスや処理漏れを減らせます。一方で、誤ったルールやAIの誤判定を大量のデータに適用する可能性もあります。品質はモデルやデータ、検証体制に依存するため、変更履歴の保存と定期的な監査を組み合わせて維持しましょう。
3. 分析結果およびAI回答精度の向上
「Garbage In, Garbage Out(不適格なデータからは不適格な結果しか生じない)」という原則の通り、分析モデルや生成AIへ与えるデータの不備はアウトプットの精度を直ちに損ないます。重複レコードやノイズの事前除去は、AI利活用や高度な分析を行うための必須要件と言えます。
データの品質向上は、マーケティング施策のターゲット抽出や売上予測、生成AIの回答改善を支える要素です。ただし、精度にはモデルや検索方法、評価データも影響します。クレンジング前後で業務に必要な指標を測り、実際の改善を確かめましょう。
導入前に押さえておくべき注意点とリスク
システム導入を円滑に進めるには、自動クレンジング後の出力内容を現場担当者がサンプリング検証するガバナンス体制を確立しておきましょう。同時に、個人情報や極秘データを扱う際に遵守すべきセキュリティ基準やアクセス権限制御の設計も事前の整理が不可欠です。
人間による定期的な検証と確認体制の確保
AIは、固有名詞や特殊な文脈を誤って補正する場合があります。出力を過信して100%全自動で本番環境へ反映すると、誤統合や情報の欠落につながる可能性があります。特に、顧客や契約の識別に関わる変更は慎重に扱いましょう。
人が判断に関与する「Human-in-the-loop(ヒューマン・イン・ザ・ループ)」を組み込み、正解ラベル付きデータで適合率・再現率・誤統合率を評価して閾値を決めます。適合率は統合すると判定した組み合わせのうち正しかった割合、再現率は本来統合すべき組み合わせを検出できた割合です。高スコアの結果も抽出監査し、原本、変更前後の値、判定理由を保存して、統合を戻せる手段を用意してください。
個人情報や機密データのセキュリティ管理
処理の過程で、個人情報や購買履歴、未発表データなどが外部のクラウド基盤へ送られる場合があります。料金区分にかかわらず社内で承認された環境を使い、入力データの学習利用、保存期間、削除方法、アクセス権限、委託先・再委託先、契約条件を確認してください。入力項目を必要最小限にし、必要に応じてマスキングも行います。
「モデルの学習にデータを利用しない契約方針」と「利用者が個別に学習利用をオプトアウトする設定」は明確に区別して評価する必要があります。例として、Anthropicの公式説明では、個人向けプランにおける学習利用の条件や例外措置が細かく言及されています。単に「学習に使用されない」という点だけに頼らず、通信の暗号化や権限管理、ログ監査体制、SOC 2報告書の評価範囲まで多角的に照合してセキュリティ設計を固めてください。
ツールを選定する際の比較ポイント
クレンジングツールを選定する段階では、自社データの保持形式や既存の基幹システム・各種データベースとの接続柔軟性をしっかりと検証してください。現場の業務ルールの更新に伴いデータ処理ロジックを容易に変更できるか、非エンジニアの担当者でも扱えるUI設計になっているかが運用定着の分かれ目となります。
対応可能なデータ種別と処理範囲の広さ
自社のデータがCSVやRDB上の「構造化データ」中心なのか、PDF、テキスト文書、ログなどの「非構造化データ」も含むのかによって、選ぶツールは変わります。顧客名簿の名寄せやテキスト分析の前処理など、目的を明確にすることが第一歩です。
| 比較軸 | 確認すべき具体的な内容 | 判断の目安 |
|---|---|---|
| 対応データ形式 | テキスト、数値、PDF、非構造化ログの対応可否 | 例えば対象データの8割以上への対応を社内の仮基準としつつ、業務上必須の形式・項目を優先して確認する |
| クレンジング機能 | 名寄せ、表記統一、欠損補完、外れ値検知の有無 | 業務上で最も課題となっている処理に対応しているか |
| データ容量上限 | 月間の処理レコード数やファイル容量制限 | 将来的なデータ量の増加に耐えうる拡張性があるか |
対応割合だけで判断せず、自社で頻繁に発生する不整合と、誤修正した場合の業務影響を踏まえて処理範囲を精査してください。
既存システムとの連携性と操作のしやすさ
運用中のSFAやCRM、CDP、データウェアハウス(DWH)とスムーズにデータ連携できない場合、手動でのインポート・エクスポート作業が新たな業務負荷となります。APIを用いた自動同期機能や標準コネクタの対応状況だけでなく、同期可能なデータ項目、実行スケジュール、エラー発生時のアラート通知・リトライ仕様まで網羅的に確認しておくと安心です。
現場スタッフが日常的に使う場合は、ノーコード・ローコードで操作できる範囲を確かめます。画面から設定できる処理と、SQLやコードが必要な処理を分けて評価し、運用担当者のスキルに合う製品を選びましょう。
おすすめの自動化ツール5選
データクレンジングを効率化する製品には、顧客データの統合、参照データによる補完、ETL、分析前の整形など、異なる得意分野があります。AIによる分析・推定と、設定したルールによる自動処理を区別して比較しましょう。
| サービス | 主な対象 | 特徴 | 確認ポイント |
|---|---|---|---|
| GENIEE CDP | BtoC・BtoB全般、マーケター | ID名寄せ・顧客データ統合と、AIによる分析支援 | 利用できる識別子、統合ルール、連携先、分析機能の範囲 |
| uSonar | BtoB企業の営業・マーケ部門 | 日本最大級の企業DB(LBC)による名寄せ・属性補完 | 対象企業の収録範囲、識別単位、補完項目、SFA連携 |
| Sansan Data Hub | 顧客データ整備、営業DX推進担当 | 顧客データの名寄せとSOC・属性情報の付与 | 連携対象、付与項目、更新条件、名寄せ結果の確認方法 |
| TROCCO | データエンジニア、データ分析担当 | ETL・ELTとワークフローによるデータ処理の自動化 | 標準変換の範囲、SQL・コードの必要性、品質チェックの設定 |
| Tableau Prep | BIユーザー、データアナリスト | 視覚的なフロー操作によるデータ整形と類似値のグループ化 | 対象言語、グループ化方式、結果確認、Tableauとの連携 |
1. GENIEE CDP|名寄せとデータ統合の自動化
GENIEE CDPは、分散した顧客データを統合・一元管理し、マーケティング活動での活用を支援するプラットフォームです。公式製品ページでは、複数の顧客接点を同一人物に紐づけるID名寄せ・統合と、ノーコードのデータ連携が紹介されています。
AIが担う機能としては、自然言語を用いたデータ分析や示唆の提示が案内されています。名寄せ時に使う識別子や統合条件、例外の扱いは導入時に確認し、自社の顧客情報や行動ログに合う設計を行いましょう。
2. uSonar|高品質な企業データベースによる自動補完
uSonar(ユーソナー)は、日本最大級の法人企業データベース「LBC」を活用する顧客データ統合ソリューションです。公式機能ページでは、LBCを辞書としたクレンジング・名寄せ、属性情報の補完、企業情報の自動更新が紹介されています。
保有する顧客データベースを企業や拠点単位で紐付け直し、売上規模や事業拠点などの外部属性を付与して営業マーケティングを強化したい現場に好適です。データ付与が可能な項目範囲や組織変更・社名変更・拠点移転時の追従精度、SFA/CRM連携の要件を精査した上で、一致する企業が見つからなかった未照合データのハンドリング手順も事前に定めておきます。
3. Sansan Data Hub|AIを活用した顧客データのクレンジング
Sansan Data Hubは、Sansan株式会社が提供する顧客データの統合・クレンジングソリューションです。公式機能ページでは、SFA・CRMやMAに蓄積された顧客データを取り込み、名寄せや属性情報の付与を行う仕組みが説明されています。
特定できた企業には、Sansan独自の企業識別コード「Sansan Organization Code(SOC)」を付与し、顧客データの名寄せや統合を支援します。SOCはTDBの企業コードとは別の識別子です。利用できる属性や更新条件は、公式の連携項目一覧と契約内容を確認してください。
4. TROCCO|ETLと連携した効率的なデータ運用
TROCCO(トロッコ)は、分散するデータソースからの自動転送やDWH内での加工・集計処理を一元化するデータパイプラインサービスです。標準コンポーネントで解決できる単純な文字列置換と、SQLやスクリプトを記述して処理する高度な補完・重複排除ロジックを切り分けて設計すると効率的です。具体的な実装手順や標準機能の適用範囲については、公式のデータ加工ガイドで詳しく解説されています。
ワークフローデータチェックは、利用者が記述したSQLクエリの結果とエラー条件を照合する機能です。重複などを検出できますが、検査自体がデータを自動修正するわけではありません。転送・加工・検査を組み合わせて運用し、AIによる推定補完とは区別して評価しましょう。
5. Tableau Prep|直感的なUIによるノーコード前処理
Tableau Prepは、「Tableau」製品群のデータ準備ツールです。データの構造や分布を視覚的に確認しながら、結合、フィルター、値の編集、表記の整理などを行えます。操作範囲は公式のクリーニング機能ガイドで確認できます。
類似値のグループ化には、読み方、共通する文字、スペルなどに基づくアルゴリズムが用意されています。読み方による方式は英単語に適するなど、方式ごとに対応条件が異なります。候補を確認し、誤ったグループ化を調整してから適用することが重要です。
導入を成功させるための実践手順
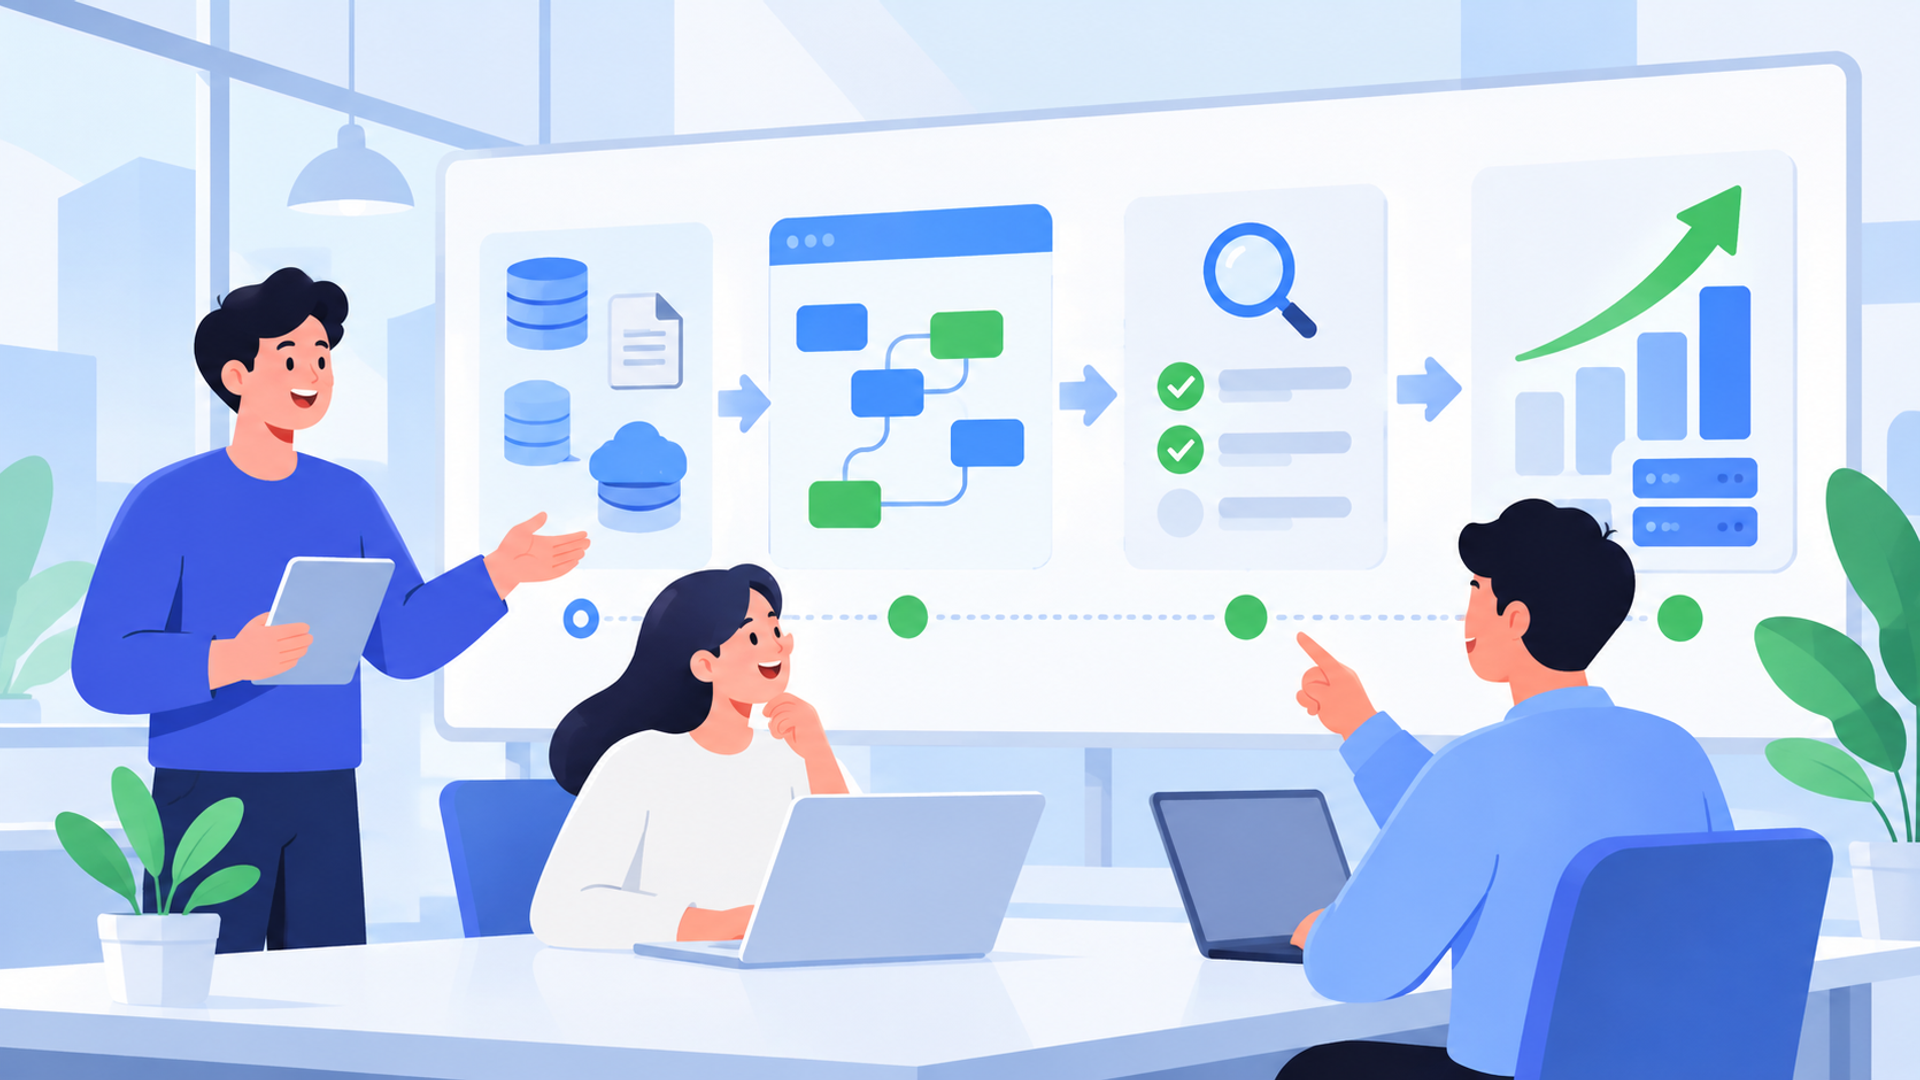
導入時は、自社のデータ課題を具体化した上で、小規模なPoC(概念検証)から試しましょう。工数と品質の両面で結果を評価し、変換ルールや確認範囲を調整してから展開します。
ステップ1:対象データの現状把握と目的の設定
ツール選定の前に、自社データのどこに、どのような不整合があるかを棚卸しします。定量目標の設定例として、「SFAの名寄せ適合率を95%以上にする」「BIダッシュボード更新の前処理時間を70%削減する」といった仮目標が考えられます。これらは導入成果や推奨基準を示す数値ではなく、現状と業務影響を踏まえてPoCで妥当性を判断するための例です。
適合率は、統合すると判定した組み合わせを分母にして正解ラベルと比較します。再現率と、統合判定のうち別顧客を誤って統合した割合も併せて測り、見逃しと過剰統合を評価してください。時間削減率は導入前の所要時間を分母とし、同じ件数・項目・処理工程で、人による確認や手戻りを含めて計測します。まずは「営業部門の顧客マスタのみ」「Web問い合わせログのみ」のように範囲を絞りましょう。
ステップ2:PoCによる精度検証と本番運用への展開
対象業務を代表するデータを抽出し、正解ラベル付きの検証用データを用意します。数千件〜数万件程度を試す場合も、件数だけで十分と判断せず、同名の別法人や欠損の多いレコードなど、誤判定しやすいパターンを含めてください。閾値調整に使うデータと、最終評価に使うデータを分け、適合率・再現率・誤統合率を確認します。
誤判定が多いパターンには、照合ルールやプロンプトの調整、除外条件の追加、人による確認を適用します。高スコアの結果も監査し、原本保存、変更履歴、統合を戻す手順を検証した後、対象範囲を段階的に広げて定期連携へ移行しましょう。
業務効率化と精度向上を実現した活用事例
公開事例では、顧客データ整備の工数削減や、自由記述を分析しやすい形に整理する取り組みが紹介されています。以下では、データクレンジングの導入事例と、テキスト分析の関連事例を取り上げます。
事例1:顧客データの名寄せによる営業効率化
NECソリューションイノベータ株式会社は、デジタルマーケティングで活用する顧客データの品質向上に取り組み、Sansan Data Hubを活用しています。データを整備・補完し、顧客との接点を把握して営業・マーケティングに活かす取り組みです。
Sansanの公開事例では、データクレンジング・補完作業の月間工数が35時間から12時間になったと紹介されています。これは同社の対象業務における比較であり、重複レコードの削減率や営業調査時間の削減率を示す数値ではありません。自社で効果を測る際も、対象件数、比較期間、補完項目、人による確認範囲をそろえましょう。取り組みと成果はSansan公式資料のNECソリューションイノベータ事例で紹介されています。
事例2:アンケートの自由記述の自動分類による分析スピード向上
東京電力エナジーパートナー株式会社では、組織診断アンケートの自由記述を分析する業務に生成AIを活用しています。業務パートナーのブレインパッドが公開した当事者による事例記事では、カテゴリの定義、回答の分類、部門ごとの課題の要約や対策案の作成が紹介されています。
この取り組みは、自由記述を活用可能な情報へ整理する関連事例です。処理工程を分解し、中間結果を人が確認して指示を調整することで、管理者が課題や要点を捉えやすい出力を目指しています。元の回答を参照できる仕組みも含め、AIによる分類と人による確認を組み合わせる設計が参考になります。
データクレンジングに関するよくある質問(FAQ)
導入を検討する段階では、生成AIで対応できる範囲や必要なITスキルに迷うことがあります。利用条件や運用上の役割を整理し、ツール選定と社内調整を進めましょう。
Q1. 無料の生成AIでもデータクレンジングは可能ですか?
ChatGPTやClaudeなどの生成AIサービスでは、利用できる機能や上限の範囲内で、テキストの整形やCSVの表記統一を試せる場合があります。例えば数千字程度の機密性のないサンプルについて、「表記ゆれを直し、JSON形式で出力してください」と指示し、原文との対応や誤修正を確認する方法があります。
数万件規模のデータや定期処理では、対象の容量・件数・処理方法に応じて、API連携や専用ツールを検討します。機密情報の利用可否は無料・有料で判断せず、社内で承認された環境の契約・設定を確認してください。Claudeの公式データ利用説明のように、学習利用の条件はサービスごとに確認が必要です。APIや企業向けプランでも、保存・削除、アクセス権限、委託先、社内規程を確認してから利用します。
Q2. データクレンジングとデータクリーニングの違いは何ですか?
実務では、「データクレンジング」と「データクリーニング」はほぼ同義で使われます。どちらも、データ内の誤り、重複、表記ゆれ、不整合を検出し、用途に応じて修正・整理する作業を指します。
ただし、名寄せや属性補完まで含むかなど、用語が指す範囲は製品や資料によって異なります。導入時は名称だけで判断せず、対象工程と処理内容を具体的に確認しましょう。
Q3. 専門的なプログラミング知識がなくても導入できますか?
画面操作でデータ整形や連携ルールを設定できるツールもあります。PythonやSQLを書かずに対応できる範囲は製品によって異なるため、自社で必要な処理を実際のサンプルで確かめることが大切です。
複雑な名寄せ、独自の品質検査、既存システムとの連携では、エンジニアの支援が必要になる場合があります。現場担当者が設定・確認する範囲と専門担当者が支援する範囲を決め、研修や伴走支援を活用して運用体制を整えましょう。
AX CAMPなら現場成果から逆算したAIによるデータクレンジングを設計できます
データの不整合や表記ゆれを解消するには、ツールの導入に加え、自社の業務フローに合った運用設計が必要です。「どの段階でデータを整備し、誰が結果を確認し、どの意思決定に活かすか」を整理することが成果につながります。
株式会社AXが提供する法人向けAI研修サービス「AX CAMP」は、実践的なAI活用スキルを身につける完全オンラインの研修プログラムです。プログラミング不要でPCの基本操作から受講でき、14時間のeラーニングとAI化計画のプランニング、伴走支援を組み合わせて、実務への落とし込みを支援します。詳しくはAX CAMPのサービス案内をご覧ください。
半年〜年間の伴走支援では、AI顧問として業務課題の分解から活用方法の設計まで支援し、研修中に作成したAIツールをそのまま業務で活用できる状態を目指します。AIの業務活用に関する関連事例として、Route66株式会社では、従来は記事1本の原稿執筆に最大24時間かかっていた業務に対し、AIによる原稿出力が10秒になったと報告されています。10秒はAIの出力時間であり、人による確認や画像準備・挿入・装飾を含む記事制作全体の作業時間とは区別されます。
また、組織的なAI活用の関連事例として、株式会社JIMOSでは、役員・管理職から3段階で全社へ展開し、AI活用の土台づくりを推進しています。AX CAMPは研修の修了だけでなく現場で成果を出すことをゴールに、経営層から現場まで実践的なスキル習得と業務改善を支援します。


法人向けAI研修
AX CAMP 無料資料
まとめ:データ品質を高めてAI活用の成果を最大化しよう
AIデータクレンジングは、データの不整合や表記ゆれの検出・修正を支援し、企業のデータ活用を支える手段です。自社のデータ状態と業務目的に応じてツールを選び、効果と品質を検証しながら運用しましょう。
AIデータクレンジングを成功させるポイントを最後に改めて振り返ります。
- ルールによる自動処理とAIによる推定を使い分け、確認・手戻りを含めた前処理工数の削減を図る
- 名寄せは適合率・再現率・誤統合率を評価し、SFAやCRMでの重複対応を減らす
- BI分析やRAGの用途に合わせて、原文・参照元・更新情報を保持しながらデータを整える
- 人間の検証(Human-in-the-loop)、原本保存、変更履歴、復元手段とセキュリティ対策を用意する
- 小さなPoCから始め、同じ条件で工数と品質を比較してから展開する
質の高いデータは、AI施策やDX投資の効果を支える大切な資源です。まずは自社データの不整合と、それが業務に与える影響を把握するところから、データ整備を進めてみてはいかがでしょうか。
法人向けAI研修
AX CAMP 無料資料
