「社内にデータが散在していて、どこに何があるか分からない」「生成AIの利用が進む中で、機密データの漏洩リスクが心配」とお悩みではありませんか?膨大なデータを手作業で仕分けるのは、時間もコストもかかり現実的ではありません。
そうした課題の解決に役立つのが、AIによるデータ分類技術です。この記事では、AIデータ分類の仕組みやメリット、導入手順、自社に適した製品・サービスを選定するための判断基準を解説し、比較候補となる10件を紹介します。
法人向けAI研修
AX CAMP 無料資料
AIによるデータ分類の基本概念と重要性
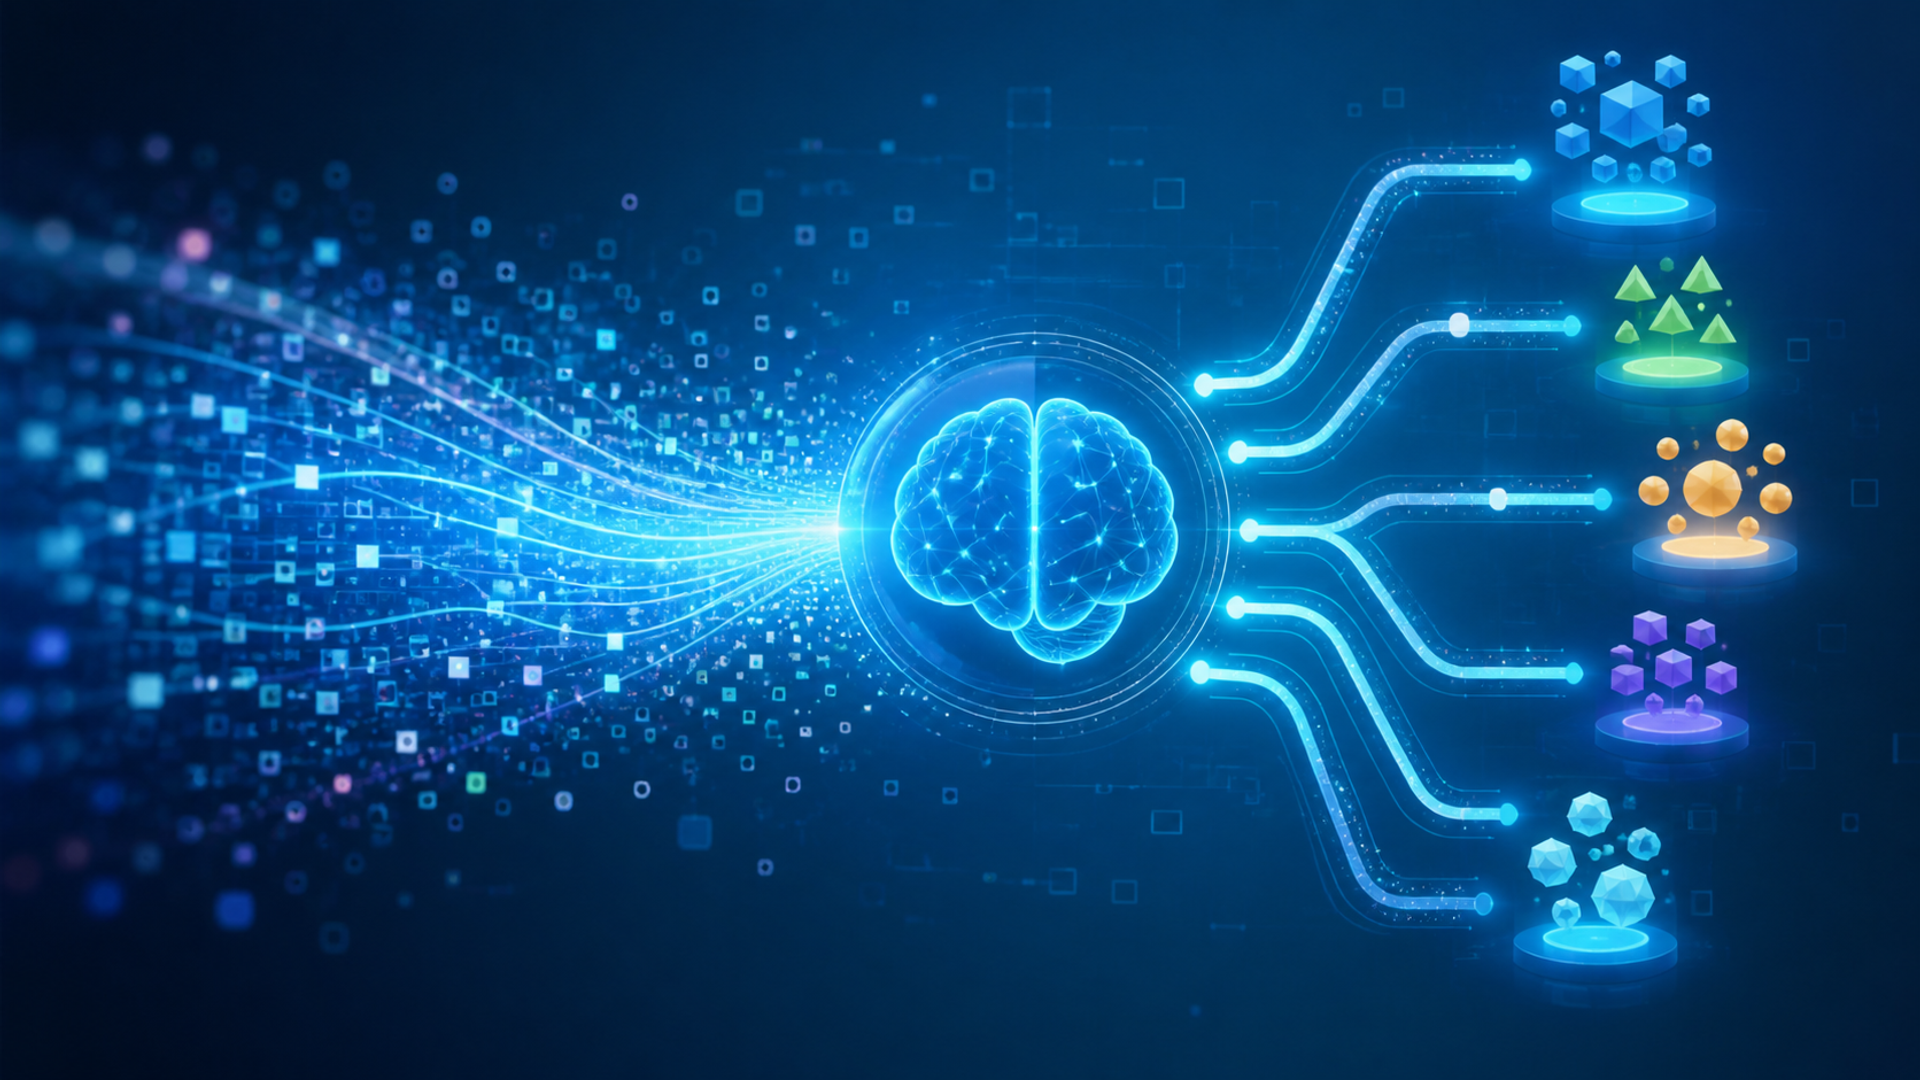
AIによるデータ分類とは、機械学習や自然言語処理を用いて、大量のデータを特定のルールやパターンに基づいて自動的に整理・グループ分けする技術です。従来のルールベースの分類では、人間が事前に細かな条件を設定する必要があり、データの増加や変化に対応しきれない場合がありました。
ただし、「データ分類」には、機械学習における分類問題と、企業の情報セキュリティにおける秘密度分類・ラベル付与という異なる文脈があります。後者の実務では、機械学習モデルだけで判定するとは限りません。ルール、正規表現、登録済みデータとの照合、OCR、固有表現抽出、文書分類器、秘密度ラベルなどを、対象データや業務要件に応じて組み合わせます。
企業が扱うデータの種類や保存場所が多様化する中、手動のみに頼るデータ管理は現実的ではありません。AIによるデータ分類を導入すれば、膨大なファイル群から機密情報に該当するデータを自動で検出し、効率的なラベリングが実現します。ただし、実際のアクセス制限や暗号化、送信遮断といった保護措置を機能させるには、DLPやアクセス制御など、周辺セキュリティシステムとのポリシー連携が前提となります。
特に、テキストファイルや画像、音声といった非構造化データが社内に散在している場合、AIデータ分類はその真価を発揮します。目視による仕分け作業を自動化に置き換えることで、法規制への準拠や管理工数の削減を同時に達成しやすくなります。なお、実際の処理時間や分類精度は、データの品質やファイル形式、採用するAIモデルの性能によって左右される点に留意してください。
データの自動分類における主な種類とアルゴリズム
データの自動分類を実務に適用するためには、その分類方法の種類と、背後で動くアルゴリズムの基本を理解しておくことが役立ちます。AIデータ分類には、目的やデータの性質に応じて複数のアプローチがあります。
ここでは、一般的な機械学習上の分類タイプと代表的な手法を解説します。企業の秘密度分類へ適用する場合は、これらを単独で使うのではなく、検出ルールやラベル管理などと組み合わせることがあります。
二項分類とマルチクラス分類の違い
二項分類(バイナリ分類)とは、対象となるデータを2つのグループのどちらかに振り分ける分類手法です。例えば、受信したメールが「スパムであるか、そうでないか」を判定するシステムや、文書について「機密情報が含まれる可能性があるか」を判定する分類器が該当します。後者では、分類器の判定だけで秘密度を確定せず、検出ルールや人による確認と組み合わせる場合があります。
一方、マルチクラス分類は、データを3つ以上のグループに分類する手法です。顧客からの問い合わせメールを「製品に関する質問」「料金に関する問い合わせ」「不具合の報告」「その他」のように、複数のカテゴリへ振り分ける業務が該当します。自社の業務プロセスで必要となる分類数や、複数ラベルの付与が必要かどうかを整理して使い分けます。
決定木やランダムフォレストなどの代表的手法
一般的な機械学習の分類を支えるアルゴリズムには、複数のモデルがあります。「決定木(デシジョンツリー)」は、データを条件分岐のツリー構造で分類する、判断過程を比較的把握しやすい手法です。ファイルの作成者や文書中の特徴などを入力データとして学習させ、カテゴリを予測する用途が考えられます。
決定木を複数組み合わせて予測する手法が「ランダムフォレスト」です。単一の決定木よりも過学習を抑えやすい場合がありますが、精度はデータの品質や特徴量、学習条件によって変わります。そのほか、二項分類で使われる「ロジスティック回帰」や、文書の文脈を扱う自然言語処理モデルなども、目的に応じて選択されます。
これらは汎用的な予測手法であり、機密文書の検出や秘密度ラベルの付与を単独で実現するものではありません。実務上のデータ保護では、正規表現、辞書、登録済みデータとの照合、OCR、固有表現抽出、文書分類器などによる検出結果を、組織の分類基準や秘密度ラベルへ対応付けます。
法人向けAI研修
AX CAMP 無料資料
自動分類システムを導入するメリット
AIデータ分類システムを導入することで、セキュリティの強化と運用の効率化を同時に追求する道が開かれます。ただし、分類されたデータを確実に保護するためには、事前に社内規定を整備し、既存のセキュリティツールとシームレスに連携させる体制構築が求められます。
具体的なメリットを、セキュリティ面と運用負担の軽減という2つの軸から整理して解説します。
セキュリティ強化と情報漏洩リスクの低減
個人情報や機密データをAIで高精度に検出し、DLPやアクセス制御ポリシーと連動させることで、不適切な持ち出しや誤送信を未然に防ぐ体制が整います。具体的には、ファイルサーバー内の顧客データや未公開の技術文書を検知し、付与された機密性ラベルに基づいて閲覧権限を自動制限する運用が有効です。なお、個人情報の取り扱いについては個人情報保護委員会の生成AIサービス利用時の注意喚起、著作権に関しては文化庁のAIと著作権に準拠した運用設計を進めてください。
データ分類やラベリング自体は、ファイルを直接暗号化したり送信を遮断したりする機能ではありません。DLPやIRM、アクセス制御といった保護ツールと組み合わせることで、初めて機密性に応じた一貫性のあるセキュリティ対策が機能します。また、AIによる判定は100%確実ではないため、定期的な目視監査や判定ルールのチューニング体制もあわせて準備しておきましょう。
データ管理の自動化による運用負担の軽減
これまで手作業で行っていたデータ分類やラベリングを自動化すれば、情報システム部門や各現場の運用負荷を大幅に削減できます。ただし、実際の処理スピードや削減効果は、対象となる文書のファイル形式やボリューム、適用するルールによって変動するため、まずは自社のサンプルデータを用いたPoC(概念実証)から着手することをおすすめします。
分類結果を検索や文書管理の仕組みに反映すれば、必要な情報を探しやすくなり、社内のナレッジ共有にも役立ちます。担当者が仕分け作業に費やす時間を減らし、分析や企画などの業務に集中しやすい環境を整えられます。

企業におけるデータ分類の基準と機密性レベル
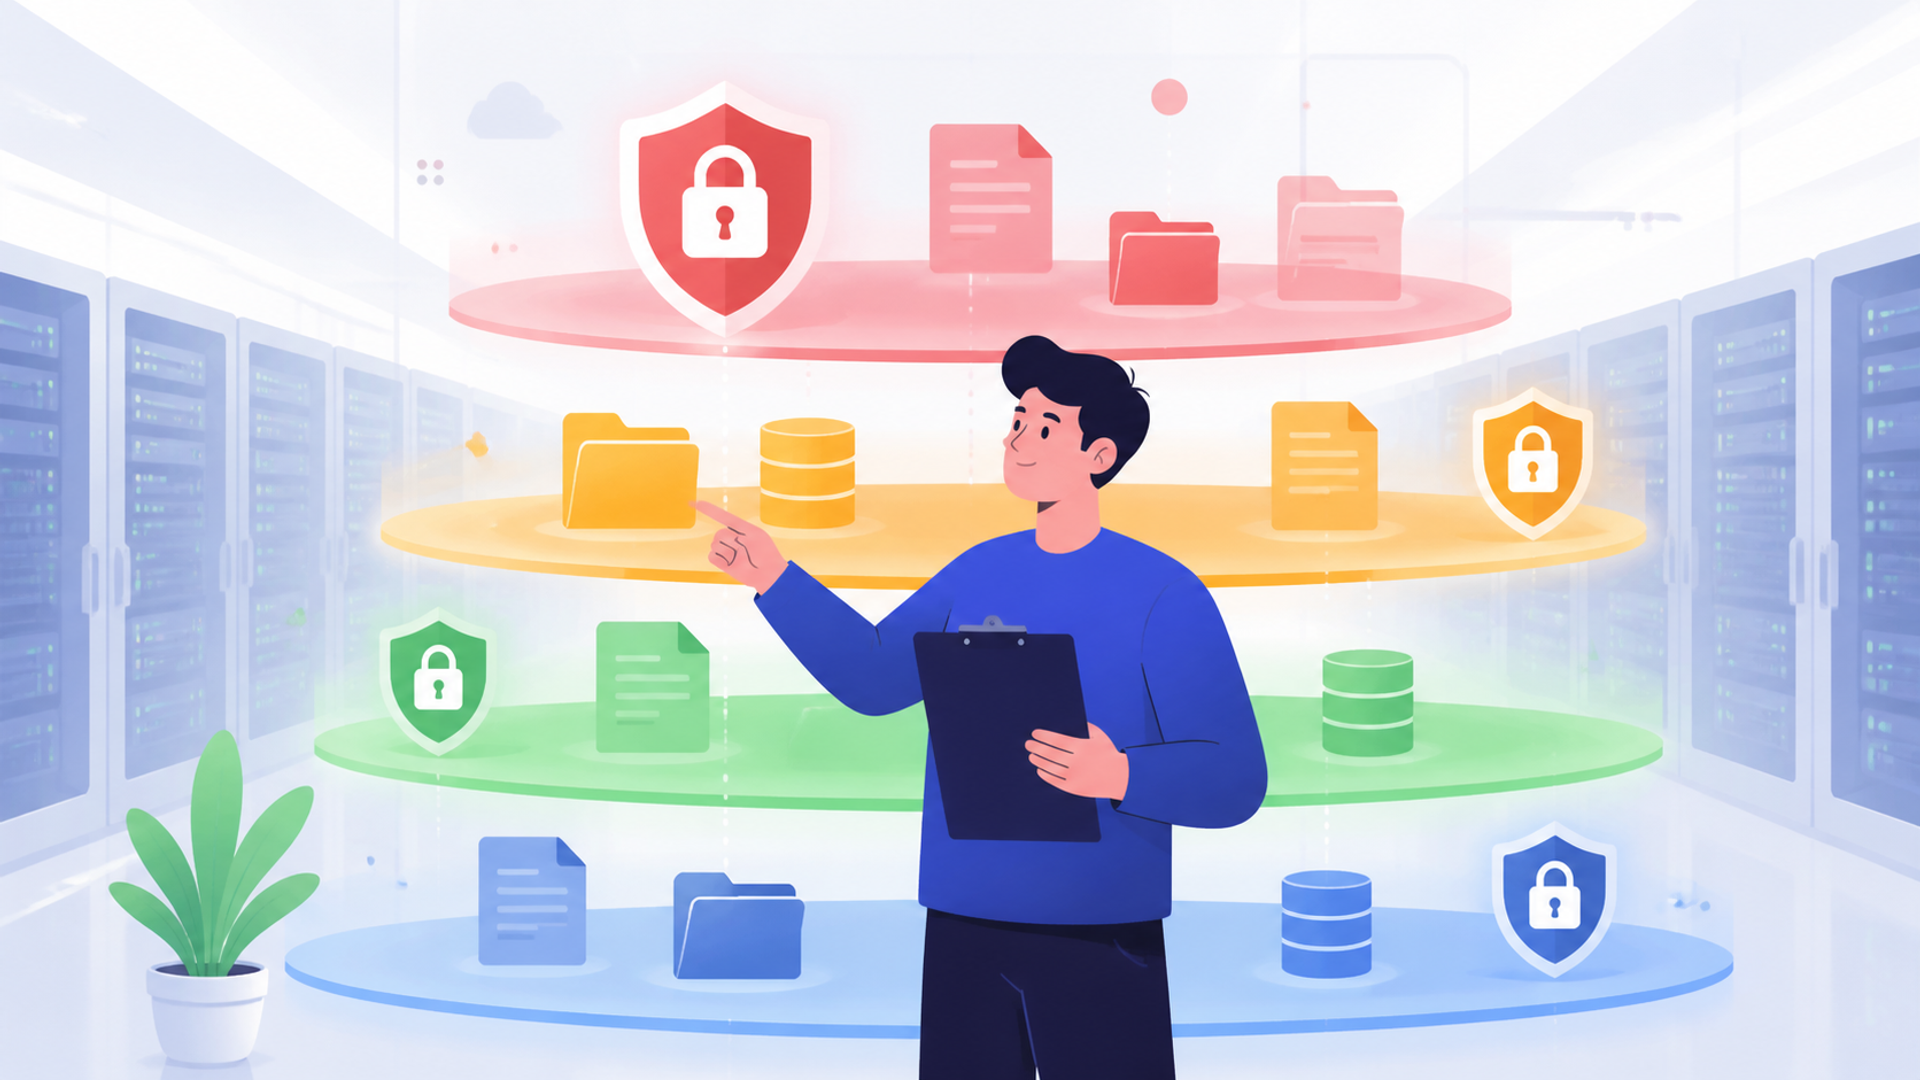
AIデータ分類の精度を高めるためには、あらかじめ社内における情報資産の定義や分類ルールを明確にしておくステップが不可欠です。この基準や学習用データが曖昧な状態では、AIを導入しても期待通りの分類結果を得ることは難しくなります。
企業では、業務やリスクに応じて、例えば以下のような3〜4段階の機密性レベルを定義します。名称や対象範囲は一律ではないため、自社の規程や法的要件に合わせて設計してください。
- 極秘(Strictly Confidential):漏洩した場合に経営や社会的信用へ重大な影響を及ぼすデータ。未公開の財務情報や重要な事業計画などが該当します。
- 社外秘(Confidential):社内の許可された関係者に限定して扱うデータ。顧客の個人情報、契約書、ソースコードなどが含まれます。
- 社内限り(Internal Use Only):一般公開を前提とせず、社内で利用するデータ。社内報や一般的な連絡事項などが該当します。
- 一般公開(Public):Webサイトやプレスリリースなど、社外への公開を前提としたデータ。
明確化した基準をAIモデルや判定ルールに落とし込むことで、新規ファイルが作成・保存された際に、機密性ラベルの候補を自動提示、あるいは自動付与する仕組みが実現します。なお、自動運用の適用範囲や制御の細かさは、選定するソリューションの仕様やライセンスによって異なる点に注意してください。
自動化プロセスを成功させるための実装手順
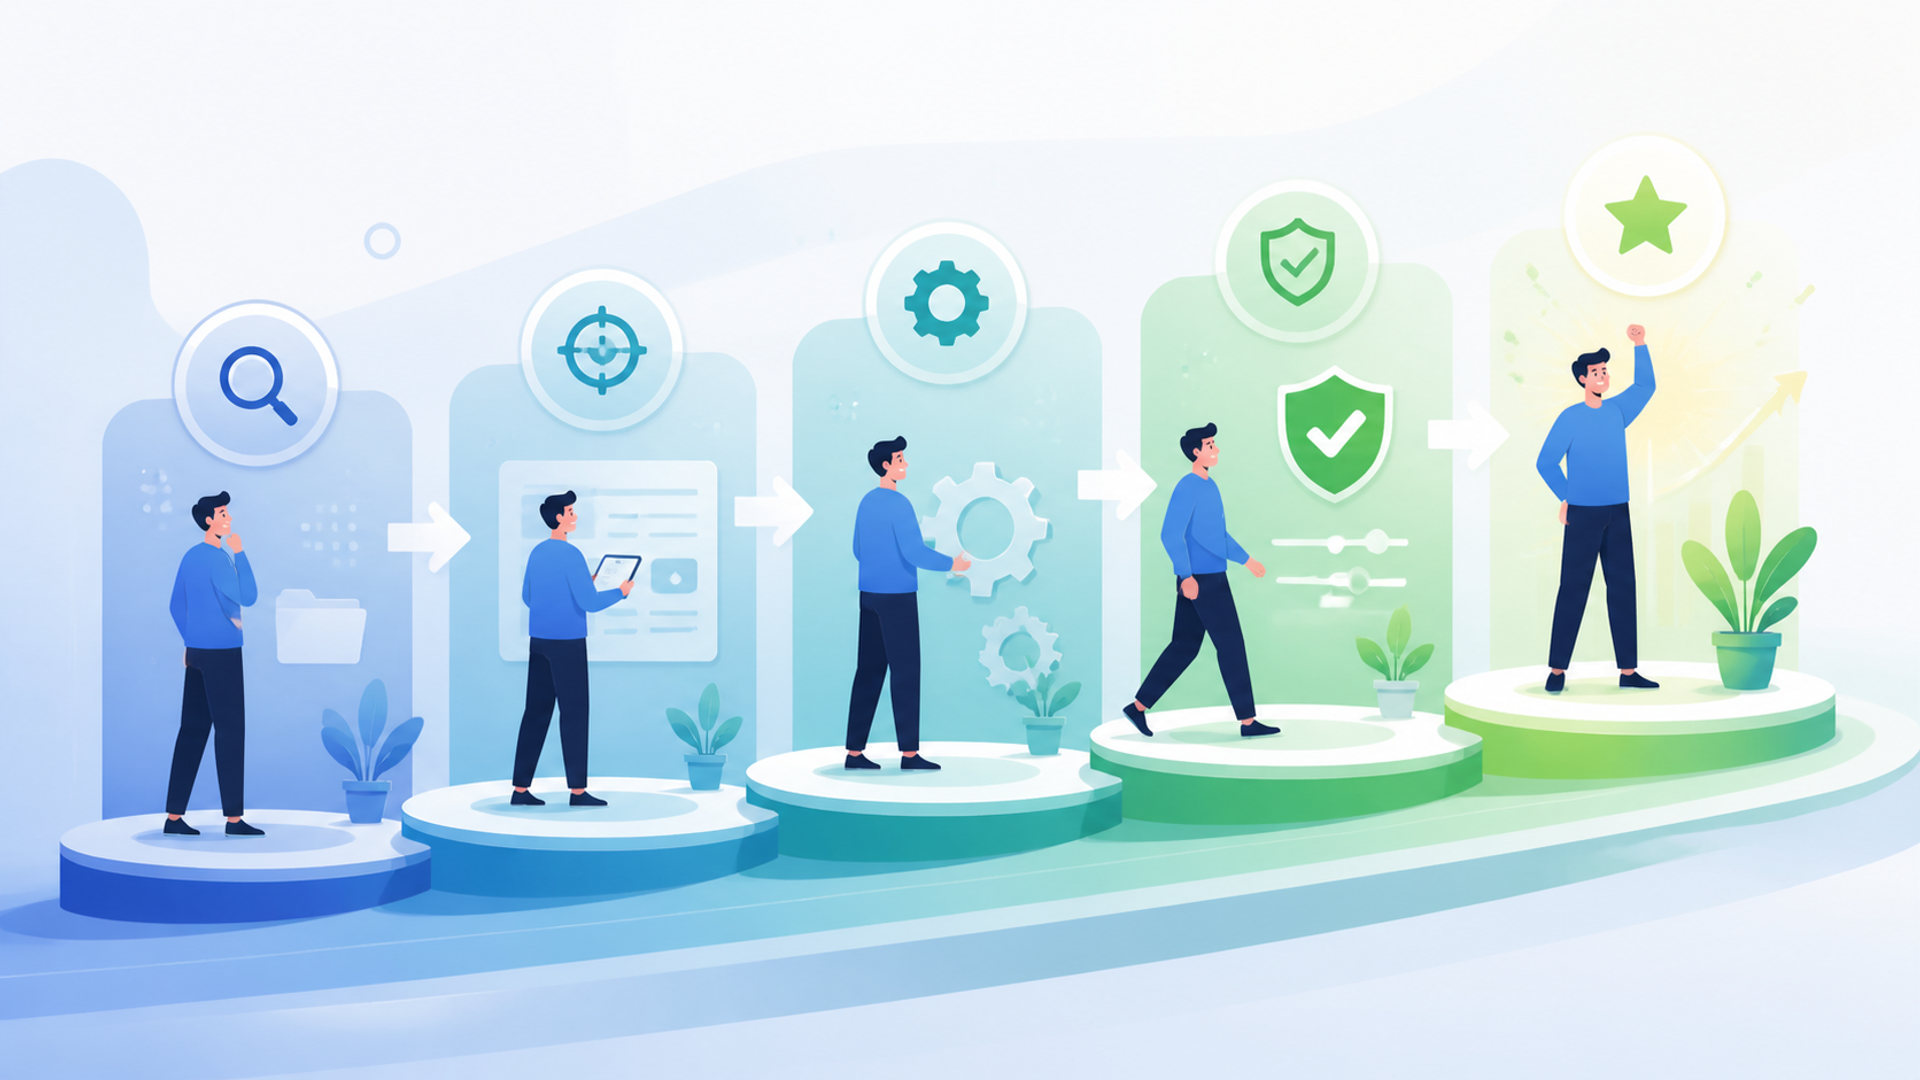
AIデータ分類を実務へ定着させ、運用の形骸化を防ぐには、スモールスタートによる段階的なアプローチが賢明です。まずは以下の5つのステップをベースに、特定の部門や一部のデータフォルダなど、影響の少ない範囲から検証を開始しましょう。
最初に「目的の定義」を行い、どのデータを何のために分類するのかを明確にします。次に、「データの検出とインベントリ作成」を行い、社内にあるデータの保存場所、種類、管理者などを整理します。
3つ目は「分類基準の設定とモデルの準備」です。機密性レベルに基づいてルールを作り、必要に応じてラベル付け済みの教師データを用意します。4つ目は「検証とテスト実行」です。適合率や再現率、誤検知、見逃し、業務への影響を確認します。最後に「継続的な見直しとチューニング」を行い、データや業務の変化に合わせてルールやモデルを更新します。

導入時に注意すべき課題と対策
AIデータ分類は有用な技術ですが、万能ではありません。分類精度の不足による誤検知や見逃しは、実務上の支障やセキュリティリスクにつながる可能性があります。
例えば、一般的な文書を「極秘」と過剰に判定すると、不要な閲覧制限が増えて現場の生産性を下げるおそれがあります。反対に、重要な個人情報を見落として「一般公開」と判定すれば、情報漏洩のリスクが高まります。
運用の精度を維持するうえで避けて通れないのが、人間による定期的な監査と、分類ルールやモデルの継続的なチューニングです。導入初期には、現場の業務プロセスを熟知した担当者とセキュリティ管理者が連携し、教師データの精度を高めていきます。AIの誤判定を人間が修正し、それを再学習にフィードバックする運用フローをあらかじめ設計しておきましょう。
データの保護と管理に役立つおすすめ製品・サービス10選
AIによる分類、秘密度ラベル、DLP、データガバナンス、文書検索などを支援する製品・サービスがあります。ただし、それぞれの目的や対象範囲は異なり、分類機能だけで暗号化やアクセス制御まで完結するとは限りません。
ここからは、導入検討時の比較対象となる代表的な製品・サービスを、プラットフォームに内蔵された分類機能を含めて10件紹介します。順位付けではないため、自社データの保管場所や保護要件、コストバランスを基準に選定を進めてください。なお、検討の最終段階では、各ベンダーが提供する最新の機能ロードマップやライセンス体系を直接確認することをおすすめします。
| 製品・サービス | 主な用途 | 分類との関係 | 確認ポイント |
|---|---|---|---|
| Palo Alto Networks Enterprise DLP | ネットワークやクラウドを横断したデータ損失防止 | 機密データの検出・分類結果をDLPポリシーに利用 | 対象チャネル、連携製品、導入構成 |
| Microsoft Purview | Microsoft環境を含む情報保護とデータガバナンス | 秘密度ラベルや分類子を保護ポリシーに利用 | ライセンス、対応アプリ、ラベルとDLPの設定 |
| Databricks Data Intelligence Platform | データ・AI基盤の管理とガバナンス | データ資産のカタログ化や管理を支援 | 既存基盤との連携、権限設計、運用体制 |
| IBM Watson Discovery | 文書検索、情報抽出、ナレッジ活用 | 自然言語処理を用いた文書の解析や分類を支援 | 対象文書、言語、検索・抽出要件 |
| Amazon Macie | Amazon S3内の機密データの検出と可視化 | 機械学習とパターン照合による機密データ検出を支援 | 対象がAmazon S3であること、リージョン、検出設定 |
| Google Cloud Sensitive Data Protection | 機密データの検出、分類、匿名化 | テキストや画像、対応するストレージ内のデータを検査 | 対象データソース、検出ルール、処理方法 |
| Snowflake | データ基盤内の機密データ分類とガバナンス | 機密データの分類結果をタグやマスキングに利用 | エディション、対象データ型、タグとポリシーの設計 |
| Oracle Data Safe | Oracle Databaseのセキュリティ管理 | データとメタデータを基に機密性のある列を検出 | 対象データベース、権限、機密データ型の設定 |
| Varonis Data Security Platform | 複数環境のデータセキュリティとガバナンス | 構造化・非構造化データなどの検出と分類を支援 | 対応データソース、ラベル連携、運用構成 |
| IBM Guardium Discover and Classify | 複数のデータソースに対する検出と分類 | 構造化・非構造化データに含まれる情報の発見と分類を支援 | 対象データソース、導入方式、必要な連携機能 |
1. Palo Alto Networks Enterprise DLP
Palo Alto Networks Enterprise DLPは、ネットワークやクラウド環境を横断して機密データを検出し、漏洩防止ポリシーを適用するソリューションです。データの内容やパターンをリアルタイムに解析し、不正な持ち出しの監視や制御を自動化したい場合に適しています。
導入設計にあたっては、保護すべきデータの所在と移動ルートを可視化し、既存のネットワーク機器やクラウド環境との連携可否を精査しておきましょう。なお、Precision AIは同社製品群に組み込まれているAI技術の総称であり、単体のデータ分類製品ではない点に留意してください。詳細な仕様はPalo Alto Networks Enterprise DLPの公式情報で確認できます。
2. Microsoft Purview
Microsoft Purviewは、データガバナンス、情報保護、DLPなどの機能を提供する製品群です。対応する環境では、機密情報の検出、秘密度ラベルの付与、分類結果に応じた保護ポリシーの適用を支援します。
Microsoft 365 Copilotを含む環境での保護動作は、既存のアクセス権、秘密度ラベル、暗号化、DLPポリシー、対応アプリ、ライセンス、管理者の設定などに依存します。ラベルを付けるだけで、あらゆる要約や外部出力が一律に防止されるわけではありません。導入前にMicrosoft Purviewの公式ドキュメントで適用条件を確認してください。
3. Databricks Data Intelligence Platform
Databricks Data Intelligence Platformは、社内のあらゆる構造化・非構造化データを統合管理するデータ・AI基盤です。データ資産のカタログ化やアクセス権限の一元管理、ガバナンス統制を組み合わせ、安全なデータ分析やAIモデル開発を進めたい組織に向いています。
本製品はDLP専用ツールとは設計思想が異なるため、情報漏洩防止を第一に掲げる場合は、自社が求める分類・制御要件を満たせるか事前に検証しておきましょう。導入によるガバナンス効果は、既存のデータ基盤や運用体制によっても左右されます。詳しい機能構成はDatabricks Data Intelligence Platformの公式情報をご参照ください。
4. IBM Watson Discovery
IBM Watson Discoveryは、高度な自然言語処理技術を用いて大量の文書を解析し、必要な情報の抽出や分類を自動化するサービスです。PDFやHTML形式で社内に埋もれているマニュアルや報告書から、価値あるナレッジを効率的に発掘・共有したい場面で力を発揮します。
主な目的は文書検索や分析であり、DLPや暗号化を中心とするデータ保護製品とは役割が異なります。対象となる文書形式、言語、分類要件、ほかのシステムとの連携方法を確認して選定してください。詳細はIBM Watson Discoveryの公式情報を参照してください。
5. Amazon Macie
Amazon Macieは、Amazon S3バケット内に保管されている機密データを自動で検出し、セキュリティリスクを可視化するマネージドサービスです。機械学習とパターンマッチングを組み合わせることで、個人情報などの重要データが含まれるオブジェクトを迅速に特定します。
スキャン対象が主にAmazon S3となるため、マルチクラウド環境やオンプレミスのファイルサーバーも一元管理したい場合は、他ツールとの併用や連携方法の設計が求められます。具体的な設定手順や仕様はAmazon Macieの公式ドキュメントで確認できます。
6. Google Cloud Sensitive Data Protection
Google Cloud Sensitive Data Protectionは、機密データの検出、分類、匿名化などを支援するサービスです。テキストや画像を検査でき、画像内の文字をOCRで認識してから分類する方法にも対応しています。
対応するデータソースやファイル形式、検出方法は処理方式によって異なります。利用時には、検出対象となる情報の種類、データの保存場所、検査結果に対して実行する処理を整理してください。詳細はGoogle Cloud Sensitive Data Protectionの公式ドキュメントを参照してください。
7. Snowflake
Snowflakeには、データウェアハウス内の機密データを自動検出し、適切なカテゴリやタグを付与する分類機能が備わっています。このタグ情報とマスキングポリシーを連動させることで、動的なデータ保護と高度なガバナンス統制を同時に実現します。
利用可能な機能や制限事項は契約エディションにより異なり、一部対応していないデータ形式も存在します。すでにSnowflakeを運用している、あるいは導入を計画している場合は、対象となるデータ型やマスキングルールの設計を事前によく確認しておきましょう。詳細はSnowflakeの機密データ分類に関する公式ドキュメントに記載されています。
8. Oracle Data Safe
Oracle Data Safeは、Oracle Databaseを対象としたセキュリティ管理サービスです。Data Discoveryでは、あらかじめ定義した機密データ型などを基に、データやメタデータを調査して機密性のある列を検出します。
主な対象はOracle Databaseであるため、自社のデータベース構成や登録条件、必要な権限を確認する必要があります。分類後に必要となるマスキングやアクセス制御についても、別途運用を設計してください。詳細はOracle Data Safeの公式ドキュメントを参照してください。
9. Varonis Data Security Platform
Varonis Data Security Platformは、クラウド、SaaS、データベース、ファイルなどに保存されたデータのセキュリティ管理を支援するプラットフォームです。AIとパターン照合を組み合わせたデータの検出・分類機能が提供されています。
利用できる分類方法や自動処理は、対象データソースや導入構成によって異なります。既存の秘密度ラベルやDLPとの連携、データを処理する場所、対応する保存先を確認してください。詳細はVaronisのデータ検出・分類に関する公式情報で確認できます。
10. IBM Guardium Discover and Classify
IBM Guardium Discover and Classifyは、複数の構造化・非構造化データソースを対象として、データの発見と分類を支援する製品です。データが保存されている場所を把握し、セキュリティやコンプライアンスの管理に必要な分類情報を整理する用途で検討できます。
同じIBM製品でも、文書検索を主目的とするIBM Watson Discoveryとは役割が異なります。導入時には、対象データソース、導入方式、分類結果をどの保護措置へ連携させるかを確認してください。詳細はIBM Guardium Discover and Classifyの公式情報を参照してください。
データ分類技術の最新トレンド
以下は、2026年8月時点で確認できるAIデータ分類の主な傾向です。機能の提供状況や対応範囲は製品ごとに異なるため、導入時には各社の公式情報を改めて確認してください。
AIデータ分類では、テキストだけでなく、画像や音声など複数の形式を扱うマルチモーダルな解析が活用されるようになっています。例えば、スキャン文書に含まれる文字をOCRで抽出し、文書の内容やレイアウトと組み合わせて分類する方法があります。
ただし、画像の解像度、文字の品質、文書形式、学習データなどによって認識精度は変わります。特に機密情報の判定では、AIの出力だけに依存せず、誤検知や見逃しを評価するテストと人による確認が必要です。
また、データをクラウドへ送信せず、端末や社内環境で処理するエッジAIも選択肢の一つです。通信量やデータの外部送信を抑えられる場合がありますが、処理速度や精度、端末への負荷はモデルと実行環境によって異なります。
生成AI時代におけるデータ保護のあり方
ChatGPTやMicrosoft 365 Copilotなどの生成AIを業務で利用する際は、従業員がプロンプトへ機密情報や個人情報を入力するリスクを考慮する必要があります。利用規程、アクセス権、ログ管理、教育、技術的な制御を組み合わせた対策が重要です。
この課題に関連して注目されているのが、「DSPM(Data Security Posture Management:データセキュリティ・ポスチャ管理)」です。DSPMは、機密データの所在やアクセス権、設定上のリスクなどを継続的に把握し、データセキュリティの態勢を管理する考え方です。
生成AIへの入力内容を分類・検査し、機密情報が含まれる場合に警告や送信制御を行う仕組みもあります。ただし、送信の自動遮断には、対応するDLPやプロキシ、アクセス制御などの機能と適切なポリシー設定が必要です。AIデータ分類は、こうしたデータガバナンスを構成する要素の一つとして位置付けることが大切です。
AX CAMPなら現場成果から逆算したAI活用を学べます
株式会社AXが提供する法人向けAI研修サービス「AX CAMP」は、AIの知識を学ぶだけでなく、企業の現場での活用を見据えた伴走型の研修プログラムです。完全オンラインで受講可能であり、14時間のeラーニングを通じて、PCの基本操作から実践的なAI活用スキルまで学べます。
研修では、自社の業務課題を分解し、AIをどの業務でどのように活用するかを検討するプロセスに取り組みます。AIデータ分類を含む個別のシステムを提供・開発するサービスではありませんが、データ整理や業務効率化などの課題について、AIを活用できる部分と人による判断が必要な部分を整理する際に、研修で得た知識を生かせます。さらに、半年から年間におよぶ伴走支援を通じて、学習内容を現場での実践につなげることを支援します。
実際の導入事例として、役員・管理職から3段階で全社展開を行い、AI活用の土台づくりを推進した株式会社JIMOSの事例があります。自社のデータ管理やAI活用に課題を感じているDX推進担当者や現場マネジャーの方は、AX CAMPの導入をご検討ください。

法人向けAI研修
AX CAMP 無料資料
まとめ:適切なデータ分類の活用で安全なデータ運用を
AIによるデータ分類は、増え続ける企業データを整理し、セキュリティ運用や情報活用を支援する手段です。ただし、分類やラベル付けだけで暗号化、アクセス制限、送信遮断まで自動的に実行されるとは限りません。
目的に応じてDLP、情報保護、アクセス制御などと連携させる必要があります。
まずは自社に存在するデータを棚卸しし、機密性レベルと分類ポリシーを定めましょう。そのうえで、対象データ、利用環境、必要な保護措置、ライセンス条件を確認して、紹介した10件を含む製品・サービスを比較し、限定した範囲で検証することが大切です。
社内のAI活用スキルを高めたい場合は、AX CAMPのような法人向け研修も選択肢になります。
法人向けAI研修
AX CAMP 無料資料
