LLM(大規模言語モデル)をビジネスに活用したいけれど、
「回答の精度をどう評価すればいいかわからない」
「どの指標やツールを使えば、自社の目的に合った最適な判断ができるのか」といった悩みを抱えていませんか。LLMの性能は日々進化していますが、その能力を最大限に引き出すには、出力される情報の正確性や適切性を客観的に評価し、継続的に改善するプロセスが不可欠です。
LLMの精度評価は、単なる技術的な課題ではありません。それは、ビジネス上のリスクを管理し、投資対効果(ROI)を最大化するための重要な経営判断に直結します。誤った情報に基づいたサービスは顧客の信頼を損ない、期待した業務効率化が実現できなければ、導入コストが無駄になってしまう可能性もあるのです。
この記事では、LLMの精度評価が必要な理由、評価指標、実践手順、評価ツール、改善策を解説します。評価の目的を定め、自社の業務データで効果とリスクを確認するための参考にしてください。導入・改善の進め方を検討する際は、AX CAMPの資料もご覧いただけます。
法人向けAI研修
AX CAMP 無料資料
LLMの精度評価がビジネスで重要視される理由
結論から言うと、LLMの精度評価がビジネスで極めて重要視される理由は、「ビジネス品質の担保とリスク管理」そして「投資対効果(ROI)の最大化」という2つの側面に集約されます。これらは、LLMを単なる技術としてではなく、事業を成長させるための戦略的ツールとして活用する上で欠かせない視点です。
適切な評価を怠ると、予期せぬトラブルやコスト増大を招きかねません。逆に、精度を正しく測定し管理することで、LLMのポテンシャルを最大限に引き出し、競争優位性を確立できます。次のセクションでは、これら2つの具体的な理由を掘り下げていきます。
ビジネス品質の担保とリスク管理
LLMの精度は、提供するサービスや製品の品質に直接影響を及ぼします。例えば、顧客対応チャットボットが誤った情報を回答すれば、顧客満足度の低下やクレームに繋がるでしょう。また、LLMが生成したコンテンツに事実誤認や不適切な表現が含まれていた場合、企業のブランドイメージを大きく損なうリスクがあります。
こうした事態を防ぐためには、導入前にLLMの回答精度を厳密に評価し、品質基準をクリアしているかを確認する必要があります。特に、LLMが事実に基づかない情報を生成する「ハルシネーション」は深刻な問題であり、定期的な精度評価によるリスク管理が不可欠です。品質の維持は、顧客からの信頼を守るための生命線と言えるでしょう。
投資対効果(ROI)の最大化
LLMの導入には、ライセンス費用や開発・運用コストなど、少なくない投資が必要です。この投資を回収し、利益を最大化するためには、LLMが期待通りの成果を上げているかを定量的に評価しなくてはなりません。
精度が低いLLMを運用し続けると、手作業による修正や確認作業が増加し、かえって業務効率が悪化する恐れがあります。精度を客観的な数値で評価することで、改善すべき点を特定し、効率的にROIを向上させるための施策を打つことが可能になります。精度評価は、LLM導入プロジェクトの成否を判断する上で、重要な羅針盤となるのです。
LLMの精度を測る主要な評価指標とは?
LLMの評価には、人によるレビュー、参照文との一致を測る統計的指標、LLMを評価者に用いる方法などがあります。目的によって必要な指標は異なり、文章の流暢さ、事実の正しさ、業務上の有用性は別々に確認します。(出典:LangSmith評価ドキュメント)
人間による評価(Human Evaluation)
人間による評価は、評価者がLLMの生成した回答を直接読み、その品質を評価する最も基本的な手法です。評価基準には、以下のような項目が含まれます。
- 正確性:回答が事実に基づいているか
- 流暢さ:文章が自然で読みやすいか
- 網羅性:必要な情報が過不足なく含まれているか
- 有用性:ユーザーの意図や目的に対して役立つか
この手法の最大の利点は、人間の感覚に近い、総合的で質の高い評価が可能な点です。特に、創造性や文脈の適切さなど、数値化が難しい側面の評価に適しています。一方で、評価者の主観に左右されやすく、評価基準を統一するのが難しいという課題があります。また、多くの人手と時間が必要になるため、コストが高くなる傾向にあります。
従来型の統計的指標(BLEU, ROUGE)
従来から自然言語処理の分野で用いられてきた、統計的なアプローチに基づく評価指標です。代表的なものに、機械翻訳の評価で使われる「BLEU(Bilingual Evaluation Understudy)」や、文章要約の評価で使われる「ROUGE(Recall-Oriented Understudy for Gisting Evaluation)」があります。(出典:BLEU: a Method for Automatic Evaluation of Machine Translation)
これらの指標は、モデルが生成したテキストと、人間が作成した正解テキスト(参照テキスト)を比較し、単語やフレーズの一致度を計算することでスコアを算出します。自動で大量のデータを評価できるため、迅速かつ低コストで客観的な評価が可能です。しかし、同義語や言い換え表現を考慮できず、表面的な一致度しか測れないため、文章全体の意味や文脈の適切さまでは評価しきれないという限界があります。
モデルベース評価(LLM-as-a-Judge)
LLM-as-a-Judgeは、LLMに評価基準と対象の回答を与え、回答の品質を評価する手法です。評価者には、その業務で人の判断とどの程度一致するかを検証したモデルを選びます。2026年10月28日時点では、OpenAIのGPT-6 AstraやAnthropicのClaude Opus 5.5などが現行モデルの候補ですが、世代名だけで評価者としての適性は決まりません。(出典:OpenAIモデル一覧、Anthropicモデル一覧)
この方法は評価を自動化しやすい一方、評価者モデルにも誤りや偏りがあります。人が評価した例との一致を確認し、モデルやプロンプトを変更した際は再検証します。費用と処理時間も実データで測定してください。(出典:Amazon BedrockのLLM評価)
LLMの精度評価を実践する具体的なステップ
LLMの精度評価を効果的に進めるためには、計画的なアプローチが不可欠です。具体的なプロセスは、大きく分けて「評価の準備」と「評価の実施と結果の分析」という2つの主要なステップで構成されます。これらのステップを丁寧に進めることで、客観的で信頼性の高い評価結果を得ることができます。
特に準備段階でのデータセットと評価基準の策定は、評価全体の質を左右する重要な工程です。ここでの設計が曖昧だと、得られた結果から有益な示唆を引き出すことが難しくなります。
評価の準備(データセットと評価基準の策定)
最初のステップは、評価の土台となるデータと基準を準備することです。これは評価の目的を明確にし、何を測るのかを定義する重要なプロセスです。
まず、評価に使用するデータセットを準備します。これには、業界で標準的に使われるベンチマークデータセット(例:JGLUE)を利用する方法と、自社の業務内容に即した独自のデータセットを作成する方法があります。(出典:日本語言語理解ベンチマークJGLUE) 特に、特定の業務への適合性を測る場合は、実際の業務データに基づいたデータセットの作成が極めて有効です。
次に、評価基準を具体的に策定します。どのような観点で「良い回答」とするのかを定義する作業です。評価基準には、以下のような項目が考えられます。
- 回答の正解率:事実と合っているか、計算は正しいか
- 指示への忠実度:与えられた指示や制約を守っているか
- 情報の網羅性:必要な情報が欠けていないか
- 安全性:有害・不適切な内容を含んでいないか
これらの基準を事前に明確に定めておくことで、評価の客観性と一貫性を担保できます。
評価の実施と結果の分析
準備が整ったら、次に評価を実施し、その結果を詳細に分析します。このステップでは、準備段階で定めた計画を実行に移し、データに基づいた改善点を見つけ出します。
策定した評価基準とデータセットを用いて、実際にLLMの評価を行います。前述した人間による評価、統計的指標、モデルベース評価などの手法を、目的に応じて選択または組み合わせて実施します。評価結果は、スコアや正誤率などの定量的なデータとして集計し、可視化することが重要です。
評価結果が出たら、それで終わりではありません。最も重要なのは、その結果を分析し、次のアクションに繋げることです。特にスコアが低かった回答や、エラーが発生したケースを重点的に分析し、「なぜ精度が低かったのか」「どのような傾向の質問に弱いのか」といった原因を深掘りします。この分析を通じて、プロンプトの改善やファインチューニングなど、具体的な精度向上策を立案していくのです。
LLM精度評価に役立つツール・ライブラリ3選
LLMの評価や運用時の記録に利用できるツールを3つ紹介します。RAGの評価、実行経路の追跡、評価データの管理など、確認したい範囲に合わせて選びましょう。利用料に加え、評価に使うモデルのAPI料金や運用費も確認してください。
各ツールの対象範囲や必要な入力データは異なります。評価結果が高くても、事実性や安全性をすべて保証するわけではないため、重要な回答は元資料や人のレビューと照合します。
1. RAGAS (RAGシステム評価特化)
Ragasは、RAGを含むLLMアプリケーションやAIワークフローの評価に使えるオープンソースのフレームワークです。RAGでは検索と回答生成を分けて評価でき、エージェントや一般的な文章比較向けの指標も提供されています。(出典:Ragasの指標一覧)
RAGASは、RAGシステムの性能を以下の主要な指標で評価します。
- Faithfulness(忠実性):回答が検索した文脈に忠実か
- Answer Relevancy(回答の関連性):回答が質問内容と関連しているか
- Context Precision(文脈の適合率):検索した文脈に無駄がないか
- Context Recall(文脈の再現率):回答に必要な文脈を検索できているか
これらの指標は、回答が取得文脈に支えられているか、必要な文脈を検索できているかなどを調べるためのものです。取得文脈そのものの事実性を自動で保証するわけではありません。参照回答や文書の正しさも別途確認してください。
2. LangSmith (トレーサビリティと評価)
LangSmithは、LLMアプリケーション開発フレームワークであるLangChainを提供するLangChain社が開発したツールです。LLMアプリケーションのデバッグ、テスト、評価、監視を一つのプラットフォームで完結できることを特徴としています。(出典:Announcing LangSmith, a unified platform for debugging, testing, evaluating, and monitoring your LLM applications)
LangSmithの最大の強みは、LLMアプリケーションの内部で何が起こっているかを詳細に追跡できる「トレーサビリティ」です。ユーザーからの入力が、どのようなプロンプトに変換され、LLMがどう応答し、最終的な出力に至ったかという一連の流れを可視化できます。これにより、問題が発生した際の原因特定が容易になります。また、作成した評価データセットを用いて、アプリケーションの性能を継続的にテスト・評価する機能も備えています。
3. TruLens (説明可能性と評価)
TruLensは、LLMアプリケーションの実行記録と評価に使えるオープンソースのツールです。RAGでは、検索文脈の関連性、回答の根拠性、質問に対する回答の関連性を分けて評価できます。モデル内部の思考や判断理由を直接読み出すものではありません。
入力、取得文脈、出力などの記録を使って回答プロセスを点検し、問題が生じた箇所を調べます。文脈に支えられた回答でも、その文脈自体が誤っている場合があるため、元資料の確認が必要です。(出典:TruLens RAG Triad)
LLMの回答精度を向上させる代表的な手法
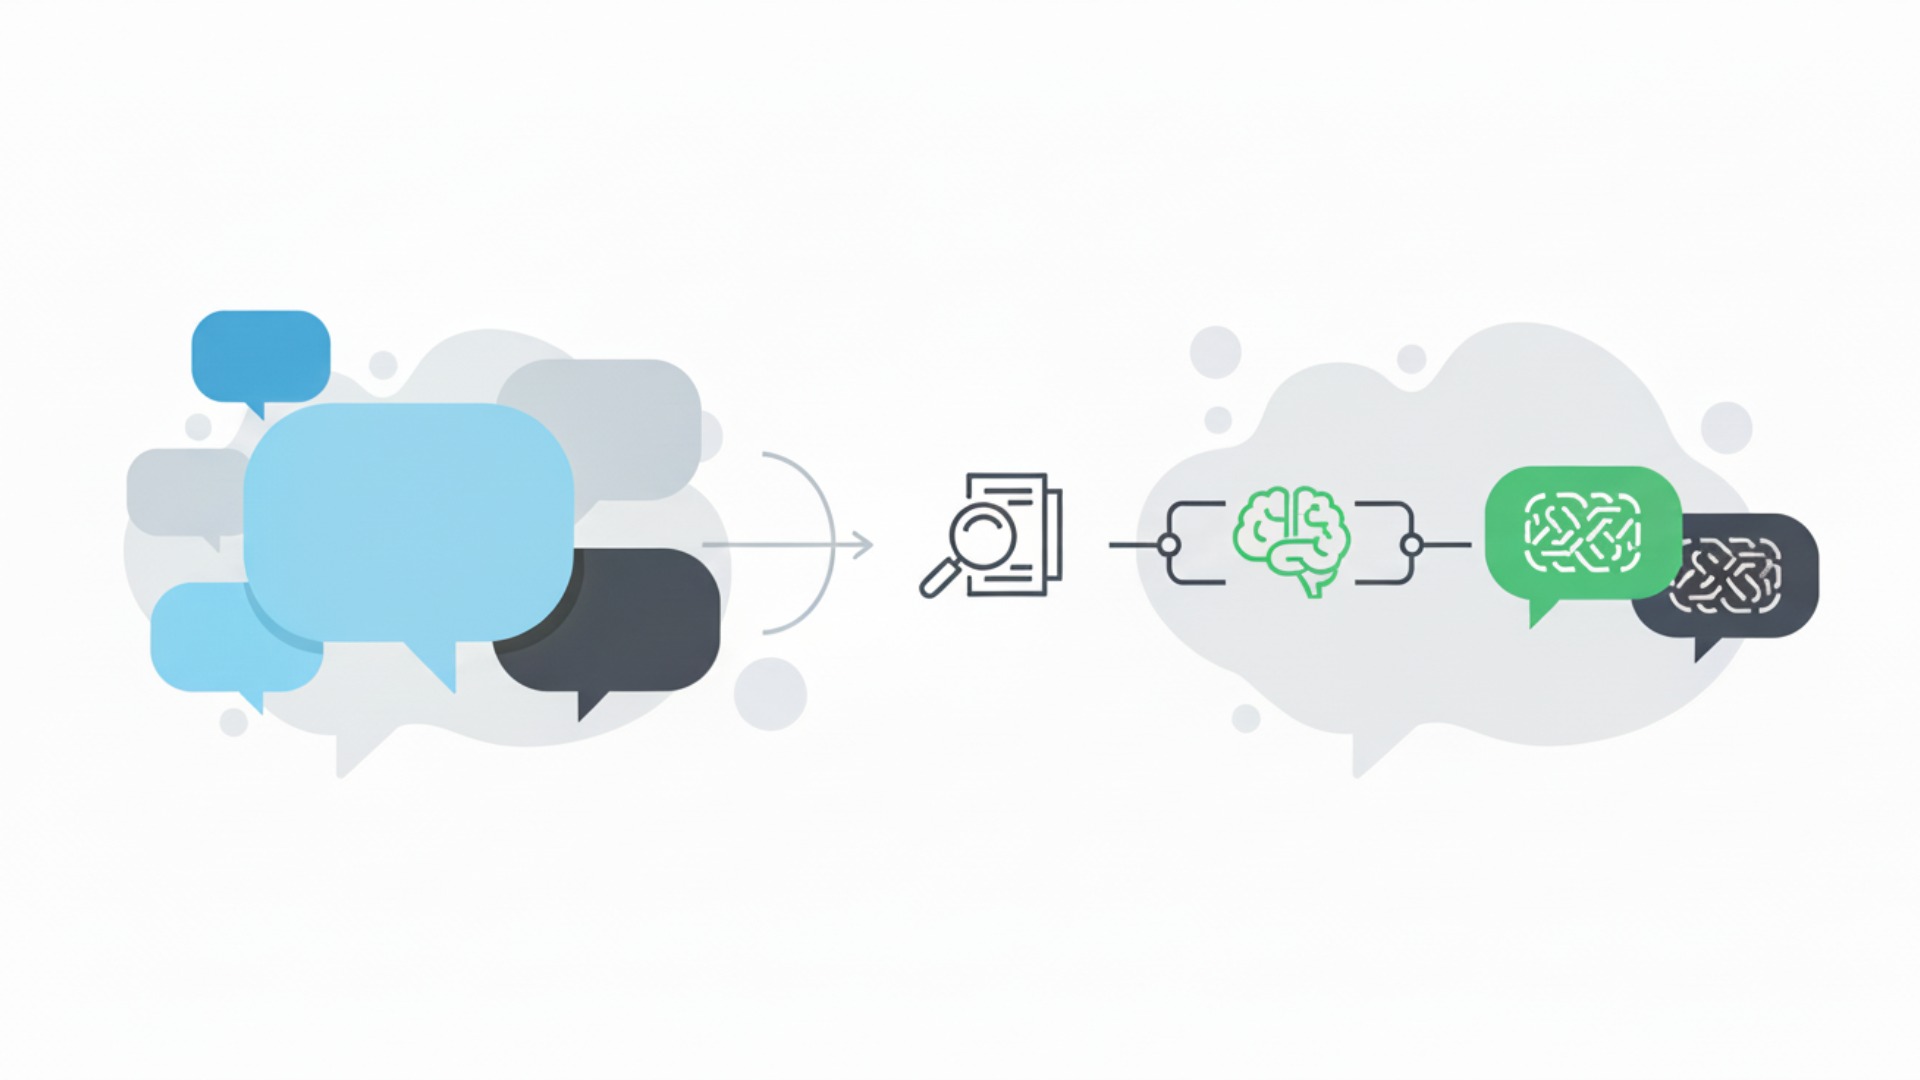
LLMの精度評価によって課題が明らかになった後は、具体的な改善策を講じる必要があります。LLMの回答精度を向上させるためのアプローチは多岐にわたりますが、特に効果的とされる代表的な手法が「RAG(Retrieval-Augmented Generation)」「ファインチューニング」「プロンプトエンジニアリング」の3つです。これらの手法は、それぞれ異なる特性を持っており、解決したい課題に応じて使い分けることが成功の鍵となります。
RAG(Retrieval-Augmented Generation)による知識の補強
RAGは、LLMが回答を生成する際に、社内文書やウェブ上の最新情報など、外部の知識源をリアルタイムで参照する技術です。LLM本体が学習していない最新の情報や、社内固有の専門知識を回答に反映させたい場合に非常に有効です。
RAGは外部資料を参照して回答を補助しますが、検索漏れ、資料の誤り、文脈の読み違いによって誤答は残ります。情報更新の際にモデル本体の再学習を省ける場合がある一方、検索基盤や権限管理、文書更新の費用は必要です。(出典:RAG原論文)
ファインチューニングによる特定タスクへの特化
ファインチューニングは、既存の学習済みLLMに対して、特定のドメインやタスクに特化したデータを追加で学習させる手法です。これにより、モデルを自社の業務に合わせてカスタマイズし、特定の応答スタイルや専門用語への対応能力を高めることができます。
例えば、社内で承認したQ&Aや応答例を追加学習に使い、出力形式や業務固有の応答傾向を調整する方法があります。ただし、法律などの専門領域で正確性を保証するものではありません。高品質な学習データ、未学習の評価データ、専門家による確認、運用コストの検討が必要です。
プロンプトエンジニアリングの高度化
プロンプトエンジニアリングは、LLMへの指示(プロンプト)の出し方を工夫することで、回答の質を向上させる技術です。モデル自体に手を入れることなく、入力の仕方だけで精度を改善できるため、最も手軽で基本的な手法と言えます。
具体的なテクニックとしては、以下のようなものが挙げられます。
- 役割の付与:専門家などの役割を与えて回答させる
- 出力形式の指定:箇条書きや表形式など、フォーマットを具体的に指示する
- 根拠と確認項目の指定:参照した資料や計算結果など、検証できる情報を示してもらう。推論モデルでは「ステップごとに考えて」という指示が不要な場合があります。
- 回答例の提示(Few-shot):いくつかの質問と回答の例を示してから質問する
これらのテクニックを組み合わせることで、LLMの能力を最大限に引き出し、意図した通りの回答を得る確率を高めることができます。精度改善の第一歩として、まず取り組むべき手法です。
精度100%は不可能?LLMの限界と適切な向き合い方
LLMの精度向上は重要ですが、汎用的な質問に対して常に正解することを保証できません。限定したテストで正解率100%になっても、未評価の入力に同じ結果が続くとは限りません。誤りの影響が大きい用途では、人が確認する工程や回答を保留する条件を設けましょう。
ただし、これはあらゆるタスクで精度が出ないという意味ではありません。タスクの定義を具体的に絞り込み、適切なデータでファインチューニングを行えば、特定の業務においては極めて高い精度を実現することも可能です。LLMを万能のツールと過信するのではなく、その特性を理解した上で、人間の判断を補完するアシスタントとして位置づけることが重要です。
LLMが持つ本質的な限界(確率モデルとハルシネーション)
多くのLLMは、学習したパターンと入力文脈をもとに、次のトークンの確率から文章を生成します。常に最も確率の高い語だけを選ぶわけではなく、もっともらしい文章が事実に合うとも限りません。推論能力と、個々の回答が正しいかどうかは分けて評価する必要があります。
ハルシネーションとは、事実や根拠と一致しない内容をもっともらしく生成する問題です。RAGやプロンプトの工夫をしても誤りは起こり得ます。特に重要な回答は一次資料と照合し、不明な場合は回答を保留する運用にします。
Human-in-the-loop(人間参加型)の重要性
LLMの限界を補うために極めて重要なのが、Human-in-the-loop(HITL)という考え方です。これは、AIシステムのプロセスの中に人間が介在し、AIの出力を監視、検証、修正する仕組みを指します。
例えば、AIが作成した契約書の草案を弁護士がレビューする、AIが診断した医療画像を医師が最終確認するなど、重要な意思決定や最終的な品質保証は人間が担うことが不可欠です。AIと人間が協業することで、最終的なアウトプットの品質を担保します。LLMはあくまで強力なアシスタントであり、最終的な責任は人間が持つという意識が求められます。
高精度LLMのビジネス活用事例
AX CAMPの公開取材から、AIを業務に組み込んだ2社の取り組みを紹介します。顧客の申告による個別事例であり、LLMの正解率を共通条件で比較した実験ではありません。
原稿の生成時間、確認を含む全工程の時間、採用の見送りは異なる指標です。どの範囲を測った数値かを確認し、自社で同じ効果が出るとはみなさないことが大切です。
Route66様の事例
Route66様の2025年8月の公開取材では、従来最大24時間、短くても3時間かかっていた記事原稿の執筆に対し、AI出力は10秒と報告されています。準備、編集、事実確認、画像挿入、公開までの全工程が10秒で終わるという意味ではありません。(出典:Route66様の原取材)
WISDOM合同会社様の事例
WISDOM様の2025年8月の公開取材では、AI活用の見通しを受けてバックオフィス担当2名の採用を見送ったと紹介されています。一方、アポイント調整の自動化は取材本文では今後の実装計画であり、2名分の全業務を完全代替した実測結果とは区別します。(出典:WISDOM様の原取材)
自社で効果を測る際の確認点
事例を参考に導入する際は、生成だけでなく準備・確認・修正を含めた時間を測ります。正解率、差し戻し率、担当者の確認時間、運用費を導入前後で比較し、AIに任せる範囲を判断しましょう。
LLM導入・運用における精度関連の注意点
LLMを導入し、その精度を維持・向上させていく過程では、いくつかの重要な注意点が存在します。特に「性能とコストのバランス」を常に意識することと、「機密情報の取り扱い」に関するセキュリティ対策は、継続的な運用において避けては通れない課題です。これらの点を見過ごすと、予期せぬコスト超過や重大な情報漏洩インシデントに繋がる可能性があります。
性能・コストのバランスと継続的な改善
一般的に、より高性能なLLMは、APIの利用料金や運用にかかるコンピューティングリソースが高価になる傾向があります。そのため、あらゆるタスクに最高性能のモデルを使うのではなく、業務の重要度や求められる精度に応じて、適切な性能のモデルを選択することがコスト効率の観点から重要です。
例えば、社内向けの簡単な要約作業には低コストなモデルを、顧客向けの重要な文書作成には高性能なモデルを、といった使い分けが考えられます。また、LLMの世界は日進月歩であり、新しいモデルが次々と登場します。一度導入したらずっと同じモデルを使い続けるのではなく、定期的に精度とコストのバランスを見直し、継続的に改善サイクルを回していく姿勢が求められます。
機密情報や個人情報の取り扱い
外部のLLMサービスを使う際は、入力・出力の学習利用、保存期間、閲覧権限、処理地域、委託先を確認します。学習に使われない設定であっても、保存や安全対策のための処理が一切なくなるわけではありません。機密・個人情報の入力は、契約と社内規程に従って判断してください。
例えばOpenAIは法人向け対象製品とAPIのデータを、既定ではモデル学習に使わないと説明しています。ただし、保持条件や権限設定は別途確認が必要です。Azure OpenAIでも閉域接続にはプライベートエンドポイント等の設定が必要で、サービス名だけで閉域を保証するものではありません。(出典:OpenAI法人データ方針、Microsoftの閉域接続資料)
LLMの精度向上や評価をプロに相談するならAX CAMP
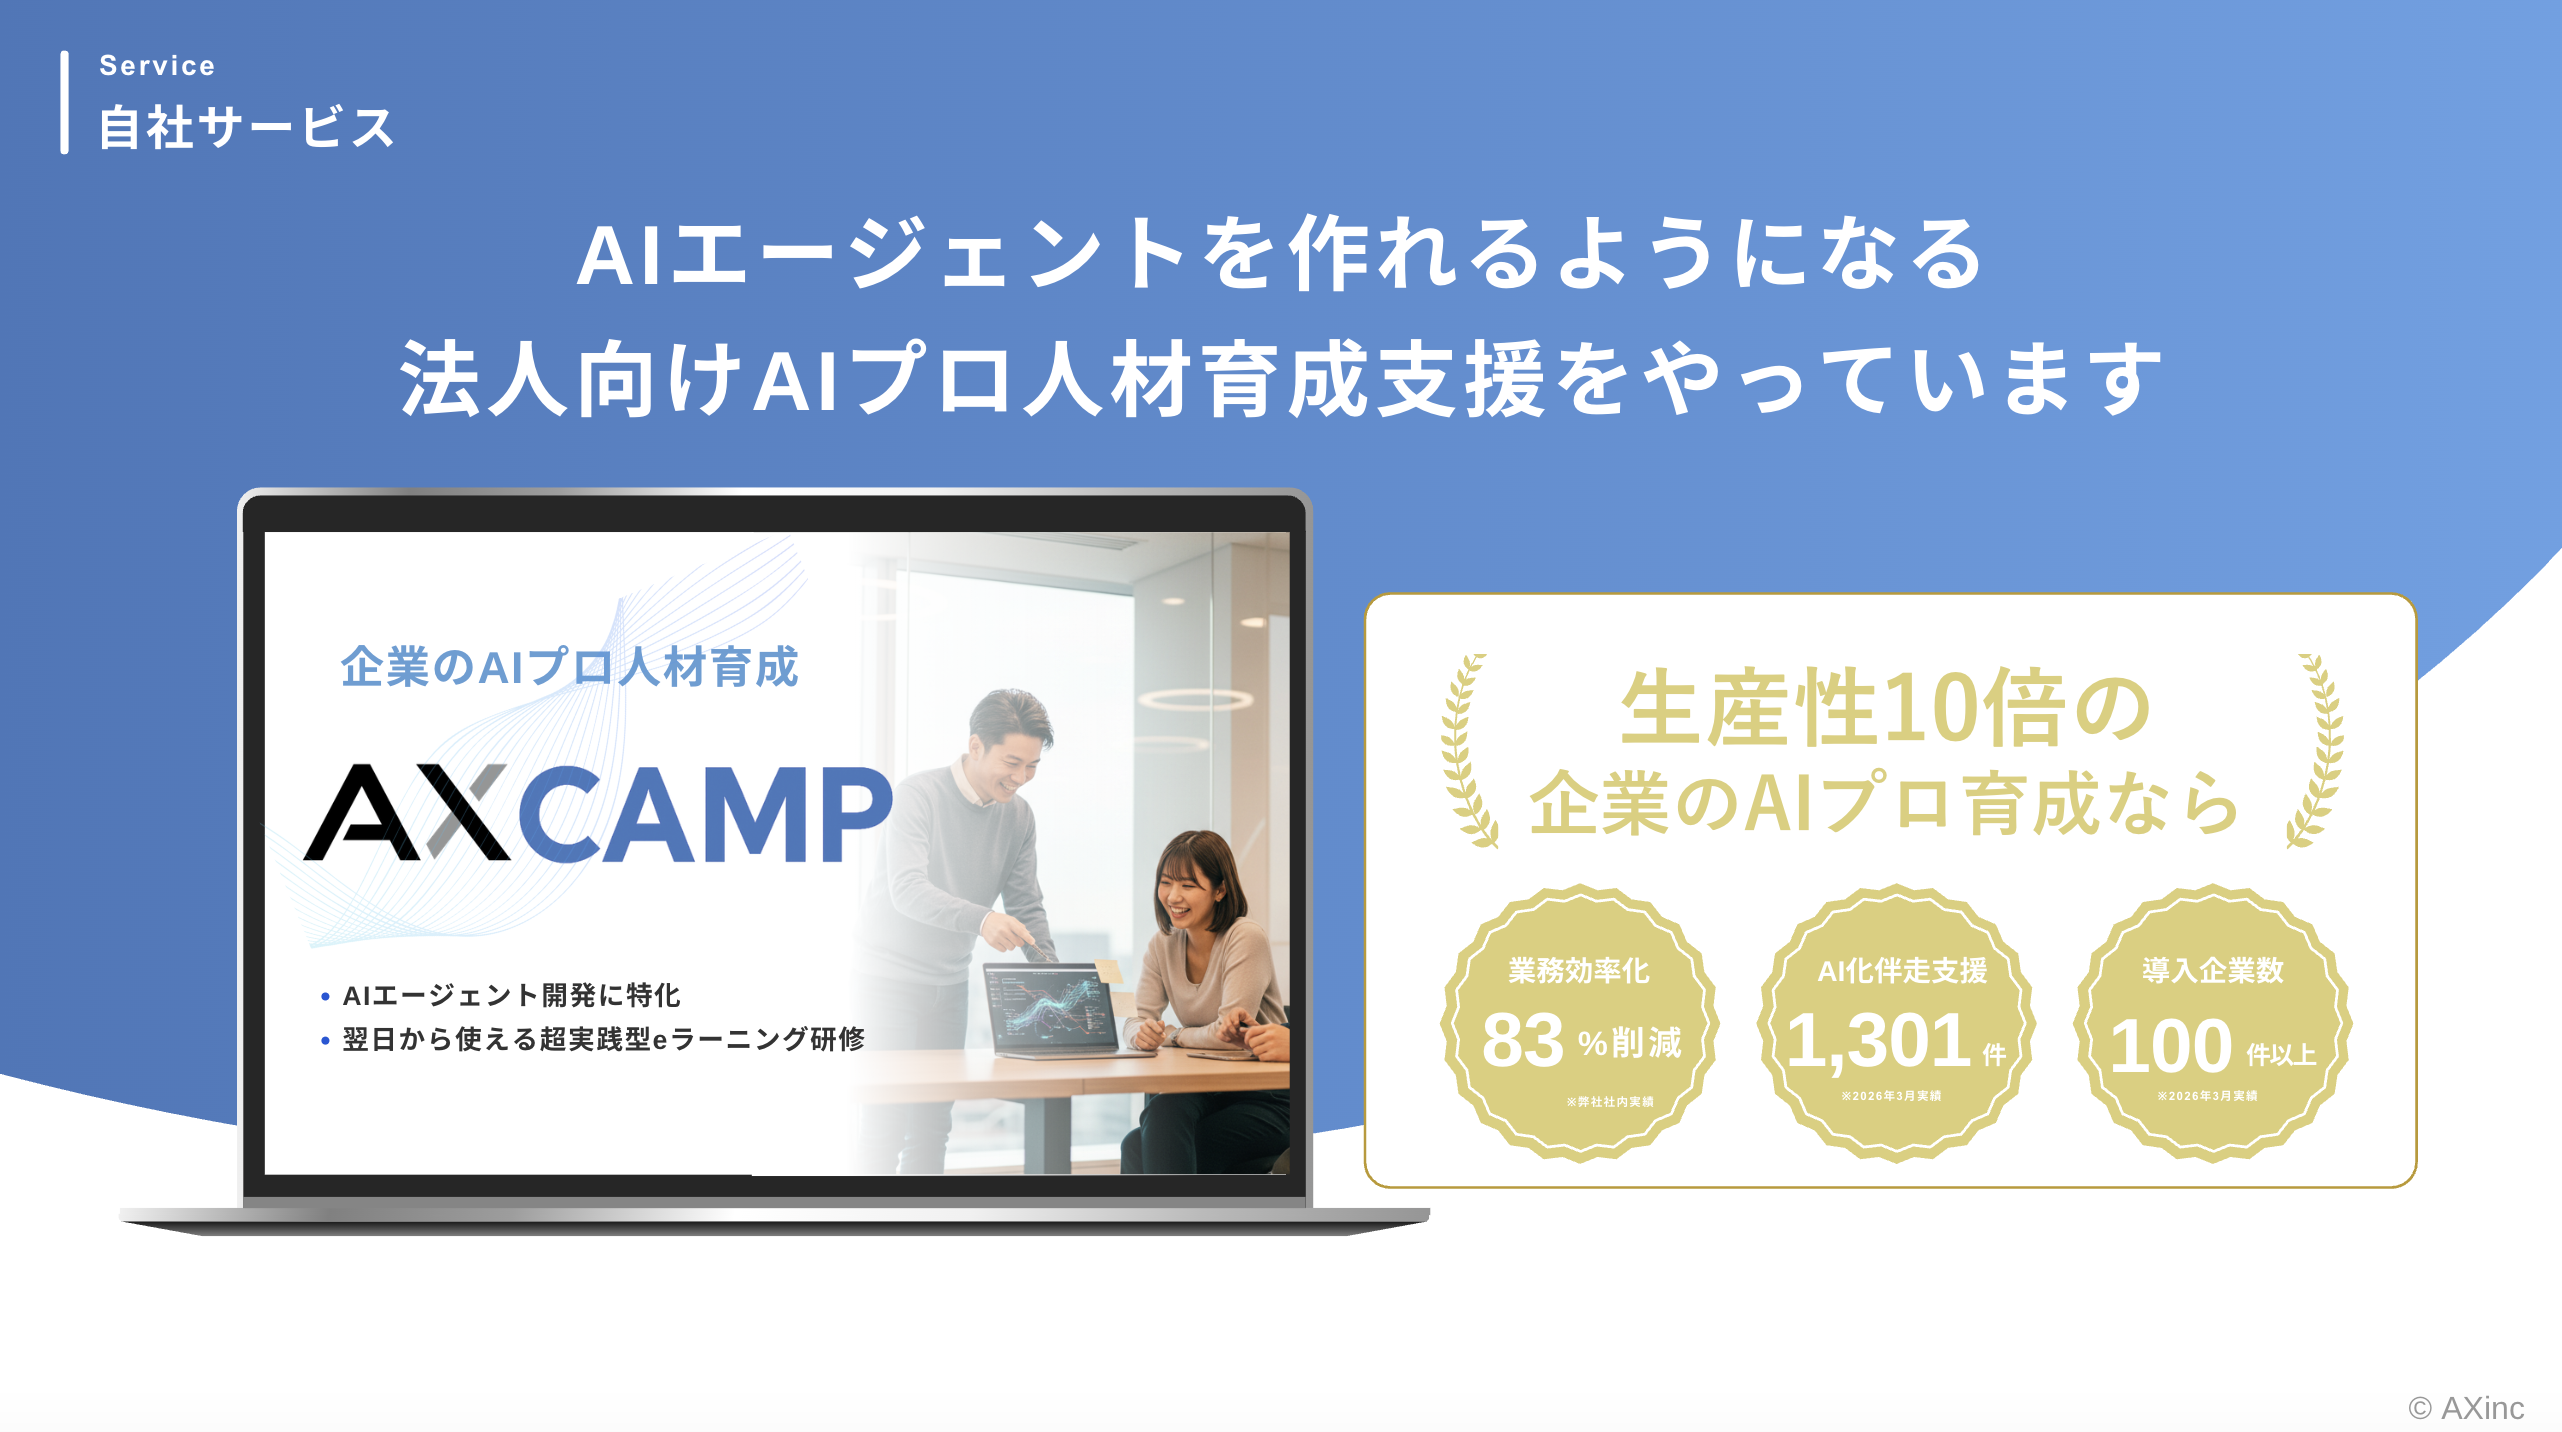
LLMの精度評価や改善は、専門的な知識とノウハウが求められる領域です。「どの評価指標を選べばいいかわからない」「RAGやファインチューニングを自社で実装するリソースがない」「そもそも何から手をつければ良いのか…」といった課題に直面している企業担当者の方も多いのではないでしょうか。
専門家の支援は、評価方法の設計や実装を進める選択肢の一つです。支援範囲、担当者、費用、成果の確認方法を相談し、自社の課題に合うかを判断しましょう。
AX CAMPでは、企業の業務課題に応じたAI活用の学習や実践を支援しています。LLM評価、RAG、追加学習の実装、研修後の支援など、希望する内容が対象になるかは個別にご相談ください。
机上の空論ではなく、現場で使えるスキルを習得し、具体的な成果に繋げたい。そうお考えの企業様は、ぜひ一度、無料相談や資料請求をご検討ください。貴社の課題解決に繋がるヒントがきっと見つかるはずです。

法人向けAI研修
AX CAMP 無料資料
まとめ:LLMの精度を正しく評価・改善しビジネス価値を最大化しよう
本記事では、LLMの精度評価の重要性から、具体的な指標、実践ステップ、最新ツール、そして精度向上のための手法までを網羅的に解説しました。LLMをビジネスで成功させるためには、その能力を正しく理解し、客観的なデータに基づいて性能を管理していくことが不可欠です。
この記事の重要なポイントを以下にまとめます。
- 品質とROI:精度評価はビジネス品質の担保とROI最大化に直結する
- 評価指標:目的別に「人間による評価」「統計的指標」「モデルベース評価」を使い分ける
- 改善手法:RAG、ファインチューニング、プロンプトエンジニアリングで精度は改善可能
- 限界の認識:テストで高精度でも将来の正解は保証されず、人による確認が重要
LLMの精度を評価し、改善していくプロセスは、一度行えば終わりというものではありません。ビジネス環境の変化や新しい技術の登場に合わせて、継続的に見直し、最適化を図っていく必要があります。しかし、これらの専門的な取り組みをすべて自社だけで行うのは、決して簡単ではないでしょう。
LLMの評価や活用について相談したい場合は、AX CAMPの支援内容や相談窓口をご確認ください。実装や伴走支援の範囲、費用、成果の確認方法は個別に相談し、自社に合う進め方を検討しましょう。(出典:AX CAMP公式サービス)
法人向けAI研修
AX CAMP 無料資料
