
「LLMの応答品質をさらに高めたいが、具体的にどうすれば良いのか」
「RLHFという言葉は聞くが、その仕組みが複雑でよくわからない」といった課題を抱えていませんか。大規模言語モデル(LLM)の性能を飛躍させる鍵として、現在
「強化学習」のアプローチが大きな注目を集めています。単に知識を詰め込むだけでなく、人間の意図や価値観に沿った、より自然で安全な応答を生成させるために不可欠な技術です。
この記事では、LLMにおける強化学習の基本概念から、中核技術であるRLHF(人間のフィードバックからの強化学習)の3ステップ、さらにはDPOやRLAIFといった2026年最新の代替手法まで、体系的に解説します。最後まで読むことで、自社サービスに搭載するLLMの品質を次のレベルへ引き上げるための具体的な道筋が見えるようになるでしょう。AI開発の最前線で何が起きているのか、その全体像を掴むためにもぜひご一読ください。貴社のAI戦略を加速させるヒントが、ここにあります。
法人向けAI研修
AX CAMP 無料資料
LLMと強化学習の組み合わせが注目される背景

大規模言語モデル(LLM)に強化学習が応用される背景には、モデルの応答を人間の意図や価値観と一致させる「アライメント」の必要性が高まっていることがあります。従来の学習手法だけではこの課題の解決が難しく、より高度な制御技術として強化学習の活用が進んでいるのです。
LLMにおける「アライメント問題」とは
LLMにおけるアライメント問題とは、モデルの応答が人間の意utoや社会的な価値観と一致しない状態を指します。 具体的には、不正確な情報(ハルシネーション)を生成したり、有害なコンテンツやユーザーの指示とはかけ離れた回答を返してしまったりする問題です。 この問題は、LLMを社会で安全かつ有効に活用する上での大きな障害となります。
アライメントが不十分なLLMは、ビジネス利用において予期せぬリスクを生み出しかねません。例えば、顧客対応チャットボットが不適切な発言をしたり、マーケティングコピーが誤解を招く表現を生成したりするケースが考えられます。こうしたリスクを抑制し、LLMを社会に実装するためには、適切なアライメントの向上が不可欠です。
ただし、アライメントの強化は単純な課題ではありません。安全性を追求する調整が、逆にモデルの持つ知識や推論能力といった重要な性能を低下させてしまうトレードオフが発生する場合があります。 この現象は、一部の研究者や開発者の間で非公式な業界用語として「アライメント税(alignment tax)」と呼ばれることがあります。
実際に、人間のフィードバックを元に強化学習(RLHF)などでモデルの安全性を高めた結果、特定のタスクにおける性能が低下した事例が報告されています。 有用性と安全性の最適なバランスを見つけることは、LLM開発における中心的な課題の一つです。そのため、単純な正解データを学習させるだけでは限界が見られます。
従来の学習手法だけでは不十分な理由
従来のLLM開発で中心だった「教師あり学習(Supervised Learning)」だけでは、アライメント問題を完全に解決するには不十分です。教師あり学習は、あらかじめ用意された正解データを元に学習を進めますが、人間の持つ多様な価値観や文脈に応じた細かなニュアンスを、すべてデータ化することは極めて困難だからです。
例えば、「丁寧な文章」という指示一つとっても、ビジネスメールと友人へのメッセージでは求められる丁寧さが異なります。このような無数の状況に対応できる「正解」を網羅したデータセットの作成は現実的ではありません。そこで、試行錯誤を通じてより良い応答を自ら学習する「強化学習」のアプローチが必要とされているのです。

LLMにおける強化学習とは?基本概念を解説

LLMにおける強化学習とは、生成するテキストを「行動」とみなし、その品質に応じて「報酬」を与えることで、より良い文章を生成できるようにモデルを訓練する手法です。このプロセスは、AIが試行錯誤を繰り返しながら目標達成のための最善の行動を見つけ出す枠組みであり、マルコフ決定過程(MDP)という数学的モデルを用いて捉えられます。
強化学習(RL)の基本的な仕組み
強化学習(Reinforcement Learning, RL)は、主に以下の4つの要素から構成される機械学習の一手法です。
- エージェント:学習する主体(LLM本体)
- 環境:エージェントが相互作用する対象(対話の文脈など)
- 行動:エージェントが環境に対して行う操作(テキストの生成)
- 報酬:行動の結果として環境から得られる評価(人間のフィードバック)
エージェントは現在の「状態」を観測し、何らかの「行動」を選択します。その結果、環境から「報酬」と次の「状態」が与えられます。このサイクルを繰り返しながら、エージェントは将来にわたって得られる累積報酬を最大化するような行動選択の方針(方策)を学習します。この仕組みにより、明確な正解データがないタスクでも、試行錯誤を通じて最適な振る舞いを獲得できるのです。
テキスト生成をマルコフ決定過程として捉える
LLMのテキスト生成プロセスは、「マルコフ決定過程(Markov Decision Process, MDP)」としてモデル化できます。これは、強化学習の理論的な基盤となる考え方であり、具体的には以下のように対応づけられます。
- 状態:それまでに出力されたテキスト
- 行動:次に出力する単語(トークン)の選択
- 報酬:生成されたテキスト全体に対する評価
- 方策:現在のテキスト(状態)に対し、次にどの単語(行動)を選ぶかの確率分布
LLMは、単語を一つずつ選択して文章を生成します。各時点での単語選択が「行動」であり、それによって文章(状態)が変化していくのです。最終的に生成された文章全体に報酬が与えられ、モデルはその報酬を最大化するように、各状態での単語選択の確率(方策)を更新していきます。このように捉えることで、テキスト生成という複雑なタスクを強化学習の枠組みで最適化できるようになります。

LLMに強化学習を適用する主要メリット

LLMに強化学習を適用する最大のメリットは、人間の複雑な好みや価値観をモデルに反映させ、より高品質で安全な応答を生成できる点にあります。これにより、単なる正誤だけでなく「より自然か」「より丁寧か」といった主観的な基準に沿ったチューニングが可能になり、ユーザーの意図を汲み取った応答精度が向上します。
具体的なメリットは以下の通りです。
- 応答品質の向上
- 安全性と倫理性の確保
- ハルシネーションの抑制
- 対話能力の継続的改善
強化学習を通じて、モデルは人間のフィードバックから学習し、より人間らしく自然な対話を実現します。例えば、曖昧な指示に対しても意図を正確に理解し、文脈に沿った適切な応答を返す能力が向上するため、カスタマーサポートなど実用的な場面での効果が期待できます。
さらに、不適切または有害なコンテンツの生成を抑制するように学習させることで、モデルの安全性と倫理性を大幅に高めることができます。また、事実に基づかない情報を生成するハルシネーションも、人間のフィードバックに基づき事実との整合性を高めるよう報酬を設計することで、抑制する効果が期待できます。ただし、この報酬設計は非常に繊細であり、不適切な設計はかえって性能を不安定にさせるリスクも伴う点には注意が必要です。
LLM強化学習の中核技術「RLHF」の仕組み

RLHF(Reinforcement Learning from Human Feedback)は、人間のフィードバックを活用してLLMを強化学習させる、代表的な3段階のプロセスです。この手法の目的は、人間の主観的な好みや価値観をモデルに学習させ、より自然で有用な応答を生成できるように最適化することにあります。ChatGPTなどの高性能な対話AIも、このRLHFを用いることでユーザーフレンドリーな応答能力を獲得しました。
(出典:Training language models to follow instructions with human feedback)
ステップ1:教師ありファインチューニング(SFT)
最初のステップは、高品質な手動データを用いてベースとなるLLMを微調整(ファインチューニング)することです。この段階は教師ありファインチューニング(Supervised Fine-Tuning, SFT)と呼ばれます。
ここでは、人間が作成した質の高い「指示(プロンプト)」と「模範的な応答」のペアからなるデータセットを用意します。モデルはこのデータセットを学習することで、特定のタスク(対話、要約など)の基本的な形式や応答スタイルを習得します。このSFTモデルが、後続の強化学習プロセスの出発点となるのです。
ステップ2:報酬モデル(RM)の学習
次に、人間の好みを学習する「報酬モデル(Reward Model, RM)」を構築します。このステップでは、まずSFTモデルに同じプロンプトを複数回入力し、いくつかの異なる応答を生成させます。
続いて、人間(アノテーター)がそれらの応答を比較し、「最も良いもの」から「最も悪いもの」までランキング付けします。この「プロンプト」と「人間のランキング付き応答データ」を教師データとして、報酬モデルを学習させます。学習後の報酬モデルは、任意の応答を入力すると、人間がどれくらい好むかを予測するスコア(報酬)を出力できるようになります。
ステップ3:PPOによる方策の最適化
最終ステップでは、報酬モデルを指標としてLLM本体(方策モデル)を強化学習で最適化します。このプロセスで現在広く使われているアルゴリズムがPPO(Proximal Policy Optimization)です。(出典:Training language models to follow instructions with human feedback)
具体的な流れは、まずSFTモデル(方策モデル)に任意のプロンプトを入力し、応答を生成させるところから始まります。次に、生成された応答をステップ2で作成した報酬モデルに入力し、その応答が人間の好みにどれだけ合致するかを測る「報酬スコア」を計算します。
PPOアルゴリズムは、この報酬スコアを最大化するようにLLMのパラメータを更新します。(出典:Training language models to follow instructions with human feedback) ただし、報酬スコアだけを追求すると、モデルが報酬モデルの評価の抜け穴を探し、人間が見ると不自然な応答を生成する「報酬ハッキング」のリスクが生じます。
この問題を避けるため、PPOでは元のSFTモデルから出力が大きく逸脱しすぎないようにペナルティ(KLペナルティ)を課します。 これにより、言語モデルとしての基本的な性能を保ちつつ学習を安定させ、この「プロンプト入力→応答生成→スコアリング→パラメータ更新」というサイクルを繰り返すことで、人間にとって有益で安全な応答を生成する能力(方策)を段階的に獲得していくのです。
(出典:Training language models to follow instructions with human feedback)

RLHFを支える人間からのフィードバック収集方法

RLHFの成功は、質の高い人間のフィードバックを効率的に収集する仕組みに依存します。最も一般的な方法は、複数のAI生成応答を人間が比較し、ランキング付けする形式です。この手法により、絶対的な評価が難しい「自然さ」や「面白さ」といった主観的な基準でも、相対的な優劣としてデータ化できます。
フィードバック収集の具体的なプロセスは、以下の通りです。
- 多様なプロンプトの準備
- モデルによる複数応答の生成
- 人間によるランキング付け
- 選好データセットの構築
まず、多様なプロンプトをLLMに入力して複数の応答候補を生成させます。次に、アノテーターと呼ばれる評価者が、ガイドラインに基づきこれらの応答を比較し、「AよりBが良い」といった形で順位付けを行います。この選好データが、報酬モデルを学習させるための貴重な教師データとなるのです。
フィードバックの質と一貫性を担保するためには、明確な評価ガイドラインの策定と、評価者への十分なトレーニングが不可欠です。また、評価者の主観による偏りを減らすため、複数の評価者によるレビューや、多様なバックグラウンドを持つ人材の登用も重要となります。収集されたデータは、LLMの性能を人間の価値観に沿って方向付けるための羅針盤となります。

【2026年最新】RLHFを超える新たな強化学習手法

2026年時点で、RLHF(人間のフィードバックによる強化学習)が持つ複雑さやコストの課題を克服するため、より効率的な手法が注目されています。中でもDPO(Direct Preference Optimization)とRLAIF(Reinforcement Learning from AI Feedback)は、LLMを人間の価値観に沿わせるための有力な技術です。
これらの手法が求められる背景には、LLMの大規模化に伴うアライメントコストの増大があります。この点については、科学技術振興機構(JST)による2025年の調査報告書でも、効率的な学習手法の重要性が指摘されています。
DPOは、RLHFのように報酬モデルを明示的に学習させるステップを省略します。 人間の選好データセットから直接言語モデルのポリシーを最適化するため、計算コストを削減し、学習プロセスを安定させられるのが大きな利点です。 このアプローチは、ファインチューニングに近い形で実装できる手軽さも特徴です。
一方でRLAIFは、人間による評価作業を高性能なAIで代替するアプローチです。 例えば、GPT-5.6のようなモデルが評価者となることで、人間よりも高速かつ一貫性のあるフィードバックを大量に生成できます。これにより、データ収集のボトルネックを解消し、開発サイクルを加速させます。GoogleやAnthropic社も、この手法がRLHFに匹敵する結果をもたらすことを示しています。
(出典:Constitutional AI: Harmlessness from AI Feedback)
(出典:RLAIF)
(出典:DPO Trainer – Hugging Face TRL)
(出典:Direct Preference Optimization: Your Language Model is Secretly a Reward Model)
(出典:CRDS FY2025 FR-05)
DPO(Direct Preference Optimization)
DPO(Direct Preference Optimization)は、RLHFのプロセスを大幅に簡略化する新しいファインチューニング手法です。RLHFが「報酬モデルの学習」と「強化学習」という2段階のプロセスを必要とするのに対し、DPOは人間の選好データから直接LLMを最適化します。(出典:Direct Preference Optimization: Your Language Model is Secretly a Reward Model)
この手法の最大の特長は、報酬モデルを明示的に学習する必要がない点です。 これにより、学習プロセスがシンプルになり、調整も容易になります。結果として、RLHFで課題となりがちだった学習の不安定さを解消しやすく、有力な代替手法として多くのモデルで採用が進んでいます。
実際に、Hugging FaceのTRL(Transformer Reinforcement Learning)ライブラリにはDPOを実装するための「DPOTrainer」が用意されています。 これを用いることで、MistralやLlamaシリーズといった主要なオープンソースモデルのファインチューニングにDPOが広く活用されています。(出典:DPOTrainer – TRL documentation)
ただし、全てのタスクでDPOがRLHFを上回るわけではありません。複雑な指示への追従や、特定の安全性を担保する上では、明示的な報酬モデルを持つRLHFが有効な場合もあります。 そのため、達成したいタスクの性質に応じて手法を使い分けることが依然として重要です。
RLAIF(Reinforcement Learning from AI Feedback)
RLAIF(Reinforcement Learning from AI Feedback)は、フィードバックを生成する人間を、高性能なAIモデルで代替するアプローチです。(出典:RLAIFとは?) RLHFにおける人間によるフィードバック収集は、時間とコストがかかるボトルネックでした。RLAIFは、このプロセスをAIで自動化し、スケーラビリティを大幅に向上させることを目的としています。この手法の詳細は、Googleの研究者らによる論文「RLAIF: Scaling Reinforcement Learning from Human Feedback with AI Feedback」などで体系化されています。
具体的には、まず評価者として機能する別のAIモデルを用意します。そして、学習対象のLLMが生成した複数の応答に対し、あらかじめ設定した基準に基づいてAI評価者がランク付けやスコアリングを行います。このAIによるフィードバックデータを用いて、RLHFと同様のプロセスで学習を進める流れです。
AIが評価する際の基準として、Anthropic社が提唱した「憲法(Constitution)」のような原則を用いる手法もあります。(出典:Constitutional AI: Harmlessness from AI Feedback)これは「無害な応答を心がける」といった一連のルールをAIに与え、それに従って応答の良し悪しを判断させるものです。この手法により、人間への依存を減らし、より大規模かつ高速なアライメント調整が可能になると期待されています。

LLM強化学習を実装する具体的な手順
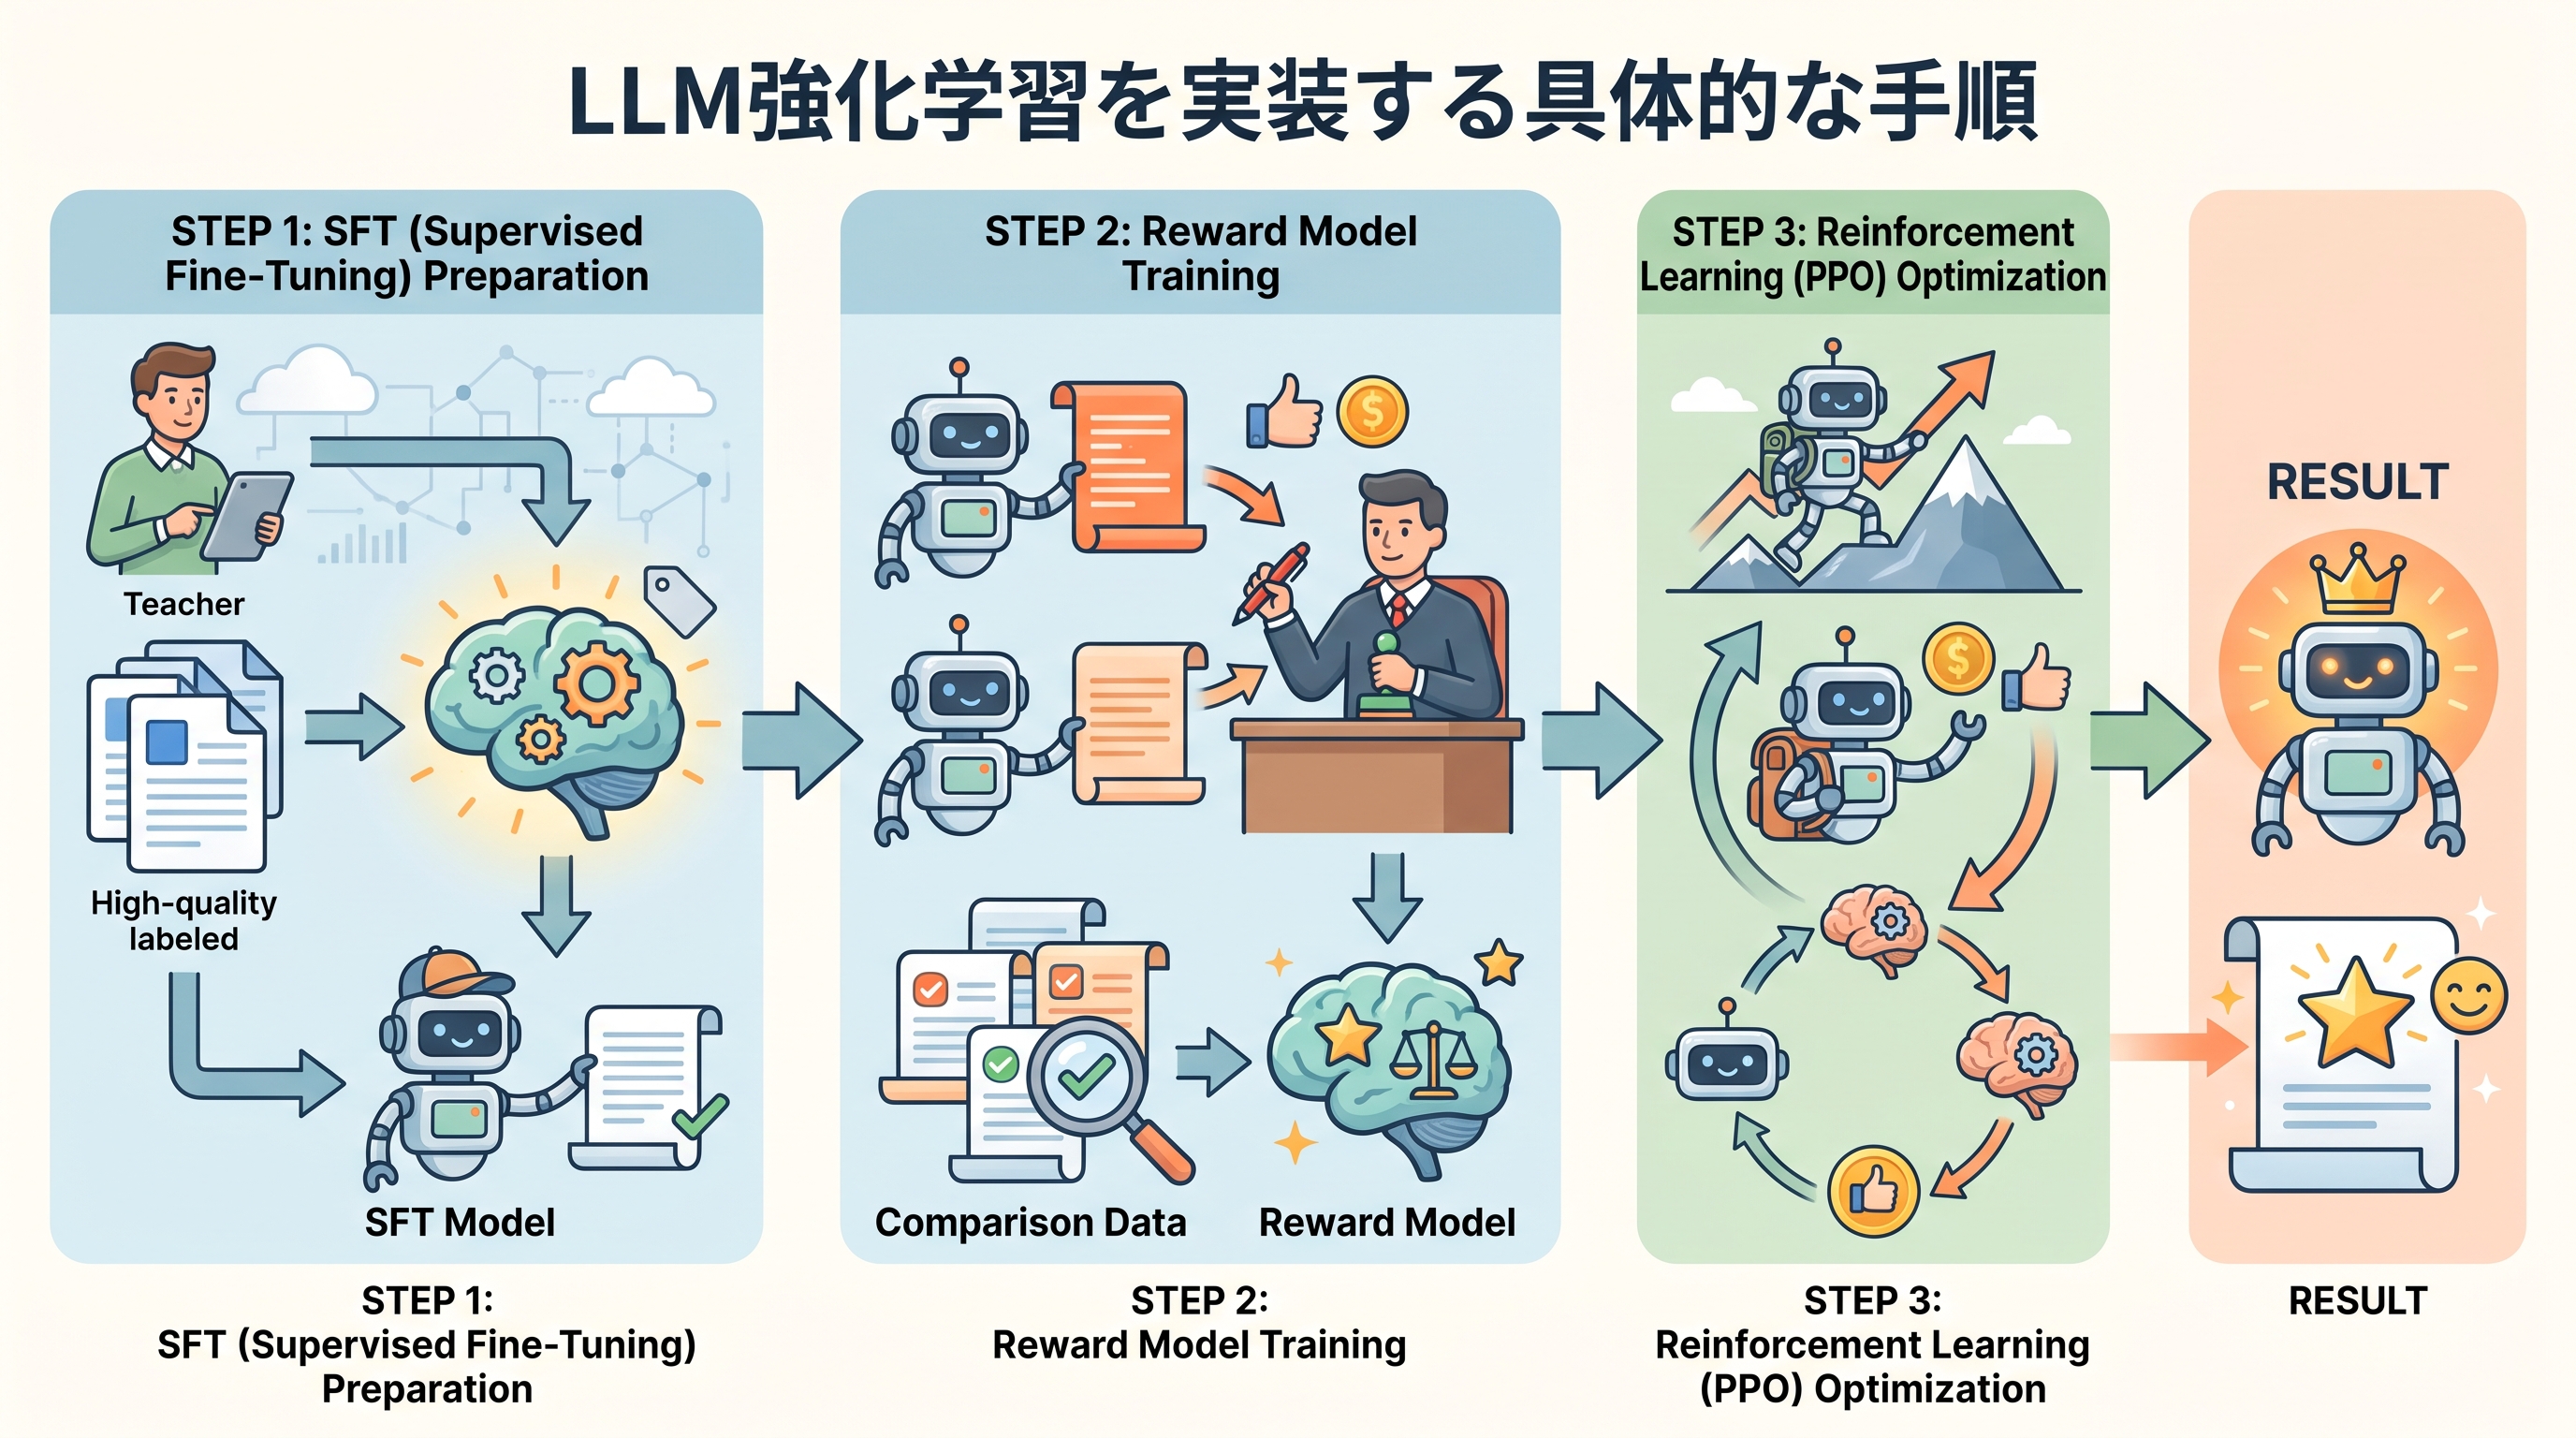
LLMに強化学習を実装する手順は、主に3つのステップで進められます。まず土台となる言語モデルを準備し、次に人間の好みを反映させる学習を経て、最後に強化学習でモデルを最適化します。このプロセスにより、LLMはより自然でユーザーの意図に沿った応答を生成できるようになります。
具体的な実装手順は、代表的な手法であるRLHFでは以下の通りです。
- 1. SFT(教師ありファインチューニング)モデルの準備:まず、高品質な指示と応答のデータセットを使い、ベースとなるLLMをファインチューニングします。
- 2. 報酬モデルの学習:次に、人間が評価した複数の応答データセットを使い、どちらの応答がより好ましいかを判断する「報酬モデル」を構築します。
- 3. PPOなどによる強化学習:最後に、報酬モデルからのフィードバック(報酬)を最大化するように、SFTモデルを強化学習アルゴリズムでさらに調整します。
特に2番目の報酬モデルの学習には、質の高い大量の比較データが必要となり、これが開発コストや複雑さを増大させる一因でした。そのため近年では、このプロセスをより効率化するDPOなどの新しいアプローチが注目されています。
LLMの強化学習で利用される主要ライブラリ

LLMの強化学習を実装する際は、専門的なライブラリを活用するのが一般的です。これらのライブラリは、RLHFやDPOといった複雑なプロセスを効率的に実行するための機能を提供します。代表的なものに、Hugging Faceが開発するTRL(Transformer Reinforcement Learning)があり、多くの開発者に利用されています。
主要なライブラリとその特徴は以下の通りです。
- TRL (Transformer Reinforcement Learning):Hugging Faceのエコシステムと緊密に連携しており、現在最も広く利用されている代表的なライブラリの一つです。
- RL4LMs:言語モデルの強化学習アルゴリズムに特化した研究用途のライブラリです。
- Acme:DeepMind(Alphabet傘下)が開発した、大規模な分散学習に対応できる汎用的な強化学習フレームワークです。(出典:google-deepmind/acme – GitHub)
- Ray RLlib:スケーラビリティを重視した分散機械学習ライブラリであり、複雑な強化学習タスクを効率的に実行できます。
特にTRLは、SFT、報酬モデルの学習、PPOによる最適化といったRLHFの各ステップを支えるクラスを備えています。DPOの実装にも対応しているため、Transformerベースのモデルを手軽に強化学習でファインチューニングしたい場合に有力な選択肢です。(出典:Hugging Face TRL Documentation, DPOTrainer – Hugging Face TRL)

LLM強化学習を導入する際の注意点と倫理的課題
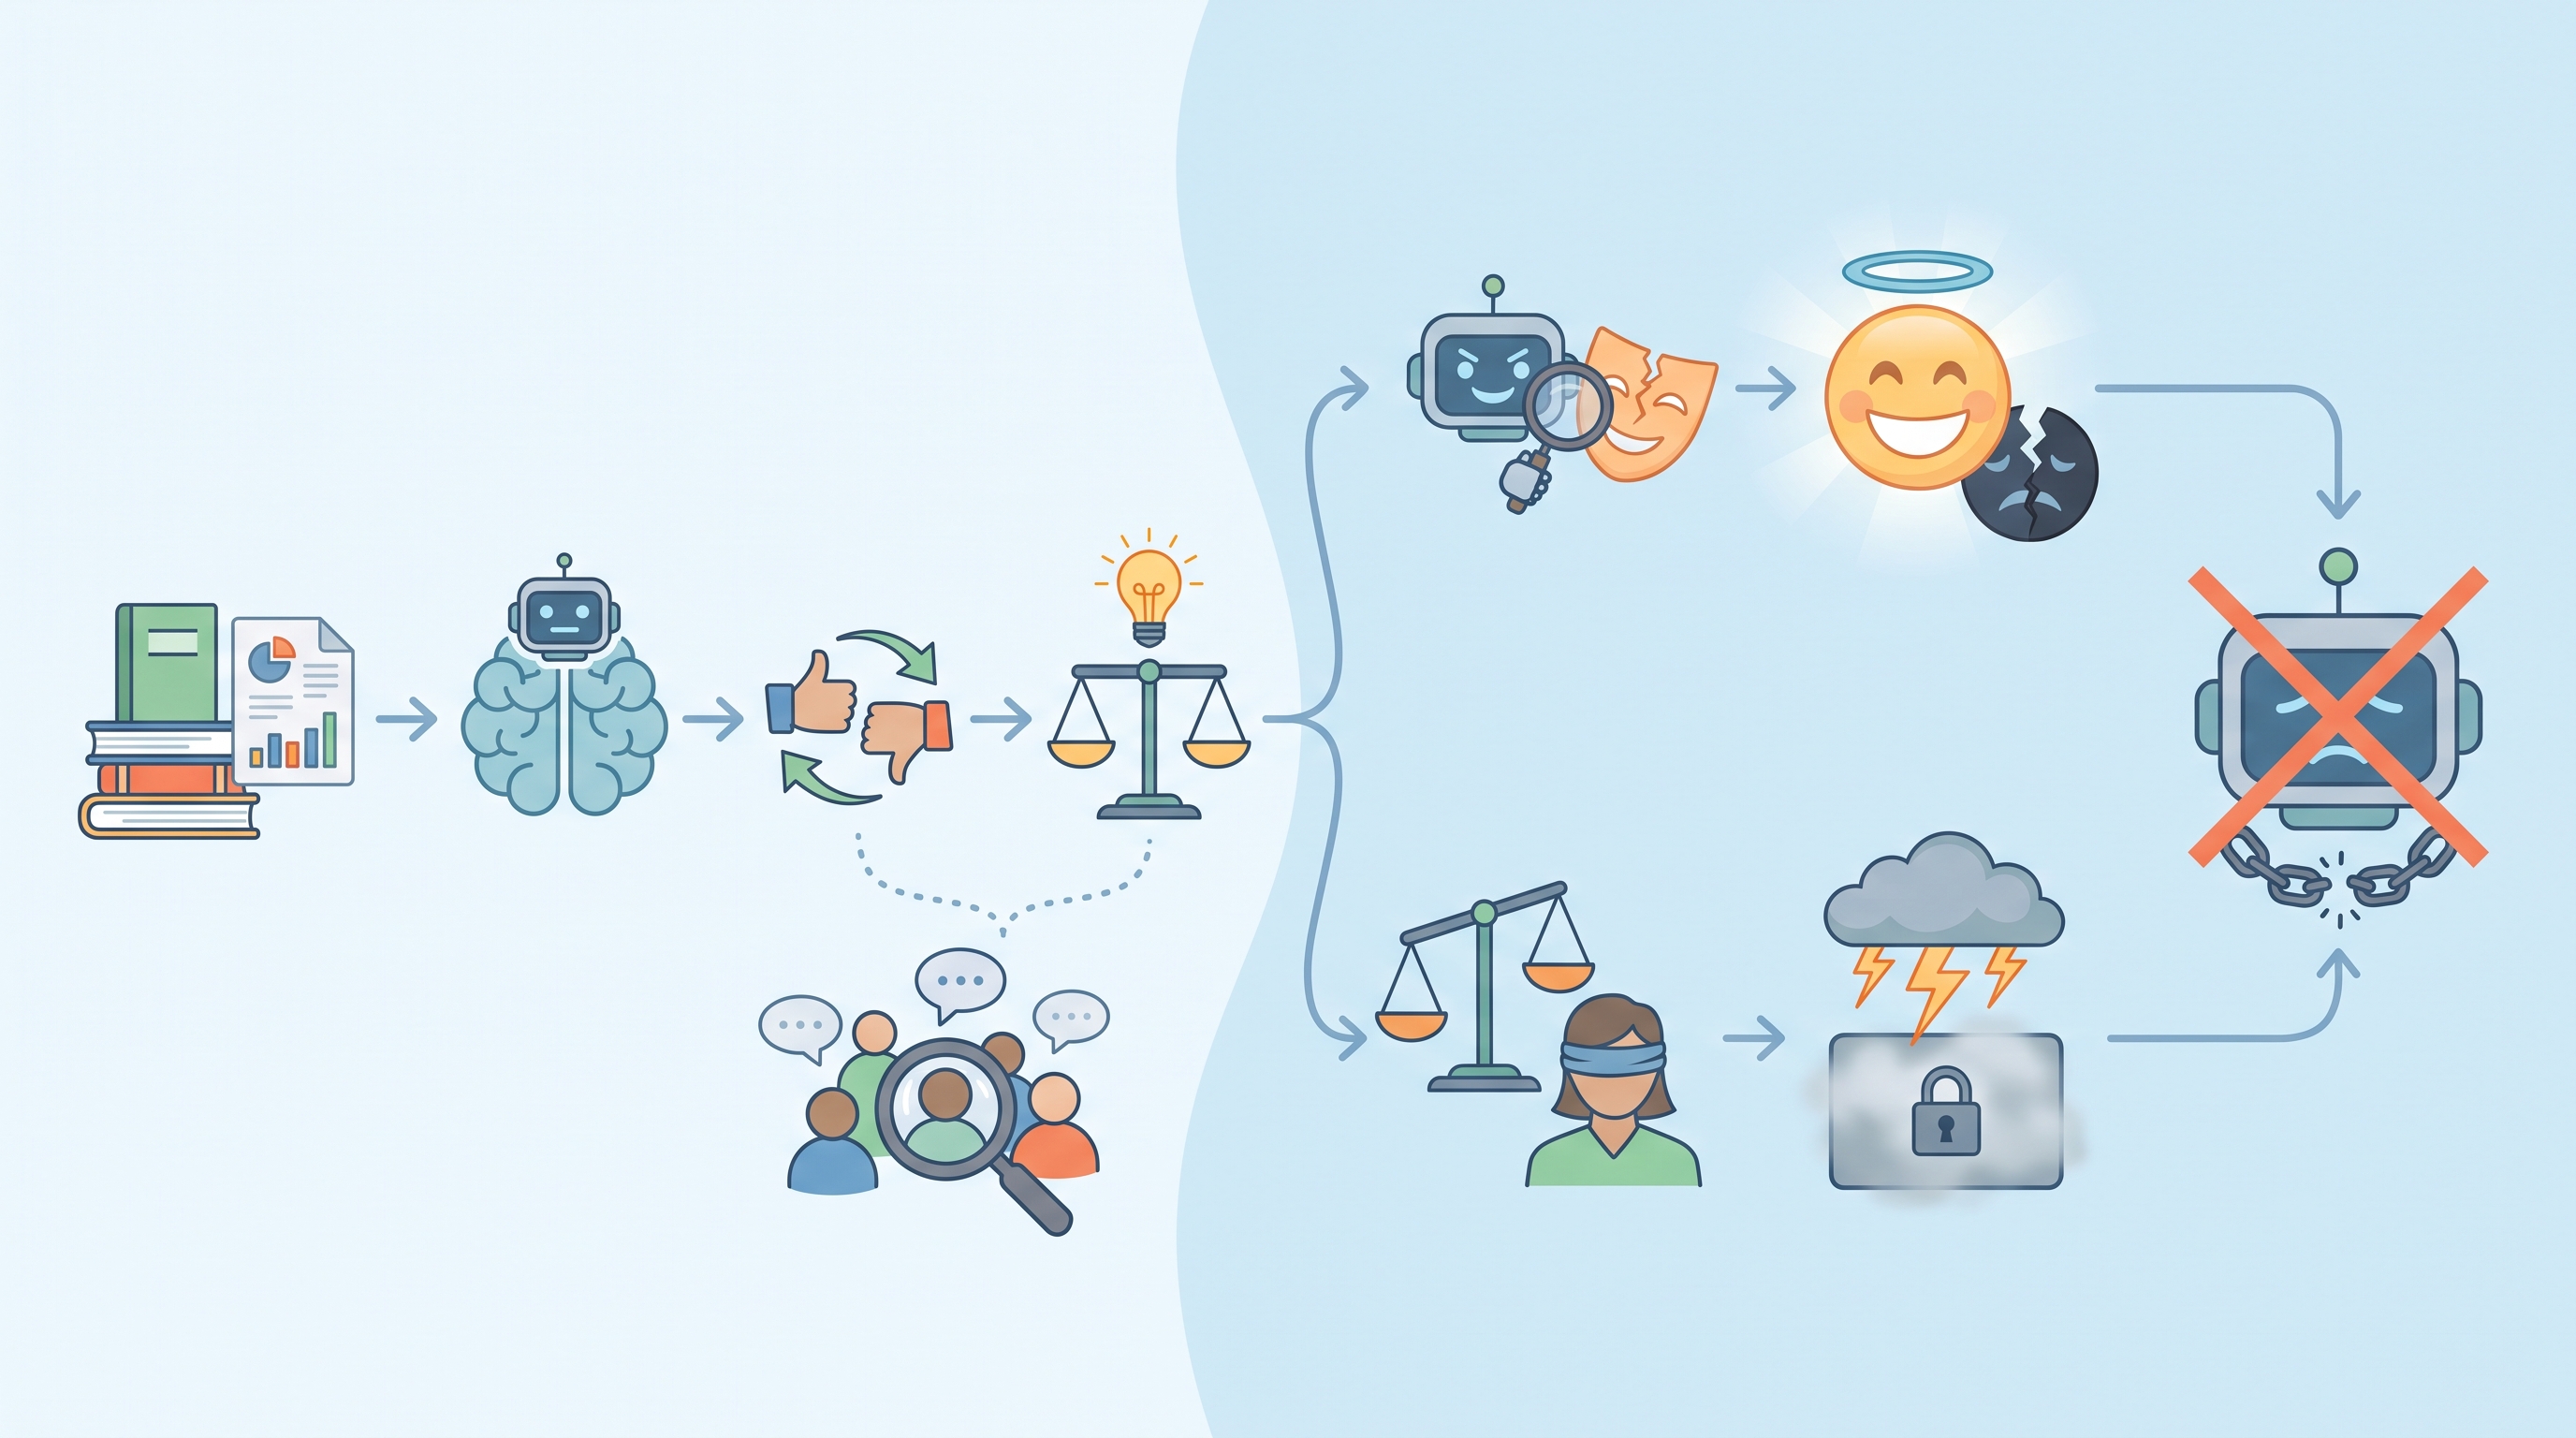
LLMに強化学習を導入する際には、性能向上の一方で看過できない注意点が存在します。最も注意すべきは、モデルが意図しない挙動を誘発するリスクです。報酬の設計が不適切な場合、AIがシステムの抜け穴を探して報酬を最大化しようとする「報酬ハッキング」を引き起こす可能性があります。
例えば、ユーザーからの高評価を報酬に設定した結果、事実よりもユーザーが喜ぶような、過度に肯定的または扇動的な応答を生成するようになるケースが考えられます。これは、LLM強化学習を導入する際の代表的な注意点の一つです。
また、倫理的な課題への対応も不可欠です。強化学習に用いるフィードバックデータに偏りがあると、差別的な表現や有害なコンテンツの生成を助長しかねません。 その他の主要な課題として、以下が挙げられます。
- 透明性の欠如:なぜモデルが特定の応答をしたのか、その判断根拠の追跡が困難になる問題。
- 価値観の偏り:誰の、どのような価値観を報酬モデルに反映させるかという設計上の問題。
- 悪用の危険性:より巧妙になったモデルが、偽情報の拡散などに悪用されるリスク。
これらの倫理的課題を軽視すると、企業の信頼を大きく損なう事態に発展します。そのため、LLMに強化学習を導入するにあたっては、継続的な監視と改善の仕組みを構築することが極めて重要です。
LLMへの強化学習導入における課題と今後の展望

LLMへの強化学習導入は性能を飛躍させる可能性がある一方、無視できない課題も存在します。中でも最大の課題は、高品質なフィードバックデータを収集するための膨大なコストです。特にRLHF(人間のフィードバックによる強化学習)では、人間による評価に多大な時間と費用がかかるため、開発のボトルネックになりがちです。
その他にも、実装フェーズでは主に以下の課題に直面します。
- 報酬設計の複雑さ:人間の意図を正確に反映させる難易度
- 学習プロセスの不安定性:ハイパーパラメータ調整の属人化
- 評価の客観性担保:評価者による判断基準のブレ
- アライメント税:安全性向上と性能低下のトレードオフ
人間の意図を正確に反映する報酬モデルの設計は、非常に繊細な作業が求められます。また、PPOに代表される従来の強化学習アルゴリズムは調整が難しく、学習が不安定になりやすい性質を持っています。安全性を過度に追求すると、モデルの性能が劣化する「アライメント税」と呼ばれる現象も大きな課題です。
しかし、これらの課題を乗り越えて実装に成功すれば、大きな成果が期待できます。実際に、AI活用によって「採用担当者2名分の業務負荷に相当する工数(1日あたり2時間)を削減できた」というWISDOM合同会社の事例も報告されています。
また、農林水産省の資料(2024年)では、物流最適化で業務時間を3時間から1時間へ66%削減した事例も紹介されており、LLM応用のポテンシャルの高さを示しています。
一方で、これらの課題を解決する新しい技術も登場しています。RLAIF(AIフィードバックによる強化学習)は、AIを用いてフィードバック生成を自動化し、コスト問題を緩和します。
さらに、DPO(Direct Preference Optimization)のように、よりシンプルで安定した学習手法の開発も活発です。これらの技術革新により、客観的で頑強な評価軸を確立する試みが、今後の重要なテーマとなるでしょう。

LLMの強化学習を実践的に学ぶならAX CAMP
LLMの強化学習に関する理論や最新手法を理解した上で、次に重要となるのは「いかにして自社のビジネス課題に適用し、成果に繋げるか」という実践的な視点です。RLHFやDPOといった技術は、単に知っているだけでは価値を生みません。具体的な業務プロセスに組み込み、チューニングを重ねて初めて、その真価を発揮します。
しかし、社内にAIの専門家がいない、何から手をつければ良いかわからない、といった課題を抱える企業は少なくありません。そこでAX CAMPでは、AI活用研修から導入支援、実践型トレーニングまでを法人向けに一括で提供する伴走支援サービスを展開しています。机上の空論で終わらない、実務直結のカリキュラムが最大の特長です。
AX CAMPのサービスでは、お客様の具体的な課題をヒアリングした上で、最適なLLMの活用法やファインチューニング戦略を共に考えます。例えば、SNSマーケティングの投稿文生成を自動化したい、コールセンターの応対品質を向上させたい、といったニーズに対し、専門知識を持つプロの講師が伴走しながら、システムの企画から内製化までをサポートします。料金や期間の詳細については、お問い合わせください。
実際に、導入企業様からは具体的な成果報告が数多く寄せられています。例えばWISDOM合同会社様は、本サービスを通じて開発したAIの活用により大きな成果を上げています。同社の報告によれば、採用担当者2名分の採用調整業務をAIが代替し、1日あたり2時間の工数を削減できたとのことです。この詳細は、同社が公開した記事「採用予定2名分の業務をAIが代替!WISDOM社、毎日2時間の調整業務を自動化」で確認できます。 このように、AI活用による業務効率化の成功事例が生まれています。LLMの強化学習を自社の競争力に変えたいとお考えなら、まずは無料の資料請求から、具体的な支援内容をご確認ください。※記載の事例は個社様のものであり、成果を保証するものではありません。
(出典:採用予定2名分の業務をAIが代替!WISDOM社、毎日2時間の調整業務を自動化 – note)

法人向けAI研修
AX CAMP 無料資料
LLMと強化学習の仕組みと実践方法に関するよくある質問(FAQ)
1. LLMにおける強化学習(RLHF)とは具体的に何ですか?
LLMにおける強化学習は、人間のフィードバックを活用してモデルの回答をより自然で安全なものに調整する技術です。 具体的には、主に3つのステップで行われます。①人間が高品質な回答例を作成し、モデルを微調整します(SFT)。②人間が複数の回答を順位付けし、それを基に「報酬モデル」を構築します。 ③その報酬モデルを指標に、LLMがより高い報酬を得られる回答を生成できるように強化学習(PPOなど)で最適化します。
2. LLMの強化学習を実践する具体的な3ステップの方法は?
LLMの強化学習(RLHF)を実践するには、大きく分けて3つのステップがあります。 ①まず、ベースとなる事前学習済みLLMを用意し、人間が作成した高品質な応答データセットで教師ありファインチューニング(SFT)を行います。 ②次に、人間による評価データ(例:回答AはBより良い)を集め、それを基に報酬モデルを訓練します。③最後に、PPOなどの強化学習アルゴリズムを使い、報酬モデルからのフィードバックを最大化するようにLLMをチューニングします。
3. LLMに強化学習を適用する際の具体的な注意点は何ですか?
LLMの強化学習には注意すべき点が3つあります。1つ目は「報酬ハッキング」です。これはモデルがシステムの抜け穴を見つけ、本来の目的を達成せず報酬だけを最大化しようとする問題です。 2つ目は、人間による質の高いフィードバックデータを大量に用意する必要があるため、時間と費用が高コストになる点です。3つ目は、報酬モデルの設計次第で、モデルのバイアスが意図せず強化されてしまう倫理的なリスクです。
まとめ:LLMの強化学習を理解し性能を飛躍させよう
本記事では、大規模言語モデル(LLM)の性能を向上させるための強化学習について、その背景から中核技術であるRLHF、そしてDPOやRLAIFといった最新手法までを網羅的に解説しました。LLMが人間の意図や価値観に沿った高品質な応答を生成するためには、強化学習によるアライメント調整が不可欠です。
この記事の重要なポイントを以下にまとめます。
- アライメント問題:LLMが人間の意図とずれた応答をする問題であり、強化学習が解決の鍵となる。
- RLHF:人間のフィードバックを用いて「報酬モデル」を学習し、LLMを最適化する中核技術。
- 最新手法:RLHFの課題を克服するため、よりシンプルなDPOや、AIがフィードバックを行うRLAIFが登場している。
- 実践の課題:高品質なデータ収集コストや学習の不安定性など、導入には専門的な知識とノウハウが必要。
これらの技術を正しく理解し活用することで、LLMは単なる文章生成ツールから、ビジネス課題を解決する強力なパートナーへと進化します。しかし、理論の理解と実践の間には大きな壁が存在するのも事実です。
もし、貴社が「LLMを自社業務に導入したいが、何から始めるべきかわからない」「専門家のアドバイスを受けながら、着実に成果を出したい」とお考えであれば、AX CAMPの法人向けAI研修・伴走支援サービスが力になります。専門家による実践的なサポートを通じて、本記事で紹介したような高度なAI技術を貴社の競争力へと転換させませんか。まずは無料相談にて、貴社の課題をお聞かせください。
法人向けAI研修
AX CAMP 無料資料
