
「社内の機密情報や顧客データをAIに入力するのは不安だ」
「インターネットに接続できない環境でも、安定して使えるAIはないだろうか」——。ChatGPTをはじめとするクラウド型AIの業務活用が進む一方で、このようなセキュリティや運用面の課題を感じている企業は少なくありません。
その有力な解決策となるのが、本記事で解説する
「ローカルLLM」です。ローカルLLMとは、自社のPCやサーバーといった閉じられた環境(ローカル環境)で動作する大規模言語モデル(LLM)のこと。データを外部に送信することなく、安全にAIを活用できるため、多くの企業から注目を集めています。
この記事を読めば、ローカルLLMの基本的な仕組みから、クラウド型との違い、具体的な導入方法、そしてビジネスに最適なモデルの選び方まで、網羅的に理解できます。AI活用を次のステージへ進めるための、実践的な知識をぜひ手に入れてください。
また、AIのビジネス活用に関するより具体的なノウハウや、導入を成功させるためのステップをまとめた資料もご用意しております。ご興味のある方は、ぜひダウンロードしてご活用ください。
法人向けAI研修
AX CAMP 無料資料
ローカルLLMとは?クラウド型との違いを解説

結論から言うと、ローカルLLMはユーザー自身のPCや社内サーバー上で直接動作させる大規模言語モデルを指します。インターネットを介して外部のサーバーで処理されるクラウド型LLMとは、データの置き場所と処理方法が根本から違う、と理解するのが最も分かりやすいでしょう。
この違いが、セキュリティ、カスタマイズ性、コスト構造など、多くの面での特性の差となって現れます。自社の目的や環境に合わせて最適な選択をするためには、両者の違いを正確に理解することが不可欠です。まずは、その基本的な仕組みから見ていきましょう。
(出典:AX CAMP導入事例)
ローカルLLMの基本的な仕組み
ローカルLLMは、モデルのプログラム本体と、学習済みの膨大なデータ(パラメータ)をすべて手元のコンピュータにダウンロードして使用します。ユーザーが何かを質問・指示すると、その処理はPCやサーバー内部のCPUやGPUを使って完結します。そのため、正しく構築・設定すれば、ローカル環境で推論を完結させ外部へデータを送信せずに運用できます。
ただし、使用するツールのテレメトリ機能やネットワーク設定によっては意図せず外部通信が発生する場合があるため、導入前にプライバシーとネットワーク構成を必ず監査してください。インターネット接続が不要でオフライン環境でも安定して利用できる点も、クラウド型にはない大きなメリットと言えます。(出典:Offline-First – LM Studio)
クラウド型LLM(ChatGPTなど)との比較

| 比較項目 | ローカルLLM | クラウド型LLM (例: ChatGPT) |
|---|---|---|
| データ処理場所 | 自社のPC・サーバー(内部) | 提供元のサーバー(外部) |
| セキュリティ | 適切に設計・設定すればリスクを大幅に低減可能(※監査と運用ルールの整備が必須) | 提供元の高度なセキュリティ基準に準拠 |
| オフライン利用 | 可能 | 原則としてオンライン接続が必要 |
| カスタマイズ性 | 高い(自社データで再学習可能) | API等を通じた提供範囲内での調整 |
| 導入コスト | 初期投資(高性能PC等)が必要 | 比較的低い(月額料金制が多い) |
| 運用コスト | 電気代・人件費が主 | 利用量に応じた従量課金 |
| 導入・運用の手間 | 専門知識が必要 | 比較的容易 |
ローカルLLMとクラウド型LLMの主な違いを、上の表にまとめました。クラウド型は、OpenAI社のChatGPTやGoogle社のGemini 3.5のように、手軽に最高性能のAIを利用できる利点があります。一方でローカルLLMは、セキュリティとカスタマイズ性で優位性を持つ点が大きな特徴です。
例えばセキュリティの観点では、クラウド型はサービス提供事業者の堅牢なインフラに依存しますが、自社のデータを外部サーバーへ送信する必要があります。 これに対し、ローカルLLMは自社のネットワーク内でデータ処理が完結するため、機密情報の漏洩リスクを管理しやすい点がメリットです。
また、オフラインでの利用可否も重要な違いです。ChatGPTなどのクラウド型AIは、応答を生成するためにインターネット接続が必須です。 一方、ローカルLLMはPCやサーバーに導入したモデルが直接処理を行うため、ネットワークから切り離された環境でも安定して稼働します。
このように、どちらか一方が絶対的に優れているわけではありません。自社の「守るべきデータ」と「達成したい目的」に応じて、最適な選択肢は変わります。次の章では、ローカルLLMを選ぶ具体的なメリットを深掘りします。

ローカルLLMを導入する3つのメリット

ローカルLLMを導入する主な動機は、データ保護レベルの向上、運用コストの最適化、そして独自のデータによる深いカスタマイズ性の3点に集約されます。これらのメリットについて、具体的に解説します。
- 高度なデータ保護とセキュリティ
機密情報を外部サーバーに送信せず、自社の管理下で処理を完結できる点が最大の利点です。これにより、顧客情報や技術情報などの情報漏洩リスクを大幅に低減できます。また、インターネット接続が必須ではないため、オフライン環境での運用も可能です。(出典:LM Studio Documentation, Offline-First) - 運用コストの最適化と柔軟性
クラウドサービスで一般的なAPI利用料のような従量課金は発生しません。そのため、利用頻度に依存しない固定費での運用が見込めます。ただし、導入後の総コストには、ソフトウェアライセンス、サポート契約、ハードウェアの保守費用などが含まれる場合があるため、事前の確認が重要です。 - 独自のデータによる深いカスタマイズ
自社特有のデータでモデルをファインチューニングし、専門用語や業務文脈に最適化されたAIを構築できます。実際に、従来24時間(86,400秒)を要した処理が10秒へ短縮され、約99.99%(厳密には99.9884%)の時間削減を達成した事例も報告されています。
これらのメリットは、特に機密情報を扱う金融機関や研究開発部門、あるいは独自のAI活用で競争優位性を築きたい企業にとって、大きな魅力となるでしょう。
(出典:AX CAMP導入事例( llm temperature))
高度なセキュリティとデータプライバシーの確保
ローカルLLMがもたらす最大のメリットは、適切に環境を構築・運用することで、データが外部に送信されるリスクを大幅に低減できる点です。顧客情報、財務データ、技術情報といった機密性の高い情報を扱う際、クラウドサービス利用時に懸念される情報漏洩のリスクを自社の管理下でコントロールできます。(出典:ローカルLLMとは? ChatGPTとの違いやメリット・デメリット、代表的なモデルを解説 – @IT)
これは、外部のセキュリティポリシーに依存せず、自社の基準で能動的にデータを守れることを意味します。金融、医療、法務など、特に厳しいデータ管理が求められる業界において、このメリットはAI導入の前提条件とも言えるでしょう。(出典:Offline-First – LM Studio)
運用面の柔軟性(オフライン利用・コスト管理)
ローカルLLMは、インターネット接続がない環境でもAIを利用できる点が大きな利点です。例えば、通信が不安定な工場や建設現場、あるいはセキュリティ上隔離された研究開発部門などでも、LLMの能力を最大限に活用できます。(出典:Offline-First – LM Studio)
また、機密情報を扱う金融機関の閉域網内や、災害時など通信が遮断された状況でも業務を継続できる冗長性の確保にもつながります。クラウドサービスでも専用インスタンスなどで対応できる場合はありますが、ローカル環境はより柔軟な運用を実現します。
さらに、コスト管理がしやすい点も見逃せません。クラウド型のAIサービスがAPI利用料など従量課金が基本であるのに対し、ローカルLLMは自社設備で運用するため、コスト構造が異なります。
一度環境を構築すれば、APIコール数やトークン量に応じた追加費用は発生しません。そのため、利用頻度を気にせず大量のテキスト生成やデータ分析を実行でき、長期的な総コストを抑制できる可能性があります。(出典:ローカルLLMのランニングコスト試算 / 2026年 / Linux Master)
もちろん高性能なGPUサーバーなどの初期投資は必要です。しかし、開発段階でのトライアルや定常的な大規模処理など、API利用が膨大になるケースでは、クラウドのAPI利用料よりも総コストを低く抑えられる可能性があります。
(出典:LM Studio Offline)
独自のデータセットによる高度なカスタマイズ性
ローカルLLMは、社内に蓄積された独自のデータを使ってモデルを再学習(ファインチューニング)させることが可能です。これにより、業界特有の専門用語や社内独自の言い回しを理解し、業務内容に特化した高精度な応答を生成する「自社専用AI」を構築できます。
例えば、過去の問い合わせ履歴を学習させて高精度な社内向けチャットボットを開発したり、社内ナレッジを学習させて検索精度を向上させたりと、活用方法は無限大です。汎用的なクラウド型LLMでは難しい、業務に深く根差したAI活用が実現します。
法人向けAI研修
AX CAMP 無料資料

知っておくべきローカルLLMの2つのデメリット

多くのメリットがある一方で、ローカルLLMの導入には高性能なハードウェアへの初期投資と、環境構築・運用を担う専門知識という2つのハードルが存在します。これらの課題を理解し、適切な対策を講じることが導入成功の鍵です。
確かに、高性能なPCやサーバーが必要になるケースは少なくありません。しかし、必ずしも高額な初期投資が必須というわけではありません。例えばAX CAMPでは、お客様の予算や目的に応じた最適なハードウェア選定を支援します。クラウド環境の活用など、初期費用を抑えるプランのご提案も可能です。
また、環境構築や継続的な運用にはAIやインフラの専門知識が求められます。この点も、自社に専門家がいない場合、AX CAMPのエンジニアが伴走支援することで解決できます。事前のコンサルティングで費用対効果を明確にした上で判断できるため、安心して導入を進められます。
高性能なハードウェアへの初期投資
LLMを快適に動作させるには、高性能なGPU(Graphics Processing Unit)を搭載したPCやサーバーが不可欠です。特に、モデルの性能を左右する「パラメータ数」が大きくなるほど、より多くのVRAM(ビデオメモリ)容量が必要になります。
一般的なオフィス用PCではスペックが不足することが多く、モデルによっては数十万円から数百万円の初期投資が必要になる場合があります。このハードウェアコストが、特に中小企業にとって導入の際の大きな障壁となる可能性があり、投資対効果の慎重な見極めが求められます。

専門知識と継続的な自己管理の必要性
ローカルLLMの導入と運用には、ITインフラやAIに関する専門知識が求められます。どのモデルを選定し、どのようにPC環境を構築するか、また導入後に発生するトラブルにどう対処するかなど、自社で判断・解決しなければならない場面が多くあります。
また、新しいモデルが次々と登場するため、継続的に情報を収集し、システムをアップデートしていく手間も発生します。クラウド型サービスのように手軽に始められるわけではなく、運用管理のための人的リソースや属人化のリスクも考慮しておく必要があります。

ローカルLLMの具体的な活用シーンと業界事例

ローカルLLMは、その高いセキュリティ性とカスタマイズ性を活かし、社内の機密情報を扱う業務や、特殊な専門知識が求められる分野で特に強力なツールとなります。具体的な活用シーンと、実際の導入事例を紹介します。
例えば、製造業の現場では、過去の膨大な設計図書や仕様書をローカルLLMに学習させる活用法があります。この取り組みにより、類似案件の検索や技術的な問い合わせ対応にかかる時間を大幅に短縮できます。
実際に、ある導入事例では、熟練技術者が1時間以上かけていた調査が平均10分程度で完了するという成果も報告されています(出典:AX MEDIA)。このように、専門知識の検索や活用業務で大きな効果を発揮します。
その他にも、様々な業界でローカルLLMの活用が期待されています。
- 金融・保険業界
市場分析レポートの作成や、コンプライアンスチェックの自動化など、機密性の高い顧客データや財務情報を安全に扱う業務で役立ちます。 - 法曹界
膨大な判例や法律文書の中から、関連性の高い情報を瞬時に検索・要約できます。契約書のドラフト作成支援などにも応用可能です。 - 医療・製薬
患者の個人情報や新薬の研究開発データなど、外部漏洩が許されない情報を保護しつつ、論文検索やデータ解析の効率を高められます。
社内データ(文書・コード)のセキュアな活用
多くの企業では、社内規定、マニュアル、過去の議事録、顧客とのやり取りなど、膨大な量のテキストデータが蓄積されています。ローカルLLMを使えば、これらの機密情報を外部に出すことなく安全に活用できます。
具体的な活用例としては、以下のようなものが挙げられます。
- 社内規定問い合わせAIチャットボット
- 過去の類似案件の検索・要約
- ソフトウェアのソースコードレビュー支援
- 契約書や申請書類の自動チェック
これらの業務をAIで自動化・効率化することで、従業員はより付加価値の高い業務に集中できるようになります。
医療・金融業界におけるデータ分析と活用事例
個人情報や機密情報の塊である医療・金融業界は、ローカルLLMの活用が特に期待される分野です。例えば、医療分野では電子カルテの情報を学習させ、医師の診断を補助するAIを開発したり、金融分野では市場データや企業情報を分析し、投資判断を支援するレポートを自動生成したりといった活用が進んでいます。ただし、金融商品の投資助言に該当する利用は関連法令の対象となる場合があり、最終的な投資判断は専門家の監督下で行うなど、適切なコンプライアンス体制の構築が不可欠です。
実際にAX CAMPの研修を導入した企業でも、AI活用による劇的な業務効率化が実現しています。
Route66様の事例
マーケティング支援を手掛けるRoute66様では、コンテンツ制作における原稿執筆が大きな時間的負担となっていました。AX CAMPの研修を通じてAIライティングのノウハウを習得した結果、従来24時間かかっていた原稿執筆の初稿作成が、わずか10秒で完了(※)し、圧倒的な生産性向上を実現しました。(※AIによる初稿生成に要した時間)(出典:AX CAMP導入事例, AI導入支援サービス事例, AI研修ロードマップ)
WISDOM合同会社様の事例
SNS広告やショート動画制作を行うWISDOM合同会社様は、事業拡大に伴う人材採用コストと業務負荷の増大に悩んでいました。AX CAMPでAI活用スキルを習得し、業務自動化を推進した結果、事業拡大に必要な業務の一部をAIで代替することに成功しました。これにより、採用予定だった2名分の業務をAIが担い、コストの最適化と既存メンバーの業務効率化を同時に達成しています。(出典:生成AIによるマニュアル作成業務の効率化事例, AI人材育成による採用コスト削減事例, AI社員研修による業務効率化事例)
エムスタイルジャパン様の事例
美容健康食品の製造販売を行うエムスタイルジャパン様では、コールセンターの履歴確認や手作業による広告レポート作成に多くの時間を要していました。AX CAMPの研修でGAS(Google Apps Script)とAIを組み合わせた業務自動化を学んだ結果、これらの定型業務を効率化しました。
具体的には、これまで多くの時間を要していた業務の自動化に着手しました。AI導入前後で作業時間を計測した結果、削減効果の内訳は以下の通りです。
削減対象の業務 月間削減時間(実績) 測定方法・比較期間
この取り組みにより、合計で月100時間以上の業務を削減することに成功しています。 従業員はより付加価値の高いコア業務へ集中できるようになりました。(出典:AX CAMP導入事例, AI活用事例, 生成AI活用事例)
【2026年最新】目的別おすすめローカルLLMモデル5選

ローカルLLMのモデル選定では、性能の高さ、ライセンス(商用利用の可否)、そして実行に必要なPCスペックの3つの観点から、自社の目的に合ったものを選ぶことが重要です。ここでは、2026年時点で特に注目されている、目的別の代表的なオープンソースLLMを5つ紹介します。(公開日: 2026-08-12)
- Gemma 3(Google)
Googleの高性能モデル「Gemini」と同じ技術を基に開発されたオープンモデル群です。 テキストと画像のマルチモーダル入力に対応し、128Kという長いコンテキストウィンドウも特徴です。 商用利用も可能ですが、独自の「Gemma Terms of Use」への同意が必須であり、利用規約を必ず確認し、禁止事項に抵触しないか注意が必要です。 - Llama 3.1(Meta)
Metaが公開した、8B・70B・405Bという複数のパラメータサイズを持つLLMファミリーです。 各種ベンチマークでGPT-4などの主要モデルに匹敵する高い性能を示しています。 研究から商用利用まで幅広く活用できますが、月間アクティブユーザー数が7億人を超えるサービスでの利用には、Metaへ別途ライセンスを申請する必要があります。 - Mistral(Mistral AI)
フランスのMistral AI社が開発する高性能なモデル群です。多くのオープンソースモデルが商用利用しやすいApache 2.0ライセンスで公開されており、開発者から高い支持を得ています。 ただし、一部のモデルでは異なるライセンスが適用されるため、利用するモデルの公式ドキュメントやモデルカードを個別に確認することが必須です。 - Phi-3(Microsoft)
Microsoftが開発した「小型言語モデル(SLM)」のファミリーです。 パラメータ数を抑えた「Phi-3-mini」は、スマートフォンなどリソースが限られた環境でも高速に動作するよう設計されています。 ライセンスはMIT Licenseで提供されており、比較的自由な利用が可能です。 - CyberAgentLM3(サイバーエージェント)
サイバーエージェント社がゼロから開発した、225億パラメータを持つ日本語特化LLMです。 日本の文化や商習慣に関する知識が豊富で、日本語のタスクで高い性能が期待できます。 ライセンスは商用利用が可能なApache License 2.0で、公式情報はHugging Faceで公開されています。
1. Gemma 3:多用途で高性能な汎用モデル
Googleが開発した「Gemma 3」は、同社の高性能モデル「Gemini」シリーズと同じ研究・技術を基に構築された、軽量かつ高性能なオープンモデルファミリーです。Googleの公式発表によると、Gemma 3は最先端の技術を活用しつつ、一般的なPCから高性能サーバーまで幅広い環境で動作するように設計されています。(出典:Gemma 3: A new generation of open models)
Gemma 3の大きな特徴は、用途に応じて選べる複数のモデルサイズが用意されている点です。これにより、個人の開発から企業のプロトタイピングまで、様々なハードウェア環境に対応できます。量子化というモデルを軽量化する技術が活用されており、少ないメモリでも効率的に動作させることが可能です。
さらに、テキストと画像の入力を処理できるマルチモーダル性能も備えています。文章の要約や質疑応答、簡単なコーディング支援といった基本的なタスクはもちろん、画像の内容を説明させるといった応用も可能です。性能と汎用性のバランスに優れており、まず試したいオールラウンダーなモデルと言えるでしょう。ただし、商用利用はGoogleが定める利用規約に従う必要があります。 派生モデルの作成や再配布にも条件があるため、ビジネスで活用する際は、必ず公式のライセンス情報を事前に確認してください。
(出典:AI Finetune)
2. Mistralシリーズ:多言語対応と効率性に優れたモデル
フランスのスタートアップMistral AIが開発したモデル群は、高い性能と電力効率の両立に定評があります。比較的少ない計算資源で高速に動作するため、ローカル環境での利用に適したモデルを複数提供している点が特徴です。
代表的なオープンソースモデルには、軽量ながら高性能な「Mistral 7B」や、複数の専門家(Experts)を組み合わせるMoE(Mixture of Experts)技術で効率を高めた「Mixtral 8x7B」などがあります。これらのモデルは、主に英語やフランス語、スペイン語などの欧州言語に強く、多言語でのタスク処理能力も優れています。
利用する上で最も重要な点はライセンスの確認です。Mistral AIは、モデルごとに異なる利用規約を定めています。例えば、多くのオープンソースモデルは商用利用も可能なApache 2.0ライセンスで公開されています。一方で、最新の高性能モデルは独自の商用ライセンスやAPI経由での提供となる場合があります。
そのため、利用前には必ずMistral AIの公式サイトで、使用したいモデルのライセンスを直接確認してください。これにより、意図しないライセンス違反を避けられます。
3. CyberAgentLM3:日本語処理に特化した高精度モデル
サイバーエージェントが開発した「CyberAgentLM3」は、日本語の処理に特化してゼロから学習された高性能な大規模言語モデル(LLM)です。モデルの規模は225億(22.5B)パラメータで、オープンソースとして公開されています。(出典:独自の日本語LLM(大規模言語モデル)のバージョン3を一般公開)
このモデルは、日本の文化や商習慣に関する知識を豊富に含んだデータで学習しています。そのため、日本語の読解力や対話能力を測る「Nejumi LLM リーダーボード3」では、より大きな700億パラメータを持つ海外モデルと同等の性能を示しており、自然で高精度な日本語を生成する能力に長けています。
さらに、Apache 2.0ライセンスで提供されている点も大きな特徴です。これにより、研究用途だけでなく商用目的での利用もできます。 日本語の精度を最優先するチャットボットやコンテンツ生成などの業務で特に力を発揮します。モデルやデモはHugging Faceで公開されており、誰でも試せます。(出典:Hugging Face – cyberagent/calm3-22b-chat)
4. Llama 3.1:Meta社が開発した最新オープンソースモデル
Meta社(旧Facebook)が開発を主導するLlamaシリーズの最新版が「Llama 3.1」です。(出典:meta-llama/llama-models – GitHub)このモデルは、特定の専門家モデルを組み合わせるMoE(Mixture-of-Experts)アーキテクチャではなく、安定性を重視した標準的なデコーダ専用Transformerアーキテクチャを採用しています。
Llama 3.1は複数のサイズで提供されており、特に4050億パラメータを持つ「405B」モデルは、オープンソースモデルとして最高峰の性能を誇ります。 Meta AIの公式発表によると、この巨大なモデルはクローズドソースの代表的なモデルであるGPT-5.4などと競合する性能を、多くのベンチマークで示しています。(出典:Introducing Meta Llama 3.1)
Llama 3.1の主な特徴は以下の通りです。
- 巨大なモデルサイズ:405Bモデルは、複雑な推論や合成データ生成など、これまでオープンソースモデルでは難しかったタスクの実行を可能にします。
- 長い文脈(コンテキスト)の理解:扱える情報量が最大128Kトークンに拡張され、長文のドキュメント読解や要約の精度が向上しました。
- 多言語対応の強化:日本語を含む8つの言語での対話能力が向上し、より幅広い用途で利用できます。
- ツール連携機能:外部ツールやAPIと連携する「ツール利用」の能力が最適化されており、単なる文章生成にとどまらない実用的なタスクを実行できます。
そのため、Llama 3.1はオープンソースで最先端の性能を求める開発者や研究者にとって、最適な選択肢の一つです。モデル自体は無料で利用でき、主要なクラウドサービスからも手軽に導入できるため、高性能なAIを自社のシステムに組み込む際の有力な候補となります。
5. Phi-3:低スペックPCでも動作可能な軽量モデル
Microsoftが開発した「Phi-3」は、「小さいのに賢い」をコンセプトにした軽量な言語モデル(SLM: Small Language Model)ファミリーです。 Microsoftの公式技術レポート「Phi-3 Technical Report」で詳細が公開されており、高品質なデータで学習させることで、サイズを抑えつつ高い性能を実現しています。
Phi-3ファミリーは、性能とサイズの異なる複数のモデルで構成されており、ユーザーは環境に応じて最適なモデルを選択できます。
- Phi-3-mini (38億パラメータ): スマートフォンなど、リソースが限られた環境でも高速に動作するよう設計されています。
- Phi-3-small (70億パラメータ): より高い性能を求める一般的なPCでの利用に適したバランスの取れたモデルです。
- Phi-3-medium (140億パラメータ): シリーズの中で最も高性能で、より複雑なタスクに対応できます。
これらのモデルは、パラメータ数を抑えながらも、同規模の他のモデルを上回る性能を発揮するのが特徴です。 実際に、最も小さいPhi-3-miniでも、より大きなモデルに匹敵する能力を持つと報告されています。 そのため、手元のPCで手軽に高性能なAIを試したい場合に最適な選択肢の一つです。

ローカルLLMを動かすための環境構築と必要スペック

ローカルLLMを導入する上で最も重要なのが、適切なPCスペックの確保です。モデルのパラメータサイズや量子化の方式によって、必要となるGPUのVRAM(ビデオメモリ)容量が大きく変動します。
例えば、同じモデルでも「量子化」というモデルを軽量化する技術を適用すれば、より少ないメモリで動作させられます。 4bitや5bitといった低いビット数で量子化されたモデルはVRAM消費を抑えられますが、元のモデルより精度が若干低下する可能性があります。
さらに、必要なVRAM容量は、Hugging Faceが提供するModel Memory Calculatorなどのツールで詳細に試算できます。 ただし、実際の要求スペックは利用するツール(Ollama、LM Studioなど)や実装状況でも変わるため、試算値はあくまで目安として捉えることが重要です。
また、高性能なGPUがないPCでも、CPUとメインメモリだけで動作させることは可能です。しかし、応答速度はGPU利用時より大幅に遅くなるため、チャットなどリアルタイムでの応答が求められる用途には向きません。
モデルサイズ別に必要なPCスペック(CPU/GPU/VRAM)
LLMの性能はパラメータサイズ(単位:B、Billion=10億)に依存し、サイズが大きくなるほど要求されるVRAM容量も増大します。ただし、必要なスペックはモデルの種類、量子化の度合い、使用ツールで大きく変わるため、以下の表はあくまで一般的な目安としてください。

| モデルサイズ | 必要VRAM容量(目安) | 推奨GPU(例) | 推奨RAM |
|---|---|---|---|
| ~7B(軽量) | 6GB ~ 8GB | NVIDIA GeForce RTX 3060 / 4060 | 16GB以上 |
| 7B ~ 14B(中規模) | 9GB ~ 12GB | NVIDIA GeForce RTX 3060 Ti / 4070 | 32GB以上 |
| 14B ~ 34B(大規模) | 16GB ~ 24GB | NVIDIA GeForce RTX 4080 / 4090 | 64GB以上 |
| 70B以上(超大規模) | 48GB以上(複数GPU推奨) | NVIDIA RTX 6000 Ada世代 | 128GB以上 |
上の表は、モデルを4bit量子化(モデルを軽量化する一般的な手法)した場合の目安です。VRAMの要求量はモデルの精度(量子化の度合い)に大きく依存します。例えば、7Bサイズのモデルでも、量子化をしない場合(16bit)は約14GB以上のVRAMが必要ですが、4bitに量子化すれば5GB〜6GB程度で動作させることもできます。
より正確なVRAM使用量を知るには、各種ツールや実測データを確認するのが確実です。Hugging FaceのModel Memory Calculatorで理論値を計算したり、OllamaやLM Studioといったツールの公式サイトで推奨スペックを確認したりする方法があります。 一方で、業務で現実的な応答時間を得るためにはGPUが強く推奨されます。小型で量子化されたモデルはCPUのみでも動作しますが、応答速度は限定的です。
法人向けAI研修
AX CAMP 無料資料
Windows, Mac, Linux別の環境構築のポイント
OSごとに環境構築の方法は若干異なりますが、近年はOllamaのようなツールが登場したことで、どのOSでも比較的簡単に導入できるようになりました。
- Windows: 以前は環境構築が複雑でしたが、WSL2(Windows Subsystem for Linux 2)の登場や、Ollama、LM StudioといったツールのWindows対応により、手軽に実行できるようになりました。
- Mac: Appleシリコン(Mシリーズチップ)搭載のMacは、CPUとGPUが統合されたユニファイドメモリにより、メモリを効率的に使えるためスペック表記以上の性能を発揮しやすい利点があります。Ollamaなどのツールもネイティブ対応しており、導入は比較的容易です。
- Linux: 開発者向けのツールが最も充実しており、環境構築の自由度が高いOSです。NVIDIA製GPUのドライバ設定など、ある程度の知識は必要ですが、最も柔軟な運用が可能です。
法人向けAI研修
AX CAMP 無料資料
主要なローカルLLM実行ツール比較(Ollama, LM Studioなど)
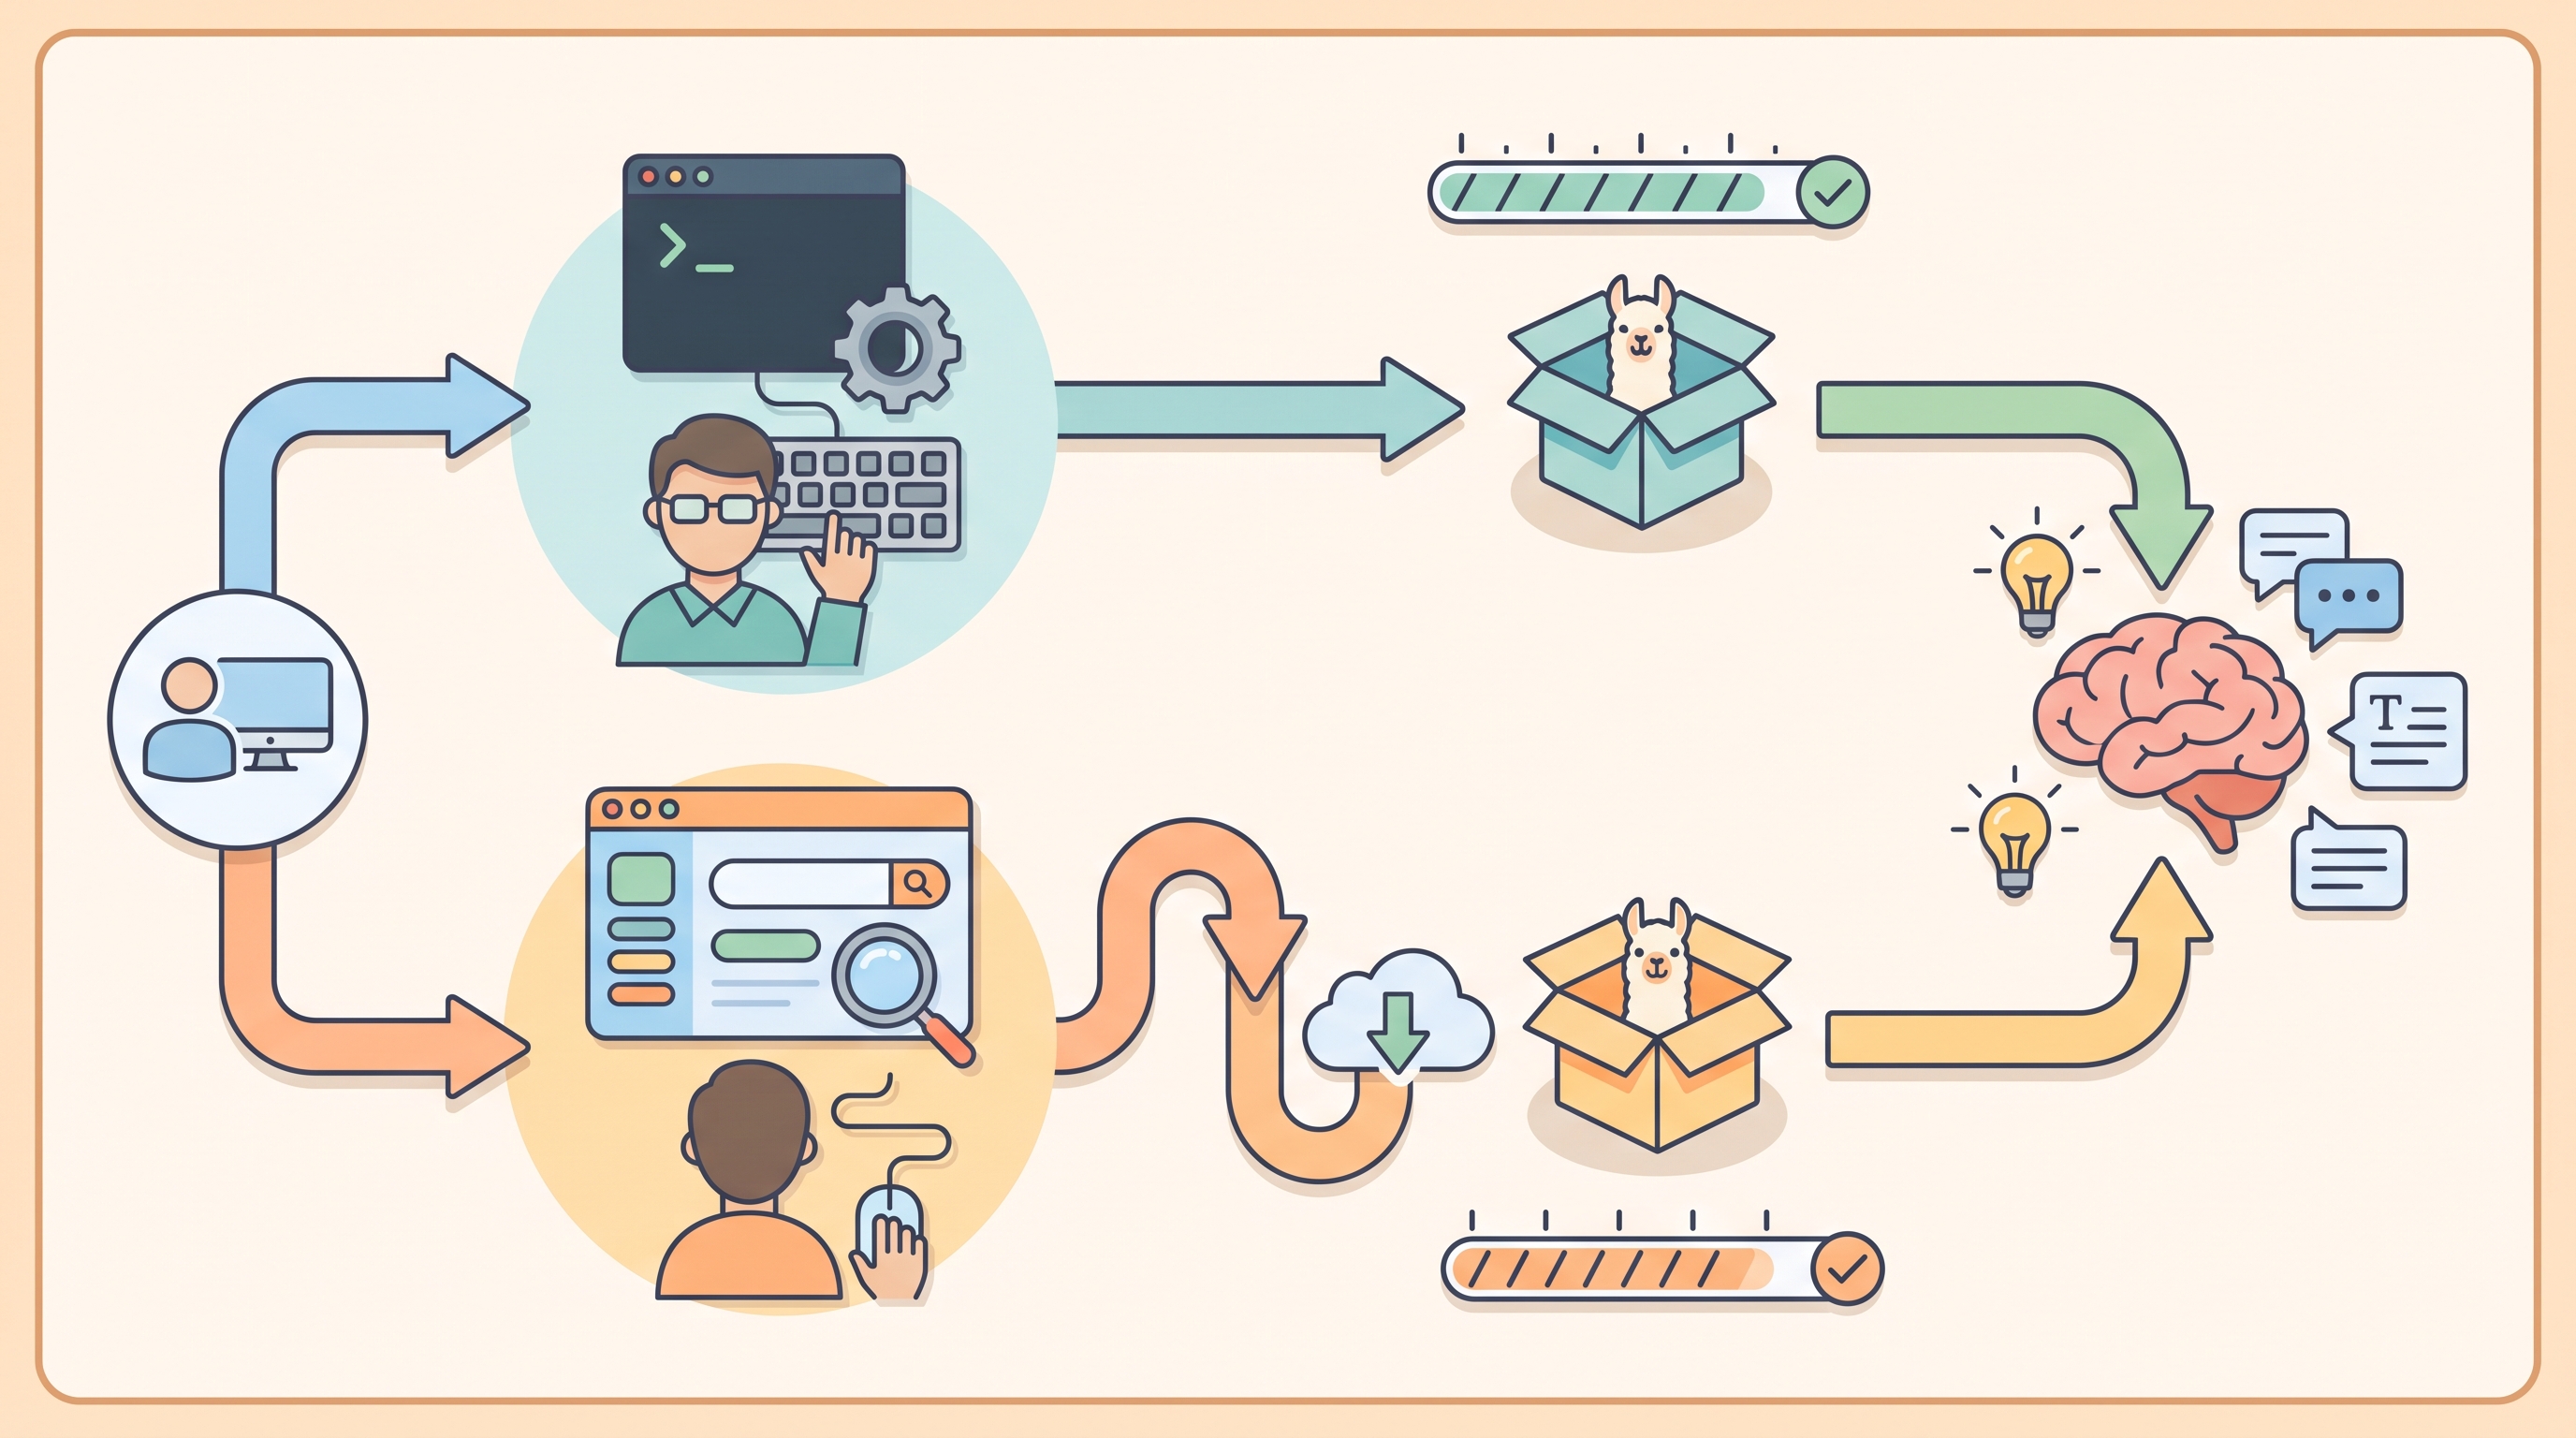
ローカル環境の準備が整えば、次はLLMを実行するためのツールを選びます。ツールの選択は、手軽さと機能性のバランスで決めるのがおすすめです。数あるローカルLLM実行ツールの中でも、特に代表的なのが「Ollama」と「LM Studio」です。
Ollamaは、コマンドライン操作(CUI)を基本とする、シンプルで動作が軽いツールです。ターミナルからコマンド1つでモデルのダウンロードと実行が完了するため、エンジニアや開発者にとって馴染みやすく、素早く試せます。対応モデルや詳細な使い方は、Ollamaの公式GitHubで確認できます。
一方でLM Studioは、グラフィカルな画面(GUI)で直感的に操作できる点が特徴です。アプリ内でHugging Face上のモデルを検索し、ダウンロードからチャット実行までを完結させられます。パラメータ調整やリソース使用率の確認も画面上で行えるため、初心者でも安心です。オフラインでの利用方法などはLM Studioの公式ドキュメントに詳しく解説されています。
そのため、コマンド操作に慣れていて手軽さを重視するならOllama、まずはチャット画面で色々試したい初心者の方にはLM Studioが向いています。どちらのツールもMeta社のLlamaシリーズなど、多くのオープンソースモデルに対応しています。まずは両方を試し、ご自身の使いやすい方を選ぶと良いでしょう。
初心者でも簡単!ローカルLLMの導入方法3ステップ

専門的な知識が必要なイメージのあるローカルLLMですが、「Ollama」などのツールを使えば、驚くほど簡単に導入できます。ここでは代表的なツール「Ollama」を例に、最短3ステップで対話を開始するまでの手順を具体的に解説します。
- ステップ1: ツールのインストール
まず、Ollama公式サイトからお使いのOS(Windows, macOS, Linux)に合ったインストーラーをダウンロードし、実行します。特に難しい設定はなく、画面の指示に従うだけでインストールは完了します。(出典: Ollama公式サイト) - ステップ2: モデルのダウンロードと実行
次に、コマンドプロンプトやターミナルを開き、簡単なコマンドを1つ入力するだけで、モデルのダウンロードと実行が自動的に行われます。例えば、Meta社が提供する軽量なモデル「Llama 3.1 8B」を動かす場合は、以下のコマンドを実行します。ollama run llama3.1:8b
このコマンド一つで、モデルの取得から対話環境の準備までが完了します。利用できるモデルの一覧は、Ollamaの公式ライブラリで確認できます。(出典: Ollama Model Library) - ステップ3: 対話の開始
コマンドを実行すると、ターミナル上にプロンプトが表示され、すぐに対話を開始できます。質問や指示を入力して、ローカルLLMの応答を確かめてみましょう。対話を終了したい場合は、「/bye」と入力します。
このように、基本的な導入は数分で完了します。ただし、これを業務で本格的に利用する際には、セキュリティ設定の監査、利用ルールの策定、そして各モデルのライセンス確認といったガバナンス体制の構築が不可欠です。
ステップ1:実行ツールの選定(Ollama, LM Studioなど)
まず、ローカルLLMを簡単に管理・実行するためのツールを選びます。代表的なツールは以下の2つです。
- Ollama: コマンドラインでの操作が基本。シンプルで動作が軽く、サーバーとして利用するのにも適しています。(出典:Ollama GitHub)
- LM Studio: グラフィカルな画面で直感的に操作できます。モデルの検索やダウンロード、チャットの実行がすべて画面上で行えるため、初心者でも迷わず使えます。(出典:LM Studio Documentation)
今回は、シンプルで応用範囲の広いOllamaを例に進めます。公式サイトからお使いのOSに合ったインストーラーをダウンロードし、画面の指示に従ってインストールを完了させてください。
ステップ2:モデルのダウンロードと設定
Ollamaのインストールが完了したら、ターミナル(WindowsではコマンドプロンプトやPowerShell)を開き、利用したいモデルをダウンロードします。Ollamaは、コマンド一つでモデルのダウンロードと対話の開始を自動で実行します。
例えば、Ollama公式サイトで公開されているMeta社のLlama 3.1(8Bモデル)を動かす場合は、以下のコマンドを一行入力して実行するだけです。
ollama run llama3.1:8b
このコマンドを実行すると、Ollamaが自動的にモデルのダウンロードを開始します。そのため、初回実行時にはインターネット接続が必要となる点にご注意ください。モデルのファイルサイズによっては数分から数十分かかる場合があります。
ダウンロードが完了すると、自動的に対話モードに切り替わり、すぐにチャットを開始できる状態になります。
ステップ3:対話インターフェースでの実行と動作確認
ダウンロードが完了し、プロンプト(>>>)が表示されたら、もうローカルLLMと対話できる状態です。ChatGPTと同じように、自由に質問や指示を入力してみてください。PCのスペックにもよりますが、数秒ほどでAIからの応答が生成されます。
対話を終了したい場合は、「/bye」と入力するか、Ctrl+Dキーを押します。一度ダウンロードしたモデルはPC内に保存されるため、次回以降は同じコマンドを実行すれば、すぐにチャットを開始できます。

ローカルLLM環境のセキュリティ対策と注意点
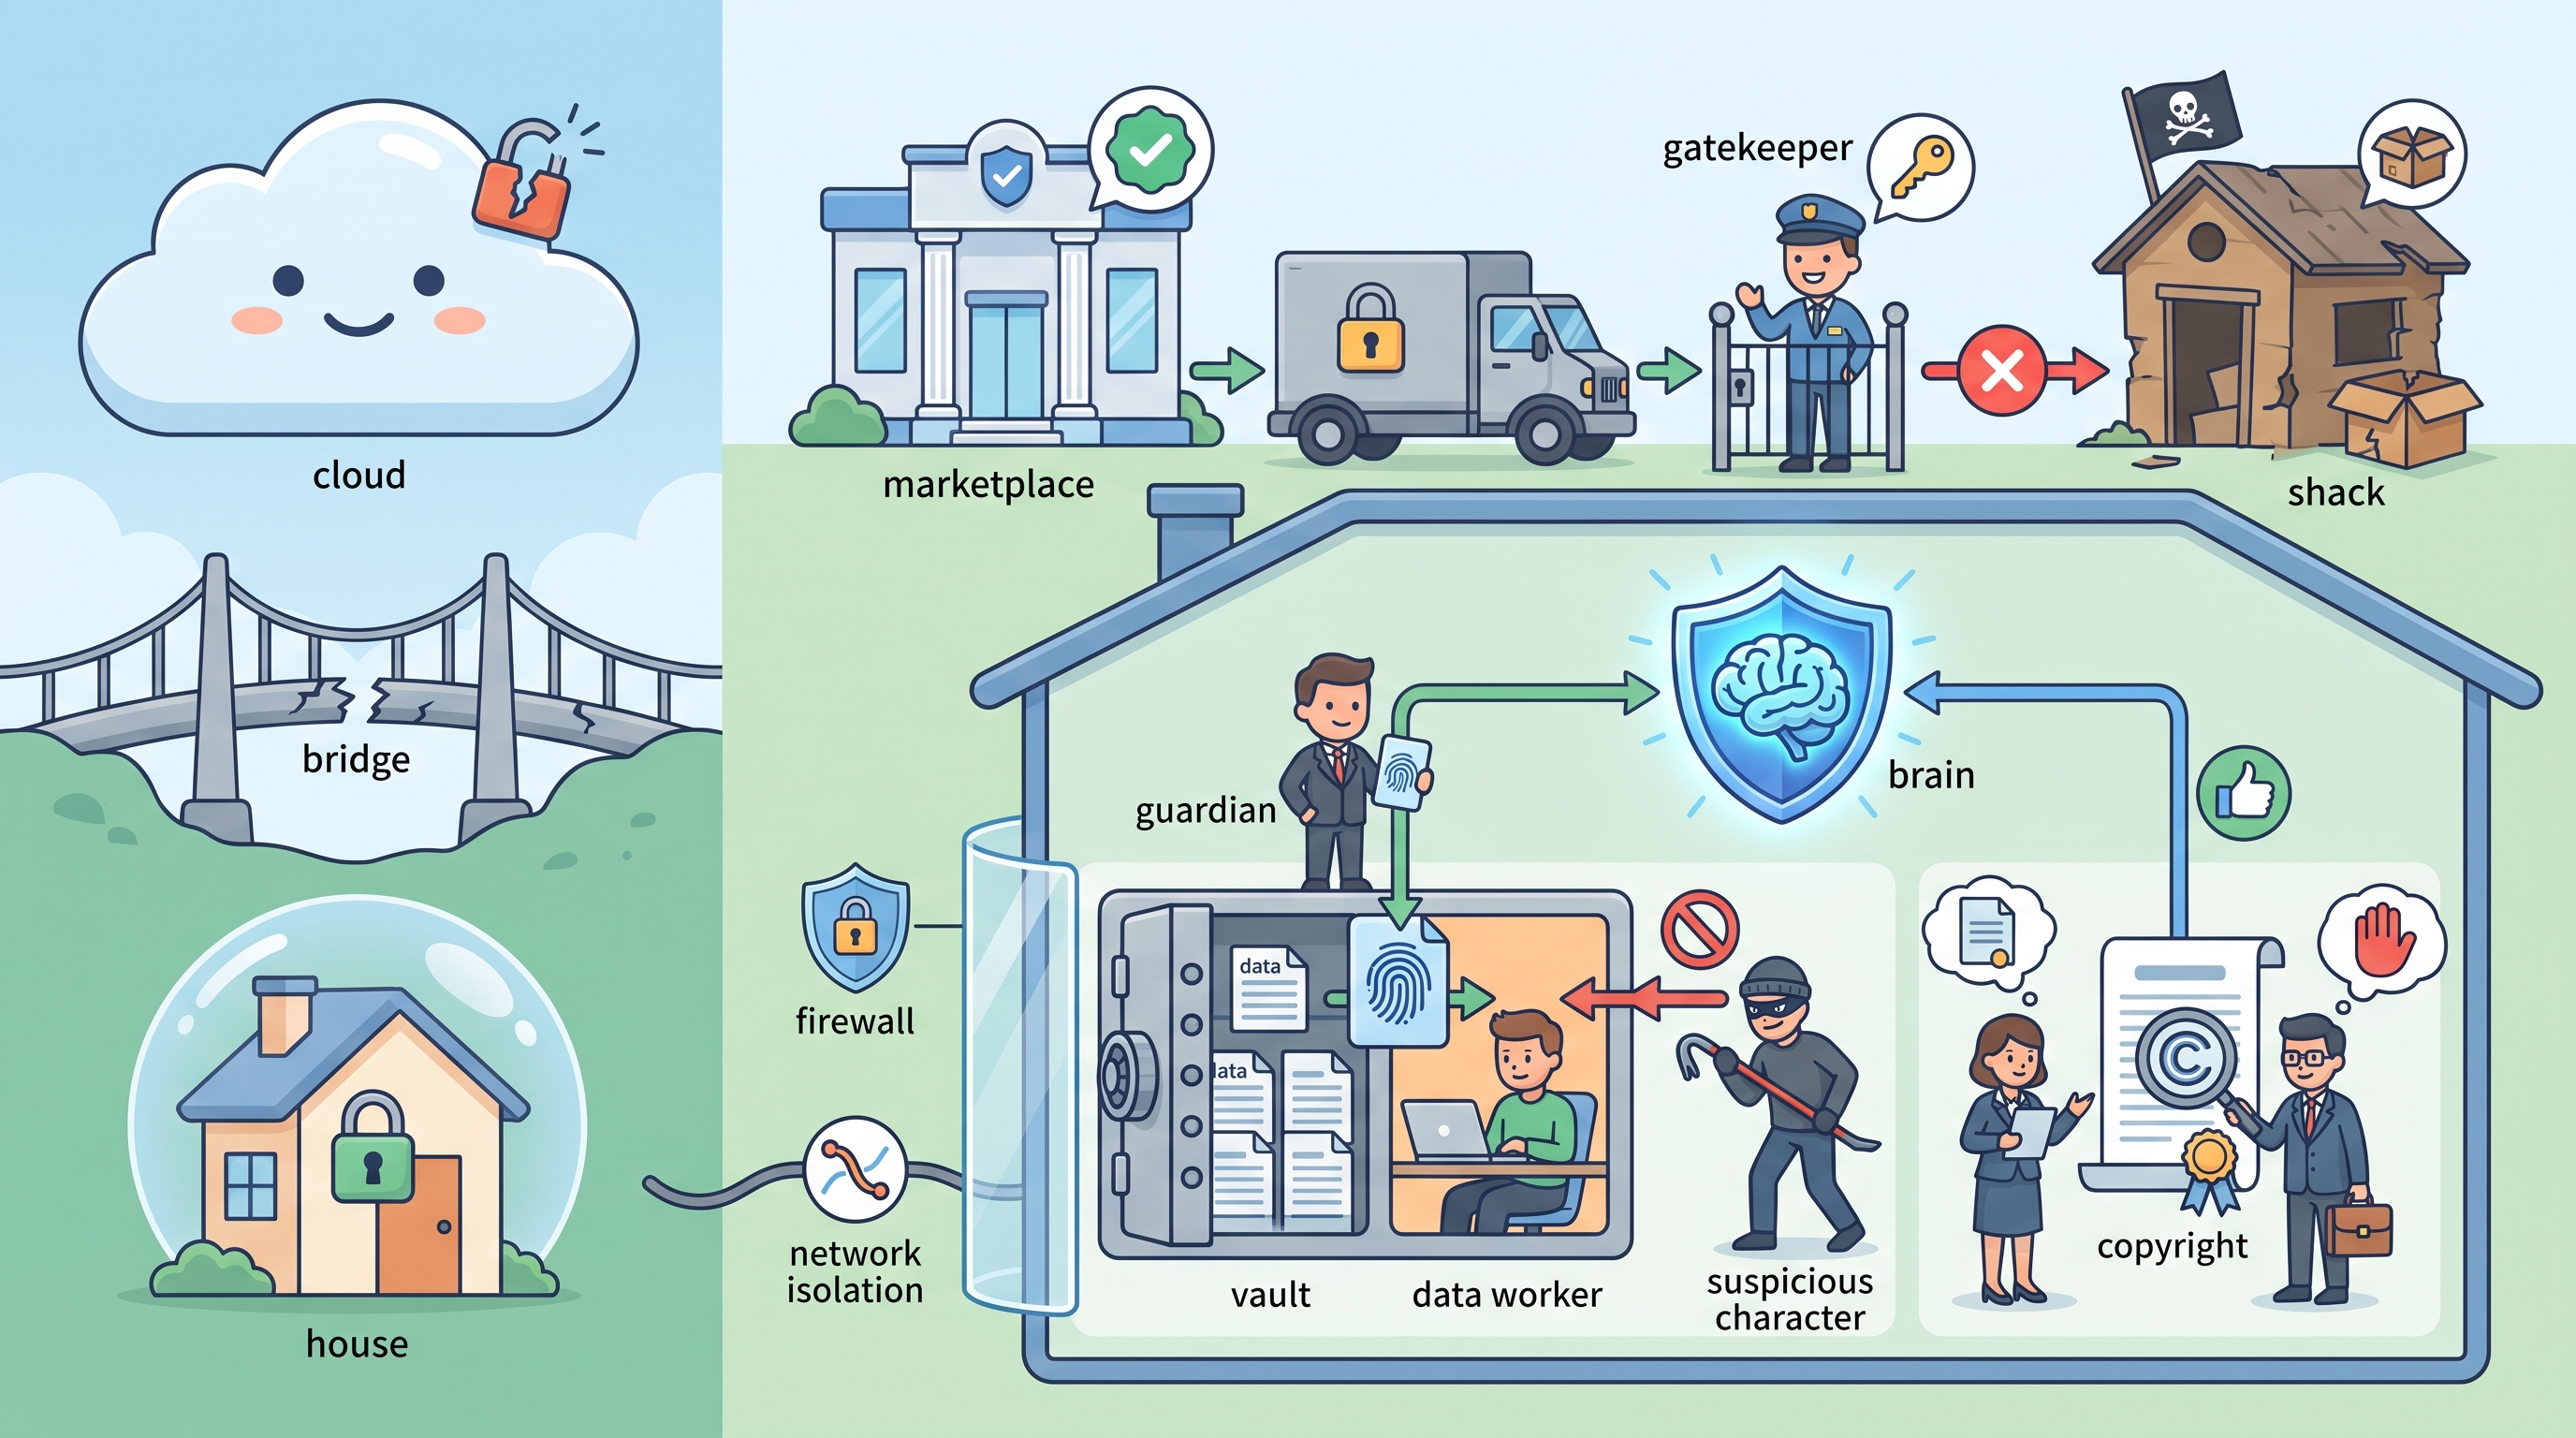
ローカルLLMは、クラウドサービスに比べて情報漏洩リスクを管理しやすい利点があります。しかし、「ローカルだから安全」と考えるのは早計で、独自のセキュリティ対策が不可欠です。特に業務で利用する際は、モデルの入手元やデータの取り扱いに関する注意点を押さえる必要があります。
まず、学習済みモデルの入手元には細心の注意を払いましょう。インターネット上で配布されているモデルの中には、悪意のあるコードが含まれていたり、脆弱性が存在したりする可能性も否定できません。 モデルは必ず公式サイトや信頼性の高いリポジトリからダウンロードしてください。
また、ローカル環境でもデータ漏洩のリスクは存在します。 例えば、ネットワーク設定の不備や、内部関係者による不正な操作が考えられます。機密情報を扱う場合は、アクセス権限を厳格に管理し、必要であればネットワークから分離した環境で利用することが重要です。
加えて、見落としがちなのがモデルのライセンスです。オープンソースとして公開されているモデルでも、商用利用が制限されていたり、特定の条件下での利用が義務付けられていたりするケースは少なくありません。 利用を開始する前に必ずライセンス規約を確認し、意図しない違反を防ぎましょう。
LLMのビジネス活用を本格的に学ぶならAX CAMP
ローカルLLMの導入方法は理解できたものの、「自社のどの業務に、どのモデルを適用すれば成果が出るのか」「独自のデータをどうやって学習させれば、本当に使えるAIになるのか」といった、より実践的な課題に直面している方も多いのではないでしょうか。
ツールの使い方を学ぶだけでは、ビジネスの成果には直結しません。重要なのは、AIの特性を深く理解し、自社の課題解決に結びつける「企画力」と「実装力」です。
私たちAX CAMPが提供する法人向けAI研修では、単なる知識のインプットに留まらず、貴社の実際の業務課題をテーマにした実践的なワークショップを通じて、AI活用のプロフェッショナル人材を育成します。
経験豊富なコンサルタントが、モデルの選定から業務への組み込み、費用対効果の算出まで、プロジェクトの立ち上げから実行までを徹底的に伴走サポート。「AIを導入したけれど、使いこなせていない」というよくある失敗を回避し、確実な成果創出へと導きます。
セキュリティポリシーが厳しい企業様向けに、ローカル環境でのAI活用に特化した研修プログラムのご提供も可能です。AI導入の第一歩でつまずかないために、まずは無料相談会で貴社の課題をお聞かせください。

法人向けAI研修
AX CAMP 無料資料
ローカルLLMの導入と活用に関するよくある質問(FAQ)
1. 初心者でも簡単にローカルLLMを始める方法はありますか?
はい、「Ollama」や「LM Studio」といった無料ツールを使えば、専門知識がなくても数ステップで始められます。 例えばOllamaの場合、①公式サイトからアプリをダウンロードしてインストールし、②ターミナル(コマンドプロンプト)で「ollama run llama3」のようなコマンドを1行入力するだけです。これだけで、ご自身のPC上で対話AIが動き出します。
2. ローカルLLMとクラウドLLM(ChatGPTなど)の主な違いは何ですか?
主な違いは3点です。①セキュリティ:ローカルLLMはPC内で処理が完結するため、機密情報を外部に送信する必要がなく情報漏洩リスクを大幅に低減できます。 ②コスト:ハードウェアへの初期投資は必要ですが、API利用料のような従量課金が発生しません。 ③カスタマイズ性:自社データでモデルを追加学習させるなど、特定の業務に特化させやすい利点があります。
3. 日本語の処理が得意な、おすすめのローカルLLMモデルを教えてください。
日本語性能が高いモデルとして、ELYZA社が開発した「Llama-3-ELYZA-JP-8B」や、rinna株式会社のモデル、Stability AI Japanの「Japanese StableLM 2」などが挙げられます。 これらは日本の文化や文脈への理解度が高く、自然な日本語の文章生成や対話が可能です。 目的やPCのスペックに合わせて、これらのモデルから選ぶのがおすすめです。
4. ローカルでLLMを実行する際のセキュリティリスクと対策はどうすれば良いですか?
ローカル環境でもセキュリティ対策は重要です。主なリスクとして、①悪意のあるコードが埋め込まれたモデルのダウンロード、②ツールの脆弱性を突いた攻撃、が挙げられます。 対策として、①モデルはHugging Faceなどの公式サイトや信頼できる提供元から入手する、②Ollamaなどの実行ツールは常に最新バージョンにアップデートする、といった基本的な対策を徹底することが重要です。
まとめ:LLMのローカル導入で、安全かつ効率的なAI活用を実現しよう
本記事では、ローカルLLMの基本からメリット・デメリット、おすすめのモデル、そして具体的な導入手順までを網羅的に解説しました。最後に、重要なポイントを振り返ります。
- ローカルLLMの核心:適切に構成・運用すれば、データを外部に出すリスクを大幅に低減できる。
- 主なメリット:データ保護、オフライン利用、高度なカスタマイズ性。
- 主なデメリット:高性能PCへの初期投資と、運用に関する専門知識が必要。
- 導入方法:Ollama等のツールを使えば、初心者でも3ステップで簡単に導入可能。
- 成功の鍵:自社の目的(セキュリティ重視か、性能重視か、日本語能力か)に合ったモデルを選ぶこと。
ローカルLLMは、クラウド型AIのセキュリティ懸念を払拭し、企業のデータ資産を最大限に活用するための強力な選択肢です。導入にはハードルもありますが、それを乗り越えることで、他社には真似できない独自の競争力を生み出すことができます。
AX CAMPでは、この記事で紹介したようなローカルLLMの導入はもちろん、貴社の状況に合わせた最適なAI活用戦略の立案から人材育成までをワンストップで支援します。「何から手をつければ良いかわからない」「自社だけで進めるのは不安だ」と感じている方は、ぜひ一度、私たちの無料相談会をご活用ください。専門家が貴社のAI活用を成功へと導きます。
法人向けAI研修
AX CAMP 無料資料
