「どのAIモデルが自社の業務に最適なのか判断できない」
「各社の性能アピールは本当?客観的な比較データが欲しい」——。AI導入を検討する多くの企業担当者が、このような悩みを抱えています。AIモデルの選択は、導入効果を左右する重要な意思決定ですが、その性能を測る客観的な指標がなければ、適切な判断は困難です。
AIベンチマークは、決められた課題と測定方法でAIの能力を調べ、モデル選定の参考にする「ものさし」です。
この記事では、主要な評価指標、2026年10月11日に確認したモデルの位置づけ、公式スコアを読む際の条件を解説します。公開スコアだけで業務への適合を保証することはできないため、費用・日本語対応・自社の評価課題も合わせて検討しましょう。
AIの選定から実務活用まで、より具体的な進め方を知りたい方のために、AI研修のプロがまとめた
「AI導入成功のポイント」もご用意しています。ぜひ、貴社のAI戦略策定にお役立てください。
法人向けAI研修
AX CAMP 無料資料
AIベンチマークとは?性能評価の重要性をわかりやすく解説
AIベンチマークとは、決められたデータセットや課題、測定方法を使ってAIの能力を評価する仕組みです。知識問題の正答率、生成コードのテスト通過率など、測る対象によって指標が異なります。すべてのAIに共通する単一の総合評価ではなく、目的に合う課題と同じ評価条件を選んで比較する必要があります。
開発元の性能説明を検討する際、公開ベンチマークは確認材料になります。ただし、モデルのバージョン、実行条件、対象データ、測定時期が不明な数値だけでは、性能の優劣を判断できません。
AIの性能を客観的に測る「ものさし」
AIモデルの性能は、文章の生成能力、知識の豊富さ、論理的な推論能力、プログラミング能力など、多岐にわたります。AIベンチマークは、これらの多様な能力を測定するために、様々な種類のテスト問題で構成されています。例えば、大学レベルの広範な知識を問う問題群や、複雑な数学の文章問題を解かせるテストなどがあります。
同じベンチマーク名でも、問題の版や対象範囲、プロンプト、試行回数、利用ツールが異なればスコアは変わります。同じ条件で測った結果を比較し、異なる条件の数値をひとつの順位にまとめないことが大切です。
ビジネスにおけるベンチマークの重要性
モデル選定は、費用や業務品質に影響します。顧客対応に使う場合は、日本語の回答品質だけでなく、誤案内の頻度、応答時間、人による確認の負担も評価しましょう。言語ベンチマークは候補を絞る材料であり、投資対効果(ROI)を直接測る指標ではありません。
PoC(概念実証)の前に用途に近い公開評価で候補を絞ると、検証対象を整理できます。ただし、自社の課題に適した候補を除外しないよう、スコア以外の条件と小規模な実務テストを組み合わせましょう。
主要AIベンチマークの種類と評価指標
ここでは、知識・常識、コーディング・数学、日本語という3つの観点で代表的な評価を整理します。この分類は説明のためのもので、ベンチマーク全体を網羅する分類ではありません。画像を伴う理解やエージェントの操作、安全性などを測る評価もあります。
以下では、各ベンチマークが何を測るかを解説します。歴史のある指標も含むため、「新しいモデルほど必ずこの指標で測られている」とは考えず、公式発表の評価項目を確認しましょう。
総合的な能力を測るベンチマーク(MMLU, HellaSwagなど)
MMLU(Massive Multitask Language Understanding)は、初等的な内容から専門的な内容まで57科目の知識を問う評価です。大学院レベルの専門知識を問うGPQAや、日常的な状況の続きを選ぶHellaSwagなどもあります。それぞれ測定する課題が異なり、「地頭」のような単一の能力に置き換えないことが大切です。(出典:MMLU公式リポジトリ)(出典:GPQA原論文)
- MMLU:57科目の四択問題で知識を評価します。すべてが大学レベルではなく、初等的な問題から専門分野までを含みます。
- HellaSwag:日常的な状況を述べた文脈に続く、もっとも適切な選択肢を選ぶ常識推論の評価です。(出典:HellaSwag公式サイト)
知識・常識のスコアは、その課題への対応力を判断する材料です。広範な業務で安定して使えるかどうかは、個別の業務テストで確認する必要があります。
特定分野の専門性を測るベンチマーク(HumanEval, GSM8Kなど)
特定の業務での活用を想定している場合、その分野に特化したベンチマークが重要になります。特にプログラミングや数学的能力は、多くのビジネスシーンで求められるため、専用のベンチマークが存在します。例えば、コーディング能力を評価する「HumanEval」や、より実務に近いソフトウェア開発能力を測る「SWE-bench」、数学の文章問題を解く能力を測る「GSM8K」などが代表的です。
- HumanEval:Python関数を生成し、テストによる機能的な正しさを評価します。pass@1などの指標と、生成した候補数を合わせて読みましょう。(出典:HumanEval公式リポジトリ)
- GSM8K:基礎的な四則演算などを組み合わせる算数の文章問題です。複数段階の計算を含みますが、実務の統計解析や高度な数学全般を測るものではありません。(出典:GSM8K公式リポジトリ)
- SWE-bench:実際のソフトウェアリポジトリの問題を修正し、テストで評価する課題です。Verifiedなどの対象セットと、モデルに組み合わせたエージェント・ツールの構成を確認してください。(出典:SWE-bench公式サイト)
これらのスコアは、開発業務の補助やデータ分析などでAI活用を目指す企業にとって特に重要です。自社のユースケースに直結する指標を重点的に確認しましょう。
日本語能力に特化したベンチマーク(JGLUE, Rakudaなど)
英語の評価結果だけでは、日本語での回答品質や業務用語への対応を判断できません。日本語の公開評価に加え、自社で使う文章、問い合わせ、出力形式を使ったテストを検討しましょう。
- JGLUE:Yahoo! JAPANと早稲田大学の共同研究で構築された、日本語の言語理解を評価するベンチマークです。文章分類、意味的類似度、自然言語推論などを扱い、自由な対話能力をひとつの数値で測るものではありません。(出典:JGLUE公式リポジトリ)
- Rakuda:歴史・社会・地理など日本に関する40問の質問データセットが公開されています。問題数が限られるため、これだけで日本語能力全般を判断せず、評価に用いた採点方法も確認しましょう。(出典:作成者公開のRakuda質問データ)
日本語の公開スコアがないモデルもあります。数値の有無だけで除外せず、実務に近い日本語の評価課題で回答の正確さや読みやすさを比較してください。
法人向けAI研修
AX CAMP 無料資料
主要AIモデルの現行候補と公式スコアの読み方【2026年10月確認】
2026年10月11日に、提供元のモデル一覧、リリース情報、廃止情報を確認しました。下表は現行候補と過去の公開モデルの位置づけを整理したもので、順位表ではありません。評価条件を確認できないMMLU・SWE-benchの数値は掲載せず、公式発表にあるスコア例を表の後で紹介します。
最新版のAPIモデルと、以前の世代の公開重みモデルは提供形態も用途も異なります。旧版が利用可能であることと、現在の推奨候補であることは分けて考えましょう。モデル名の変更だけで互換性や同じ出力品質が保証されるわけではありません。
| AIモデル | 開発元 | 確認時点の位置づけ | 選定・比較の観点 | 公式情報 |
|---|---|---|---|---|
| GPT-6.1 Sol | OpenAI | 現行の候補(2026年9月公開) | 複雑なコーディング・専門業務向け。難度や費用に応じて別のモデルも評価する。 | (出典:OpenAIモデル一覧)(出典:リリース情報) |
| Claude Opus 5.5 | Anthropic | 現行の候補(Active) | 公式は多くの用途の開始候補として案内。難しい推論などではClaude Fable 5.1も比較対象。 | (出典:Claudeモデル一覧)(出典:モデルの廃止情報) |
| Gemini 3.8 Flash | 現行の安定版(GA) | Googleの現行Flash候補。Pro系プレビューの同等な置換とは限らず、実務課題で比較する。 | (出典:Geminiモデル一覧)(出典:リリース情報) | |
| Qwen2.5-72B-Instruct(過去の公開モデル) | Alibaba Cloud | 2024年公開の旧世代。公開重みを確認 | APIの現行モデルとは別に、ライセンス・実行環境・推論費用を確認する。 | (出典:Qwen公式モデルカード)(出典:2024年の公開情報) |
GPT-5.4とClaude Opus 4.7は、確認時点で利用可能な旧世代であり、ここでは最新候補として扱いません。Gemini 3.1 Proはプレビューとして掲載されているため、安定版と区別します。旧モデルから移行する場合は、APIの設定、対応機能、料金、出力品質の差を確認し、自社の評価課題を再実行してください。(出典:OpenAI廃止情報)(出典:Gemini提供・廃止情報)
公式スコアを比較する際の条件
数値例として、Anthropicの2026年9月22日の発表は、Terminal-Bench 4.0でClaude Opus 5.5が66.4%、Claude Fable 5.1が55.8%と報告しています。ただし、Opus 5.5はxhigh、Fable 5.1は原則maxの推論設定で、すべての条件が同一とは限りません。これは同社の報告にある特定の課題の結果であり、あらゆるコーディング業務の順位や成功率ではありません。(出典:Claude Opus 5.5公式発表・評価条件)
比較時には、①モデルの正確なIDと版、②課題の版と対象セット、③推論設定・プロンプト・試行回数、④ツールやエージェントの構成、⑤採点方法と測定時期を確認してください。MMLUとMMLU-Pro、SWE-benchとSWE-bench Verified、pass@1とpass@10のように異なる指標を、同じ列の数値として並べないことが大切です。
ベンチマークスコアの限界と見るべき3つの注意点
高いベンチマークスコアはAIモデルの性能を示す重要な指標ですが、その数値が必ずしも実業務での成功を保証するわけではありません。スコアを鵜呑みにすると、導入後に「思ったような成果が出ない」という事態に陥りかねません。スコアの裏に潜む限界やリスクを理解し、多角的な視点でモデルを評価することが重要です。ここでは、特に注意すべき3つのポイントを解説します。
注意点1:スコア汚染(Contamination)と過学習のリスク
データ汚染(Data Contamination)は、評価用の問題やその関連データが学習データに含まれ、スコアの解釈に影響する問題です。含まれ方やモデルによって影響は異なり、必ず高得点になるとは限りません。公開問題への適合と、未経験の課題を解く能力を区別して検討します。
LiveBenchは、新しい問題を定期的に追加し、学習データと評価データの重なりを抑える設計を採用しています。ただし、更新しているというだけで、すべてのモデルの汚染を完全に排除できるとは断定できません。使用した問題セットの公開時期を確認してください。(出典:LiveBench公式リポジトリ)
注意点2:実業務の複雑なタスクを反映できているか
ベンチマークは、特定の能力を切り出して測定する標準化されたテストです。しかし、実際のビジネス現場で発生するタスクは、複数の能力を組み合わせ、文脈を読み取りながら進める必要がある複雑なものがほとんどです。例えば、「競合他社の最新動向を調査し、自社のマーケティング戦略を立案する」といった業務は、単純な知識問題やコーディングテストだけでは評価できません。
ベンチマークスコアはAIの「基礎体力」を示すものと捉え、実際の業務に近いタスク(カスタムベンチマーク)でテストを行うことが理想的です。例えば、自社の過去の問い合わせメールに対応させたり、業界特有の専門用語を含むレポートを作成させたりすることで、より実践的な性能を見極めることができます。
注意点3:特定の文化や言語へのバイアス
MMLUやGSM8Kなどの英語の評価で高いスコアが出ても、日本語で同じ品質になるとは限りません。翻訳、文化的な文脈、専門用語、敬語など、実際に必要な能力を日本語で確かめましょう。
JGLUEやRakudaは日本語を検討する材料ですが、用途や採点方法が異なります。顧客対応に使うなら誤案内や個人情報の扱いも含め、実務に近いデータで確認してください。
法人向けAI研修
AX CAMP 無料資料
【目的別】最適なAIモデルの選び方|スコア以外の判断基準
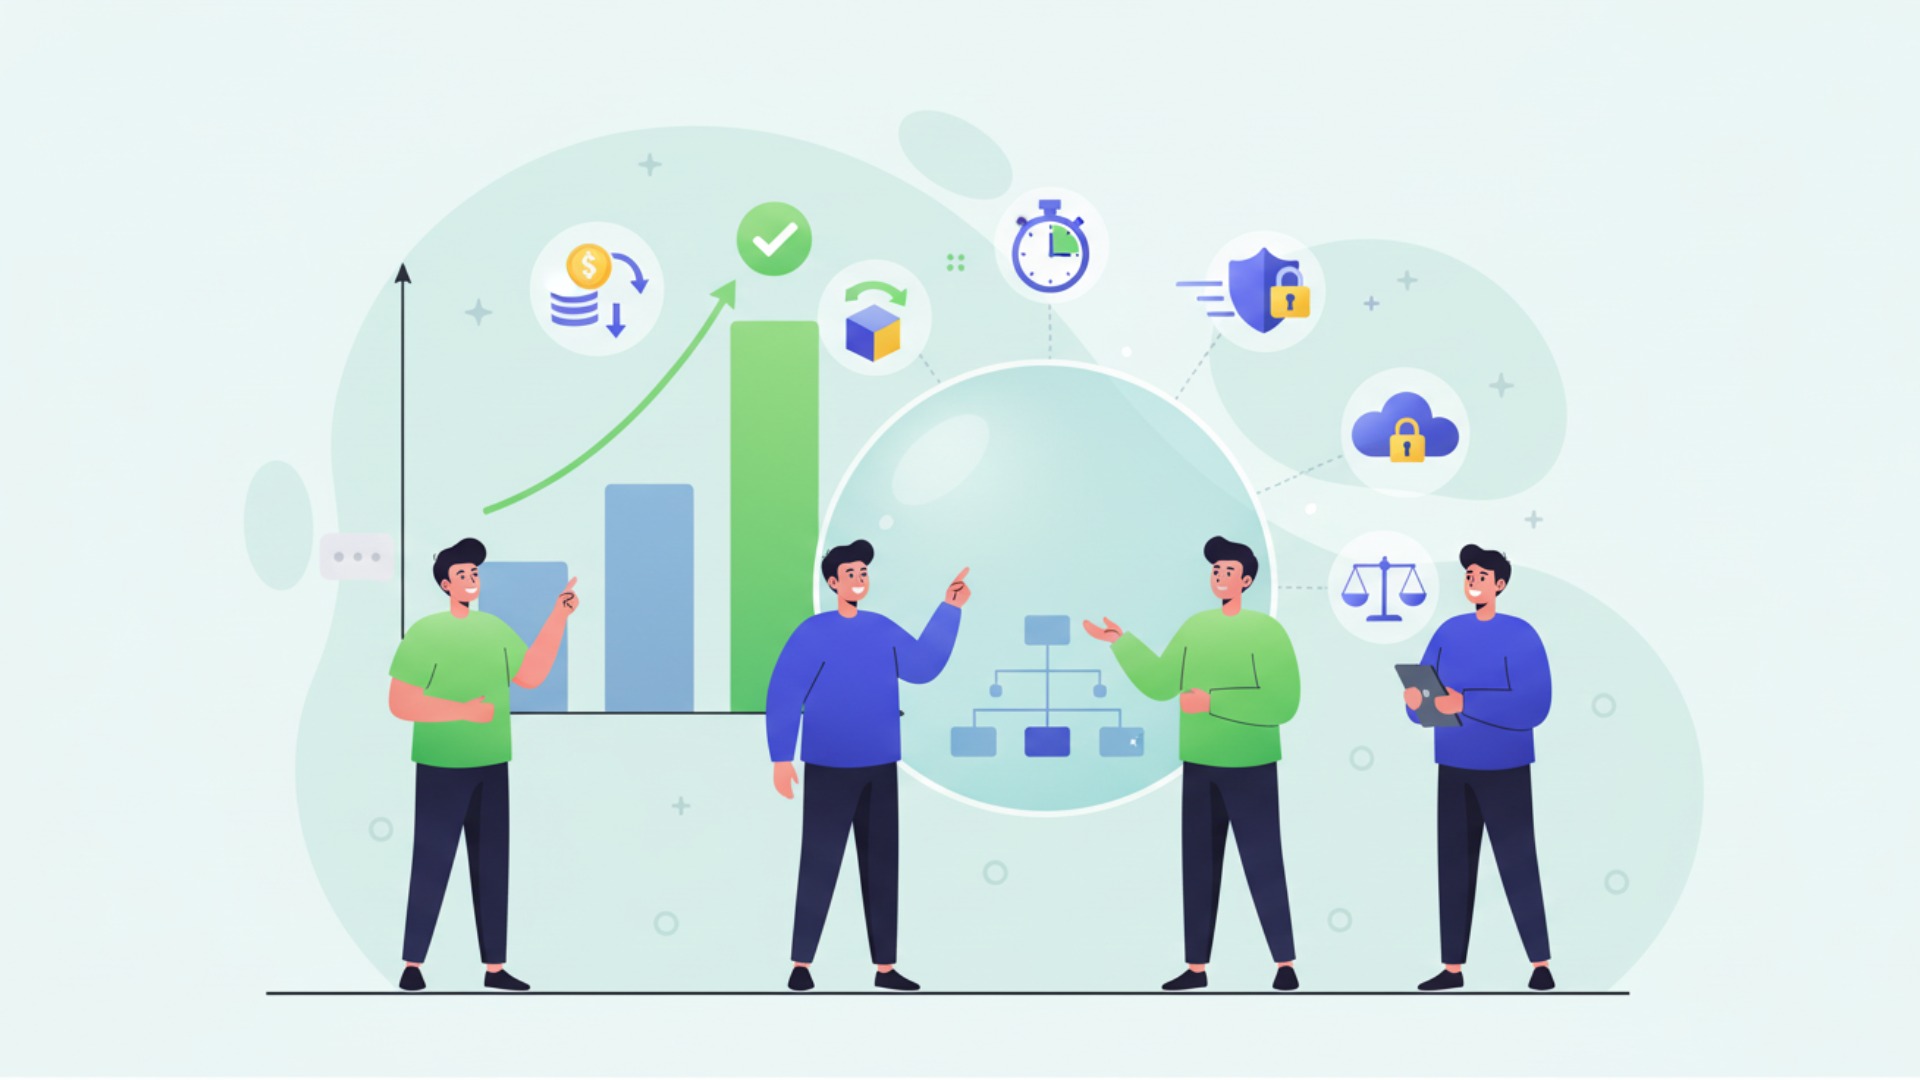
ベンチマークスコアはAIモデル選定における重要な判断材料の一つですが、それだけで選ぶのは危険です。実務で成果を出すためには、目的や用途に応じて多角的な視点から評価する必要があります。コスト、速度、セキュリティといったスコアには表れない要素が、導入後の運用効率や費用対効果を大きく左右するためです。ここでは、目的別に考慮すべきスコア以外の判断基準を解説します。
自社の状況と照らし合わせながら、どの基準を優先すべきか検討してみてください。
- API利用料金: 処理するデータ量が多い場合、単価の差が大きなコスト差になります。
- 処理速度(レイテンシ): リアルタイムでの応答が求められるチャットボットなどでは非常に重要です。
- セキュリティ要件:送信先、保存期間、学習利用、アクセス制御、第三者連携、必要なネットワーク制限を契約と設定で確認します。閉域網だけで安全性が保証されるわけではありません。
- カスタマイズ性: 自社データでファインチューニングできるかなど、特定の業務への適合度を高められるかを確認します。
- APIのドキュメント: 開発者がスムーズにシステム連携できるよう、ドキュメントの分かりやすさも重要です。
少数の候補でPoCを行い、回答品質、応答時間、総費用、人による確認負担を比較しましょう。実務データを外部サービスへ渡す場合は会社の承認・契約条件を先に確認し、必要に応じて匿名化したデータや合成データを使います。
AIの性能を測定できる主要ベンチマークツール
公開されている主要なAIモデルのベンチマークスコアを参考にするだけでなく、自社の特定のユースケースに合わせて独自に性能を評価したいと考える開発者や企業も少なくありません。幸いなことに、AIモデルの性能を測定し、比較するためのオープンソースツールやプラットフォームがいくつか存在します。これらのツールを活用することで、より客観的かつ自社の状況に即したモデル評価が可能です。
ここでは、AIの性能測定に利用できる代表的なツールをいくつか紹介します。
- Arena(旧Chatbot Arena):2つの匿名モデルの回答を比較して投票し、人の好みに基づく評価を集めます。好みの順位と事実の正確さは同じ指標ではありません。(出典:Arena公式の評価方法)
- LM Evaluation Harness:EleutherAIの公開フレームワークで、多数の課題を共通の仕組みで実行できます。設定や問題の版を合わせることが比較の前提です。(出典:公式リポジトリ)
- LiveBench:研究者らが公開する評価プロジェクトです。新しい問題を定期的に追加し、正解を照合できる課題を使います。(出典:公式リポジトリ)
Hugging FaceのOpen LLM Leaderboardには公開モデルの比較結果があります。過去の評価結果も含むため、最新モデルの順位を保証する資料として扱わず、対象モデル、結果の取得日、評価データと採点方法を確認してください。現在のAPIモデルの検討には、提供元の新しい評価報告や自社のテストも必要です。(出典:Open LLM Leaderboard)
法人向けAI研修
AX CAMP 無料資料
AIベンチマークの今後の動向と新たな評価軸
AI技術が進化し続ける中で、その性能を測るベンチマークもまた、常に進化を求められています。従来の知識や推論能力を問う静的なテストだけでは、現代のAIが持つ多様な能力を正確に評価することが難しくなってきているためです。今後は、より実用的で、現実世界の複雑な課題に対応できる能力を測る新しい評価軸が重要視されていきます。
ここでは、AIベンチマークが今後どのような方向に進化していくのか、注目すべき3つの動向を紹介します。
マルチモーダル性能の統合的評価
画像と文章を一緒に扱うなど、複数の入力形式に対応したモデルがあります。ただし、音声・動画の入力や生成への対応はモデルとAPIで異なり、「マルチモーダル」とあるだけで、すべての形式を扱えるとは限りません。
MMMU(A Massive Multi-discipline Multimodal Understanding and Reasoning Benchmark)は、画像と文章を含む大学レベルの課題で、専門知識と推論を評価します。音声や動画を含むマルチモーダル性能全般のスコアと混同しないようにしましょう。(出典:MMMU公式サイト)
安全性や倫理性を測るベンチマークの重要性
AIが社会に広く浸透するにつれて、その安全性や倫理性がこれまで以上に問われるようになっています。AIが差別的な発言をしたり、有害なコンテンツを生成したりするリスクは、ビジネスにとって大きな脅威です。そのため、AIの性能評価においても、単なる能力の高さだけでなく、安全性が重要な評価軸となります。
安全性の評価では、有害な指示への応答、偏り、外部ツールを使った操作など、対象リスクを明確にします。AnthropicのResponsible Scaling Policyは、能力向上に伴うリスクと対策を扱う方針であり、単一のベンチマークではありません。方針の存在だけで安全が保証されるわけではなく、個別モデルの報告と自社の利用条件を合わせて確認します。(出典:AnthropicのResponsible Scaling Policy)
人間との協調性や実用性の評価
最終的にビジネスでAIを活用する目的は、人間の業務を支援し、生産性を向上させることです。そのため、AIが単独で高い性能を発揮するだけでなく、人間とどれだけスムーズに協調し、意図を汲み取って的確なサポートを提供できるかという実用性の評価が不可欠になります。
例えば、AIが自律的にタスクを計画・実行する「AIエージェント」の能力を測るベンチマークや、複数の対話を通じて複雑な問題を解決していく能力を評価するベンチマークが登場しています。スコアの高さだけでなく、実際の業務フローの中でいかに「使える」存在であるかが、今後のAI評価の中心的なテーマとなっていくでしょう。
ビジネスにおけるAIベンチマークの戦略的活用法
公開ベンチマークはモデルの候補選定に、自社の評価課題は導入後の品質管理に使えます。ROIを検討する際は、性能スコアとは別に、削減できた作業時間、導入・運用費用、確認や修正にかかった負担を測定しましょう。
PoC(概念実証)フェーズでの客観的なモデル選定
AI導入の初期段階であるPoC(概念実証)では、どのモデルをテスト対象にするか選定する必要があります。この時、ベンチマークスコアが客観的な足切り基準として機能します。自社が解決したい課題に近いベンチマーク(例:コーディング業務ならSWE-bench)で高いスコアを出しているモデルを複数ピックアップすることで、効率的に候補を絞り込めます。
公開評価で候補を整理した後は、自社の代表的な課題で比較します。高いスコアはPoCの成功を保証しないため、採用基準と許容できない失敗を実施前に決めておきましょう。
導入後の継続的なパフォーマンスモニタリング
AIモデルは一度導入したら終わりではありません。開発元によるアップデートで性能が向上することもあれば、逆に特定のタスクで性能が低下(デグレード)することもあります。そのため、導入後も定期的にパフォーマンスをモニタリングすることが重要です。
同じ評価データで定期的に確認し、品質や費用の変化を把握します。モデルを切り替える場合は、移行費用、APIの互換性、出力形式、権限や安全性も確認し、検証後に判断してください。定期テストだけで常に最良のモデルが選べるとは限りません。
投資対効果(ROI)を検討するための業務指標
ROIを検討する際は、API料金に加えて開発、研修、運用、レビューなどの費用と、削減時間や業務成果を比較します。品質・安全性・顧客対応の要件も含め、単一のスコアや費用削減額だけで成否を決めないようにしましょう。
AXが2025年8月に公開したRoute66社のインタビューでは、従来の原稿執筆が最短3時間・最大24時間だった一方、AIによる出力は10秒だったと報告されています。画像の準備や装飾などを含む記事制作全体が10秒になったという意味ではありません。WISDOM社のインタビューでは、出演者・カメラマンの日程調整の自動化によって、採用を予定していた2名分の業務を代替できる見込みが述べられています。既存社員2名の置換や確定した人件費削減額と同一視しないようにしてください。(出典:Route66社インタビュー(2025年))(出典:WISDOM社インタビュー(2025年))
これらはAXが公開した顧客インタビューに基づく個別の事例であり、独立した実測や他社での成果を保証するものではありません。また、ベンチマークによるモデル選定が成果の原因だったことまでは確認できません。自社のROIは、導入前後の業務を同じ条件で測って検討してください。
実践的なAI活用スキルを習得するならAX CAMP
AIベンチマークを理解し、自社に最適なモデルを選定することは非常に重要です。しかし、どれだけ高性能なAIを選んでも、それを現場で使いこなすスキルがなければ宝の持ち腐れになってしまいます。AIの真価を引き出し、具体的な業務改善や生産性向上といった成果に繋げるには、モデルの選定能力だけでなく、実践的な活用ノウハウが不可欠です。
当社の法人向けAI研修「AX CAMP」は、実務を題材にAI活用を学び、業務のAI化に取り組むための研修・伴走支援を案内しています。カリキュラムや対応できる業務、支援範囲は、現在のサービス内容と個別の相談でご確認ください。(出典:AX CAMP公式サービス)
モデル選定だけでなく、評価課題の作り方、現場での活用、運用時の確認なども含めて準備しましょう。AX CAMPへの相談を希望される場合は、現行の案内からお問い合わせください。研修の受講によって一定のROIや業務成果が保証されるわけではありません。

法人向けAI研修
AX CAMP 無料資料
AIベンチマークに関するよくある質問(FAQ)
AIベンチマークとは、どのような目的で使われる指標なのですか?
AIベンチマークは、決められた課題や方法でAIの能力を測る仕組みです。用途に合う課題を選び、モデルの版や実行条件をそろえて比較します。候補選定に役立ちますが、業務への適合やROIを直接保証するものではありません。
AIの能力を測るベンチマークには、どのような種類がありますか?
知識を問うMMLU、Pythonコードを評価するHumanEval、算数の文章問題を扱うGSM8K、日本語のJGLUEやRakudaなどがあります。画像と文章のMMMU、エージェントの操作を測る評価もあり、分類はこの3つに限定されません。目的に合う課題と評価条件を確認しましょう。
ベンチマークスコアが高いAIモデルを選べば、実業務でも必ず高い性能を発揮しますか?
必ずしもそうとは限りません。ベンチマークスコアには限界があり、注意が必要です。例えば、学習データにテスト問題が含まれる「スコア汚染」で実力以上に高いスコアが出たり、標準化されたテストが実業務の複雑なタスクを反映していなかったりする場合があります。また、英語基準で設計されたベンチマークでは、日本語での性能を正確に測れない可能性も考慮すべきです。
まとめ:AIベンチマークを正しく理解し最適なモデルを選ぼう
本記事では、AIベンチマークの基礎知識から最新のモデル比較、そしてビジネスで活用するための注意点までを網羅的に解説しました。AI導入の成功は、自社の目的を明確にし、それに合った客観的な指標でモデルを評価することから始まります。
最後に、本記事の重要なポイントをまとめます。
- AIベンチマークは、AIの性能を客観的に比較するための「ものさし」である。
- MMLU(総合力)やSWE-bench(コーディング)など、目的に応じて見るべき指標は異なる。
- モデルの現行・旧世代・プレビューを区別し、スコアの出典、評価条件、確認日を読む。
- スコアだけでなく、コストやセキュリティ、日本語能力など多角的な視点でモデルを選定することが重要。
- 公開スコアによる候補選定と、実務の品質・費用・ROIの測定を分ける。
AIベンチマークは、AIという複雑なテクノロジーを理解し、ビジネスに活かすための強力な羅針盤となります。しかし、最適なモデルを選んだ後、それを全社的に展開し、成果を出し続けるには専門的なノウハウが必要です。「AI導入を成功させたいが、何から手をつければいいかわからない」「現場のスキルが追いつかず、AI活用が進まない」といった課題をお持ちでしたら、ぜひ一度AX CAMPにご相談ください。貴社の状況に合わせた最適なAI導入・活用プランをご提案します。
法人向けAI研修
AX CAMP 無料資料
