AIの導入を加速させる企業が増える一方で「AI特有のセキュリティリスク」への対策が追いついていないケースが散見されます。従来のセキュリティ対策だけでは防げない新たな脅威が次々と登場しており、何も対策をしなければ、機密情報の漏洩やシステムの不正利用といった深刻な事態を招きかねません。しかし、具体的に何が危険で、どう対策すれば良いのか分からない担当者の方も多いのではないでしょうか。
この記事では、AIシステムに潜む「脆弱性」とは何か、その種類や具体的な攻撃手口、そして企業が今すぐ取り組むべきセキュリティ対策までを網羅的に解説します。
最新のインシデント事例や国内外のガイドラインにも触れるため、自社のAI活用をセキュアに進めるための具体的なアクションプランを描けるようになります。AIの安全な利活用には、専門的な知識と継続的な情報収集が不可欠です。実践的なAIスキル習得にご興味のある方は、弊社の法人向けAI研修「AX CAMP」の資料もぜひご活用ください。
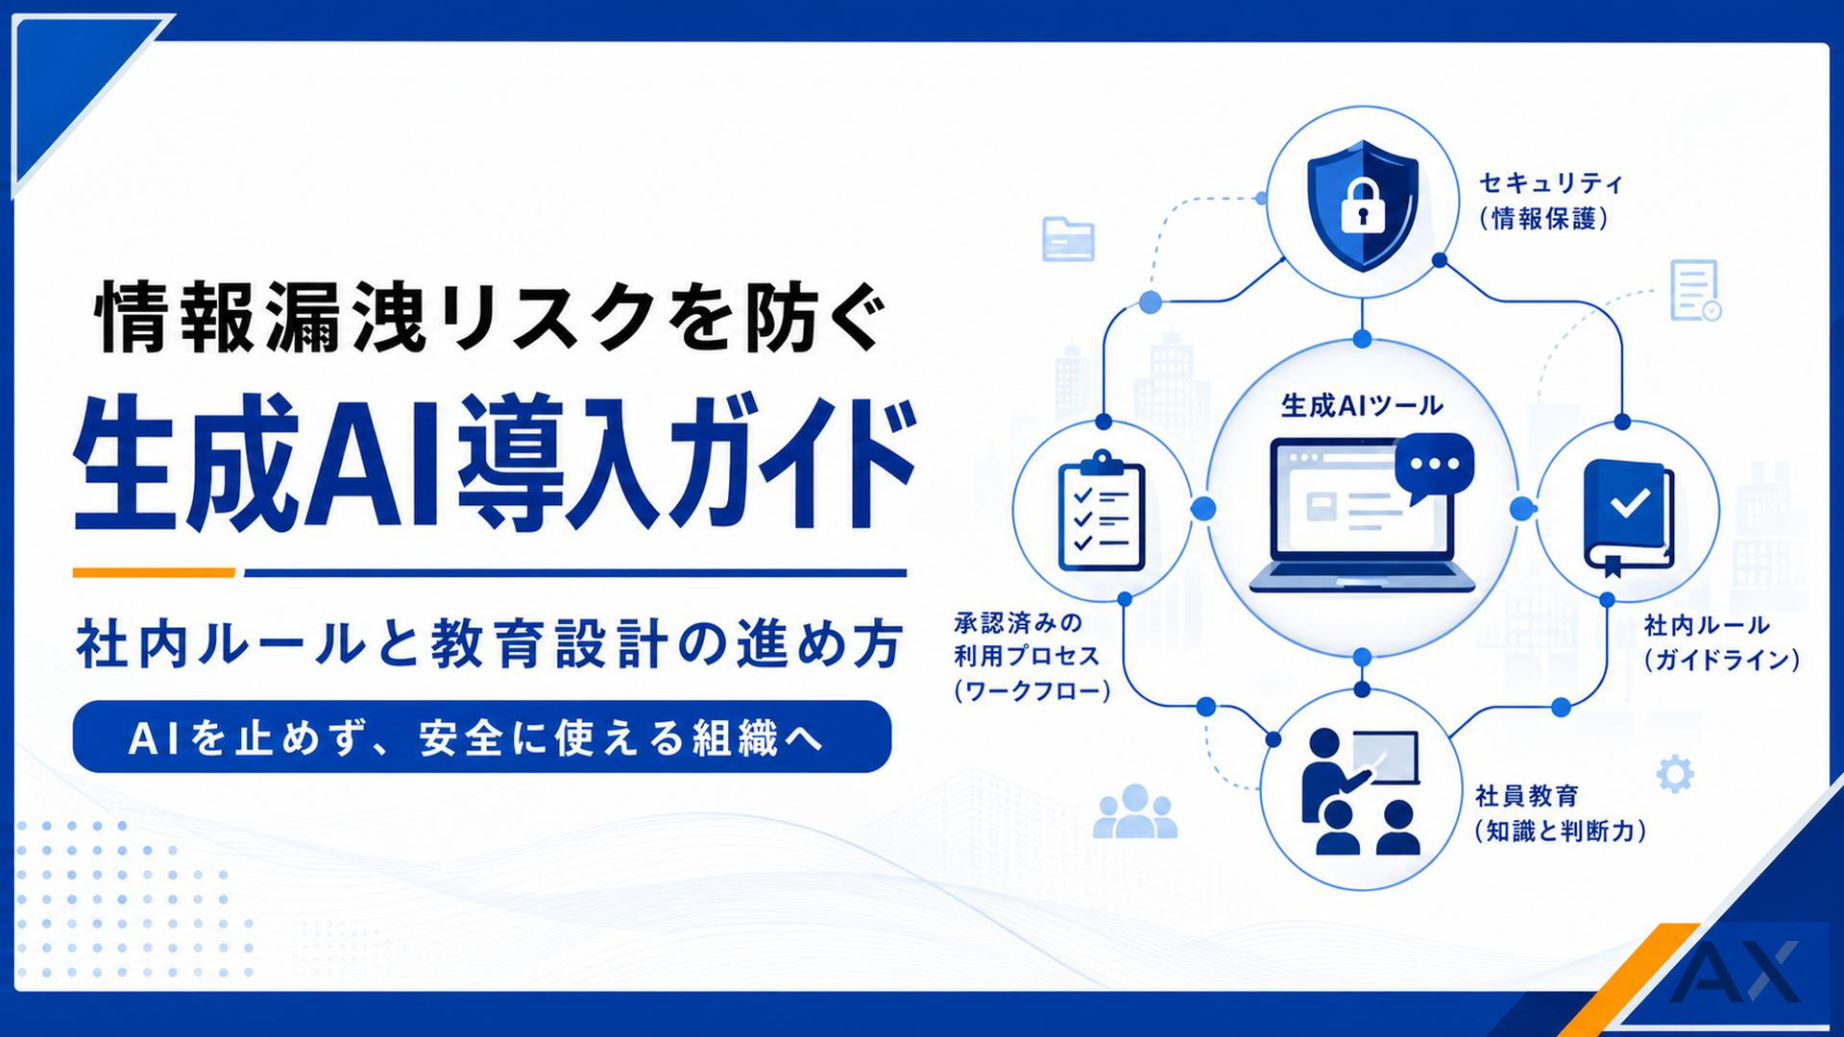
情報漏洩を防ぎながら生成AIを導入する社内ルールと教育設計を整理。
AIの脆弱性とは?セキュリティリスクの全体像
AIの脆弱性とは、AIを含むシステムの機密性・完全性・可用性などを損なう弱点です。コードや認証の不備に加え、モデル、学習データ、外部情報と指示の扱いにも注意が必要です。
実際のサービス障害については、OpenAIの2023年3月24日公表で原因と影響が説明されています。
従来のソフトウェア脆弱性との違い
従来のソフトウェア脆弱性は、主にプログラムのコーディング上のミスや設計上の不備が原因でした。SQLインジェクションやクロスサイトスクリピティング(XSS)などが代表的で、コード修正やパッチ適用が主な対策となります。
一方で、AIの脆弱性はより広範な領域に及びます。AIの思考を形成する「学習データ」、学習済みの「AIモデル」、そしてAIとの対話に用いる「プロンプト」のすべてが攻撃対象となりうるのです。そのため、従来のコード中心のセキュリティ対策だけではAIシステムを守り切ることはできません。AIならではのリスクを理解し、新たな防御策を講じる必要があります。
AIモデル特有の攻撃対象領域(アタックサーフェス)
AIシステムの攻撃対象領域(アタックサーフェス)は、開発から運用までのライフサイクル全体に広がっています。具体的には、以下のような領域が攻撃者の標的となります。
- 学習データ段階: 悪意のあるデータを学習データに混入させ、AIの判断を意図的に歪める「データ汚染(ポイズニング)」攻撃のリスクがあります。
- モデル学習段階: 学習プロセスそのものを妨害したり、モデルの構造を盗み見たりする攻撃が考えられます。
- AIでは、入力の改変による誤認識や、LLMへの不正な指示なども攻撃経路になります。ただし、すべてのAIが同じ攻撃にさらされるわけではなく、用途・構成・権限に応じた評価が必要です。
このように、AIシステムは多岐にわたる攻撃経路を持っており、それぞれに対応した防御策が求められます。ライフサイクル全体を俯瞰した対策が不可欠です。
なぜ今、AIの脆弱性対策が重要視されるのか
今、AIの脆弱性対策が重要視される背景には、生成AIの急速なビジネス活用拡大があります。多くの企業が業務効率化のため生成AIを導入しており、それに伴いサイバー攻撃の標的も増えています。AIが企業の基幹システムや機密データにアクセスする機会が増えれば、一度の攻撃がもたらす被害は計り知れないものになるでしょう。
2023年3月20日、ChatGPTで他の利用者の会話履歴のタイトル等が見える不具合が発生し、サービスが一時停止しました。OpenAIはredis-pyライブラリの不具合を原因として説明し、修正したと公表しています。モデル自体への攻撃とは区別すべき事例です。(出典:OpenAIの2023年3月24日公表)
機密情報を外部AIサービスに入力する行為も、社内規程や契約に反する可能性があります。外部への送信、モデルの学習への利用、第三者への表示・流出は別の事象として確認します。
高性能なモデルを選んでも、接続先の権限やデータの扱いまで自動的に安全になるわけではありません。モデルの能力とシステム全体の安全性を分けて評価しましょう。
経営層・非技術者向け:AIセキュリティの3つの要点
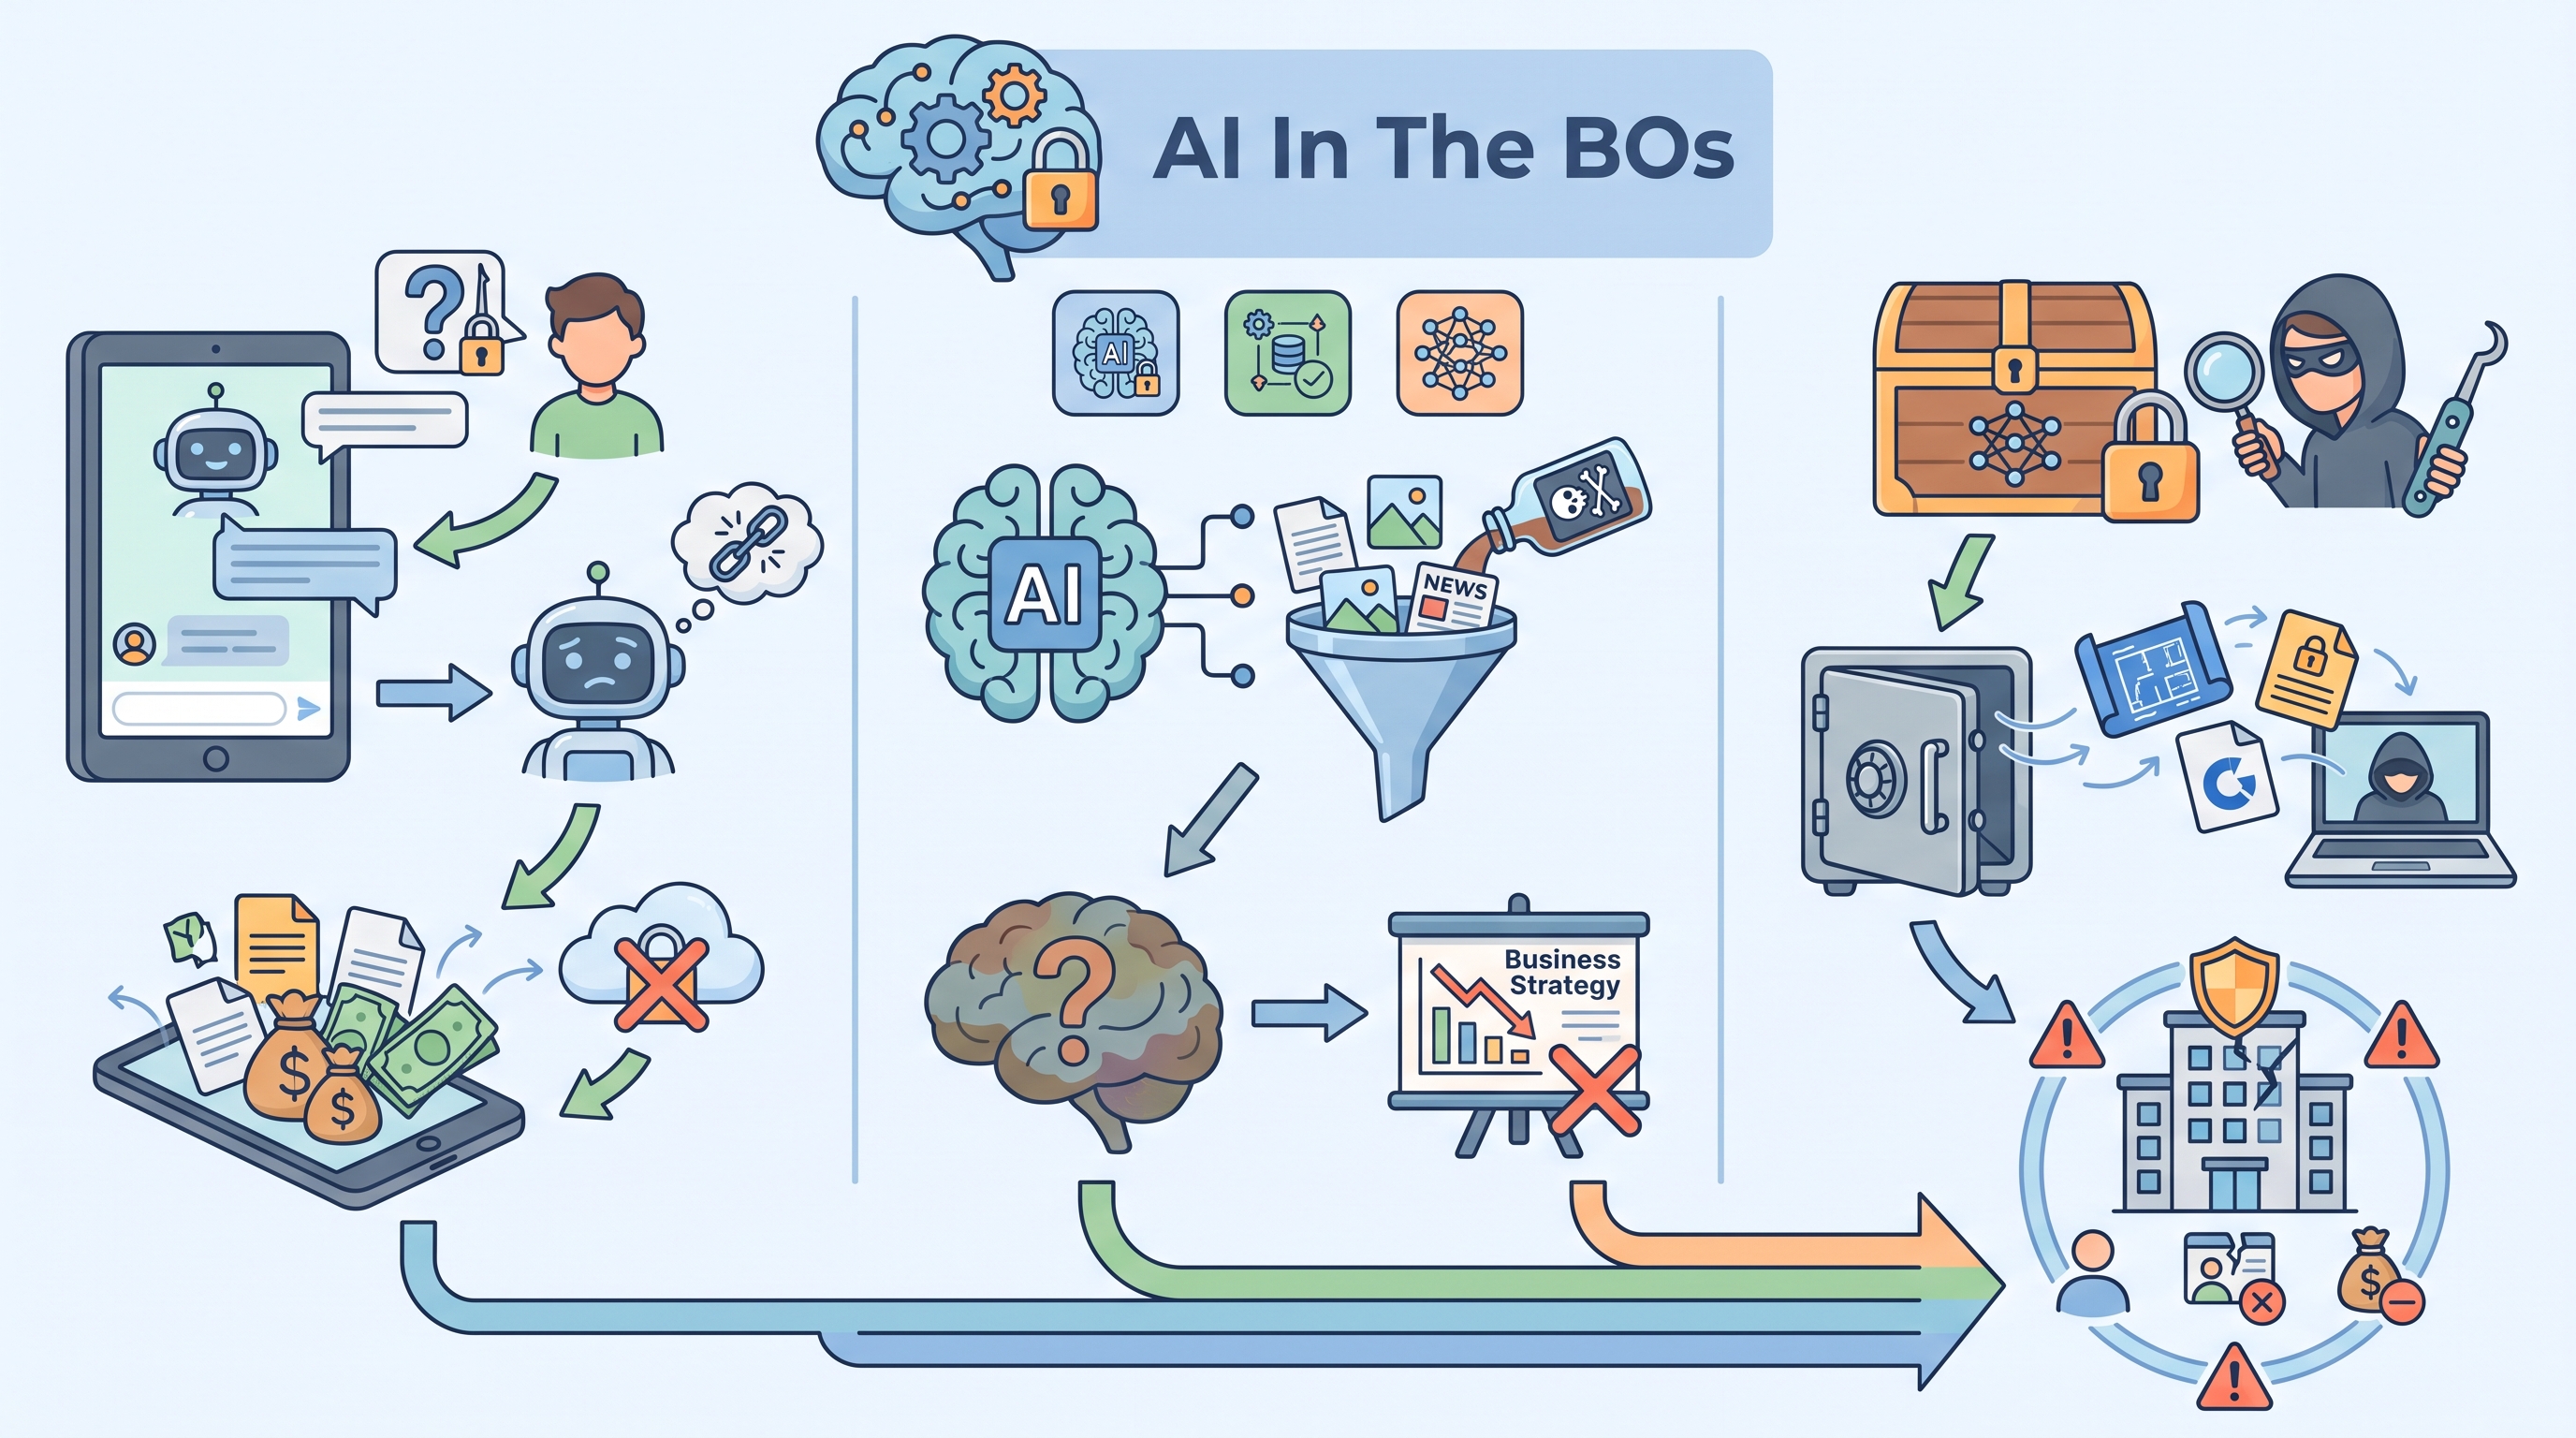
AIの導入は業務効率を飛躍的に向上させますが、同時に新たなセキュリティリスクも生まれます。専門家でなくても、経営判断として知っておくべきAIセキュリティの要点は、従来のITセキュリティとは異なり、「データ」や「対話」そのものが攻撃経路になる点です。
最低限、以下の3つのポイントを把握しておく必要があります。
- 入力や外部文書に埋め込まれた指示の悪用:LLMを意図しない動作に誘導する攻撃です。他の顧客の情報を取得できるかは、検索・APIの権限やデータ分離にも依存します。
- 「学習データ」への攻撃:AIの思考の基盤となる学習データに、意図的に偏った情報や偽情報を混ぜ込む攻撃です。この結果、AIが誤った分析結果を出力し続け、経営判断を誤らせる危険性があります。
- モデルやデータの保護:応答を使ってモデルの機能を模倣するモデル抽出と、学習データ中の情報を推測・抽出するプライバシー攻撃は区別します。いずれも構成と公開情報に応じて評価します。
AI固有の挙動に加えて、通常のプログラムや認証・権限の不備も対策対象です。技術的な防御、社内ルール、出力確認を組み合わせます。
【種類別】AIシステムに潜む主要な脆弱性
AIシステムが抱える脆弱性には、従来のサイバー攻撃とは異なる特有の手法が存在します。これらはAIの学習プロセスや意思決定の仕組みそのものを悪用するため、根本的な理解が欠かせません。
モデルの更新後も、新しい入力経路や接続先、権限への影響を確認します。モデル名や新しさだけで、攻撃への耐性を判断しないことが大切です。
以下は代表的な攻撃・リスクの例です。網羅的な4分類ではありません。NISTも、攻撃段階、目的、攻撃者の能力など複数の観点で整理しています。(参考:NISTの分類資料)
- プロンプトインジェクション:悪意ある指示を与え、AIに開発者の意図しない動作をさせる攻撃です。
- データ汚染(ポイズニング):学習データに不正な情報を混ぜ込み、モデルの判断を偏らせたり、誤った出力を生成させたりします。
- モデル抽出:公開API等への問い合わせと応答を利用し、モデルの機能を模倣したり、一部の情報を推定したりする攻撃です。学習データの回収と同義ではありません。
- 敵対的サンプル:モデルを誤認識させる目的で作られた入力です。微小な変更は代表例ですが、変更が必ず人に見えないとは限りません。
プロンプトインジェクションとジェイルブレイク
プロンプトインジェクションは、LLMに意図しない動作をさせる入力を指します。利用者からの直接入力のほか、Webページ、メール、ファイル等に埋め込まれた指示を取り込む間接的な経路にも注意が必要です。安全上の制約を回避するジェイルブレイクも関連します。(参考:OWASPの解説)
指示文を強めたり、入力をフィルタリングしたりするだけで完全に防げるとは限りません。外部情報を信頼済みの命令と同列に扱わず、ツール権限の制限や重要操作の承認も組み合わせます。
学習データ汚染(データポイズニング)
データポイズニングは、AIの学習データセットに意図的に不正なデータや誤ったラベルのデータを混入させる攻撃手法です。攻撃者は、AIが特定の入力に対して誤った判断を下すように仕向けたり、システム全体に偏見(バイアス)を埋め込んだりします。例えば、自動運転車の画像認識AIに「『止まれ』の標識を『速度制限なし』と誤認識させる」ようなデータを学習させることが考えられます。
学習・追加学習等のデータを改ざんされると、その影響を後から特定することが難しい場合があります。データの出所、変更履歴、アクセス権限、評価結果を管理します。
敵対的サンプル(Adversarial Examples)
敵対的サンプルは、AIモデルを誤認識させるために作られた入力です。小さな摂動を加えるものなどがありますが、すべてのモデルや入力に同じ方法が成功するわけではありません。
Goodfellowらの「Explaining and Harnessing Adversarial Examples」は、入力への意図的な摂動によってモデルが高い確信度で誤分類する現象を検討した研究です。個別の実験結果を、現在のすべての画像認識AIにそのまま当てはめることはできません。
この攻撃は、AIの判断の正確さが極めて重要な分野で深刻な脅威となります。具体的には、自動運転システムが道路標識を誤って解釈したり、医療AIが診断画像から誤った結論を導き出したりする危険性を含んでいます。
学習データに不正を仕込むデータポイズニング攻撃とは異なり、敵対的サンプルはすでに運用されているAIシステムを直接攻撃できる点が特徴です。 そのため、リアルタイムでの検知や防御策が不可欠となります。
(出典:Explaining and Harnessing Adversarial Examples)
モデル抽出・窃取(Model Stealing)
モデル抽出では、APIなどへの問い合わせと応答を使ってモデルを模倣します。取得可能な出力、問い合わせ回数、モデルの種類によって成果は異なり、元モデルの構造・パラメータや同等性能を必ず再現できるわけではありません。
TramèrらのUSENIX Security 2016の研究は、予測APIからのモデル抽出を実証した代表的な研究です。研究での成功条件と、個々のサービスに対する実際の攻撃可能性は分けて評価します。(出典:原論文)
模倣したモデルが別の攻撃の検討に利用される可能性もあります。APIの認証、利用量の監視、不要に詳細な出力の抑制などを、サービスの用途に合わせて検討します。
(出典:Stealing Machine Learning Models via Prediction APIs)
AIへの代表的な攻撃手法とその仕組み
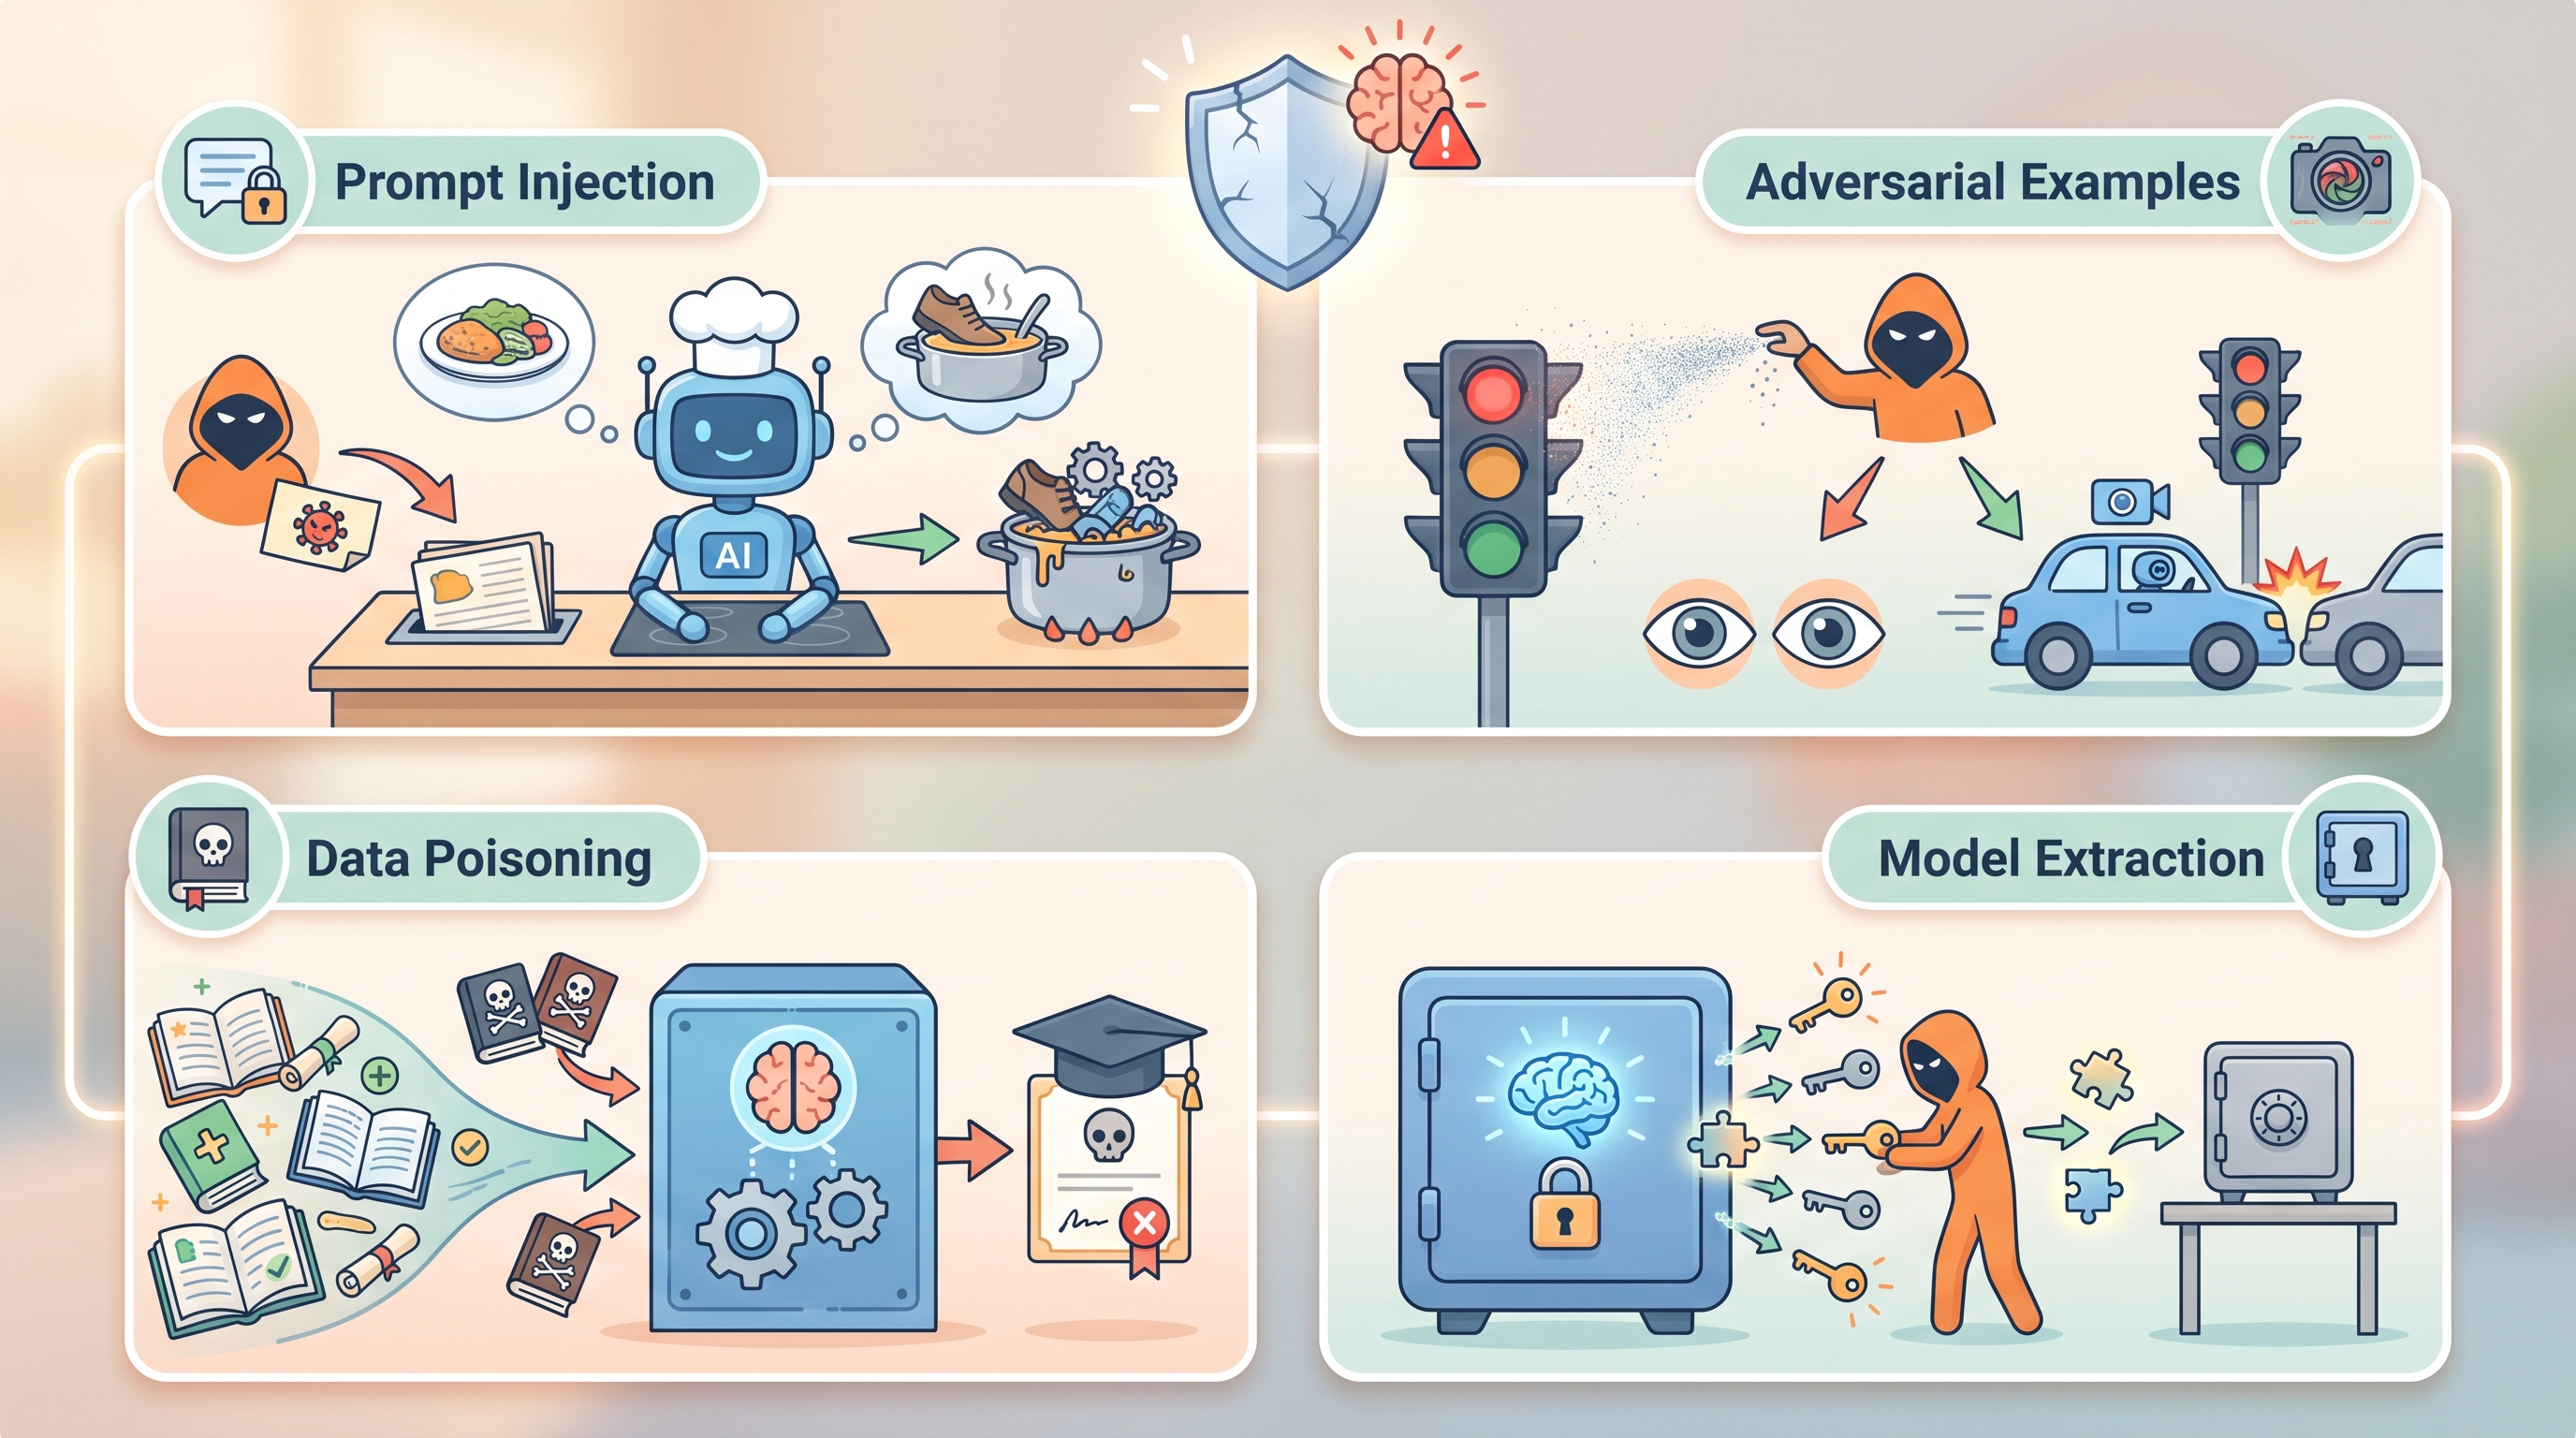
ここでは前節の4つの例を整理します。攻撃者の権限、対象モデル、データの利用方法によって成立条件は異なります。
- プロンプトインジェクション:悪意のある指示(プロンプト)を与え、開発者の意図しない動作を引き起こさせる攻撃手法です。
- 敵対的サンプル:誤認識させる目的で入力を改変する手法です。道路標識への改変などが安全上の影響につながる可能性もありますが、実環境での成立条件を別に検証する必要があります。
- データ汚染(Data Poisoning):AIの学習データセットに意図的に不正なデータを混入させ、モデルの判断基準を歪める攻撃です。 これにより、AIが特定の対象に対して偏った、あるいは誤った結果を出力するようになります。
- モデル抽出:問い合わせへの応答を利用して、モデルの機能や一部の情報を推定する手法です。すべてのパラメータを回収できるとは限りません。
これらの手法を把握した上で、次に業務への影響を確認します。
AIの脆弱性が引き起こす深刻なセキュリティリスク
AIの脆弱性が悪用された場合、企業は多岐にわたる深刻なセキュリティリスクに直面します。その影響は、単なるデータの損失にとどまらず、事業継続そのものを脅かす可能性を秘めています。ここでは、代表的な3つのリスクについて具体的に解説します。
機密情報や個人情報の漏洩
AIの脆弱性がもたらす最も直接的な脅威の一つが、機密情報や個人情報の漏洩です。プロンプトインジェクション攻撃により、AIがアクセス権を持つデータベースから顧客リストや開発中の製品情報、財務データといった企業の根幹に関わる重要情報を引き出されてしまう可能性があります。
例えば、社内文書の検索・要約を行うAIアシスタントが攻撃者に操られ、非公開の役員会議事録の内容を外部に送信してしまう、といったシナリオが考えられます。一度情報が漏洩すれば、企業の社会的信用の失墜や、顧客からの損害賠償請求に発展する恐れがあります。
AIによる誤った意思決定と業務への影響
データポイズニングや敵対的サンプルといった攻撃は、AIの判断を根底から覆し、誤った意思決定を誘発します。これにより、企業の業務プロセスに深刻な混乱が生じる可能性があります。例えば、需要予測AIが汚染されたデータによって「在庫が過剰にある」と誤った予測を出した場合、企業は生産ラインを停止し、大きな販売機会の損失を被るかもしれません。
また、融資審査AIが不正なデータによって特定の属性を持つ申請者を不当に排除したり、採用AIが特定の候補者を不適切に評価したりするなど、公平性や倫理観に関わる重大な問題を引き起こすリスクもはらんでいます。
システムの不正操作とサービス停止
AIが外部のシステムやツールと連携している場合、脆弱性を突かれることでシステム全体が不正に操作される危険性があります。AIエージェントのように、メール送信やファイル操作などの権限を持つAIが乗っ取られた場合、攻撃者はその権限を悪用して社内システムを破壊したり、顧客に対して大量のスパムメールを送信したりできます。
結果として、ECサイトが停止して売上がゼロになったり、工場の生産管理システムが停止して操業不能に陥ったりするなど、事業継続に致命的なダメージを与えかねません。AIの活用範囲が広がるほど、このリスクは増大していきます。
公表済みの障害事例と、研究・評価で指摘されるリスク
実際のサービス障害、研究で示された攻撃可能性、将来の想定は区別して読む必要があります。以下は、その違いを踏まえて確認するための例です。
プロンプトインジェクションでは、AIが読める情報と実行できる操作の範囲が被害に影響します。
- 情報漏洩リスク:OWASPは、プロンプトインジェクションの影響として機密情報の開示などを挙げています。これはリスクの整理であり、特定企業で2024〜2025年に複数の被害が起きたという確認ではありません。
- エージェントの操作リスク:外部サイトやファイルに含まれる指示をAIが取り込むと、連携機能の悪用につながる可能性があります。OWASPの間接プロンプトインジェクションの説明を参考に、送信・削除などの権限を制限します。
- 学習データの汚染:攻撃者による意図的な改ざんを想定し、出所と変更履歴を管理します。生成データを繰り返し学習した際の性能劣化は、必ずしも悪意ある攻撃とは限らず、データポイズニングと同一視できません。
これらの事例は、AIの判断プロセスが悪用されると、情報漏洩やシステムの不正操作、さらには事業継続に影響を及ぼす損害にまで発展しうることを示しています。特に、AIが外部システムと連携する場合には、想定外の挙動によるリスク管理が不可欠です。
国内の利用者が確認したい個人情報の取り扱い
個人情報保護委員会は、生成AIサービスへの入力情報や規約を確認するよう注意喚起しています。サービスへの入力が、社内で許可される情報の範囲内かを確認しましょう。個別の官公庁・自治体の被害事例を確認したという説明ではありません。
2023年6月2日の注意喚起では、事業者が個人情報を含むプロンプトを入力する際、特定した利用目的の達成に必要な範囲内かを十分に確認するよう求めています。
本人の同意なく個人データを入力し、応答の出力以外の目的で取り扱われる場合には法に違反する可能性があるため、提供事業者が機械学習に利用しないこと等を十分に確認する必要があります。個人情報と個人データの用語、民間事業者と行政機関等の規律も区別します。
法人向けプランやAPIでも、学習利用、保存期間、人によるアクセス、委託・再委託、削除条件はサービスと契約・設定で異なります。「学習に使わない」ことだけで、保存や漏洩のリスクまでなくなるわけではありません。
個別の入力可否は、社内規程と契約内容も踏まえて判断してください。
海外で公表されたAIサービスの障害例
外部サービスへの機密情報の送信と、第三者への表示は分けて確認すべきです。学習への利用も、入力したという事実だけでは確認できません。ここでは提供元が原因を説明したChatGPTの障害を取り上げます。
OpenAIは、2023年3月20日のChatGPT障害で、一部の利用者に他の利用者の会話タイトル等が見えたと公表しました。原因はredis-pyライブラリの不具合で、修正済みと説明しています。AI固有の攻撃だけでなく、周辺ソフトウェアの修正と利用者間のデータ分離も重要と分かる事例です。
(出典:OpenAIの2023年3月24日公表)
自社のAIセキュリティ体制をチェックする5つのステップ
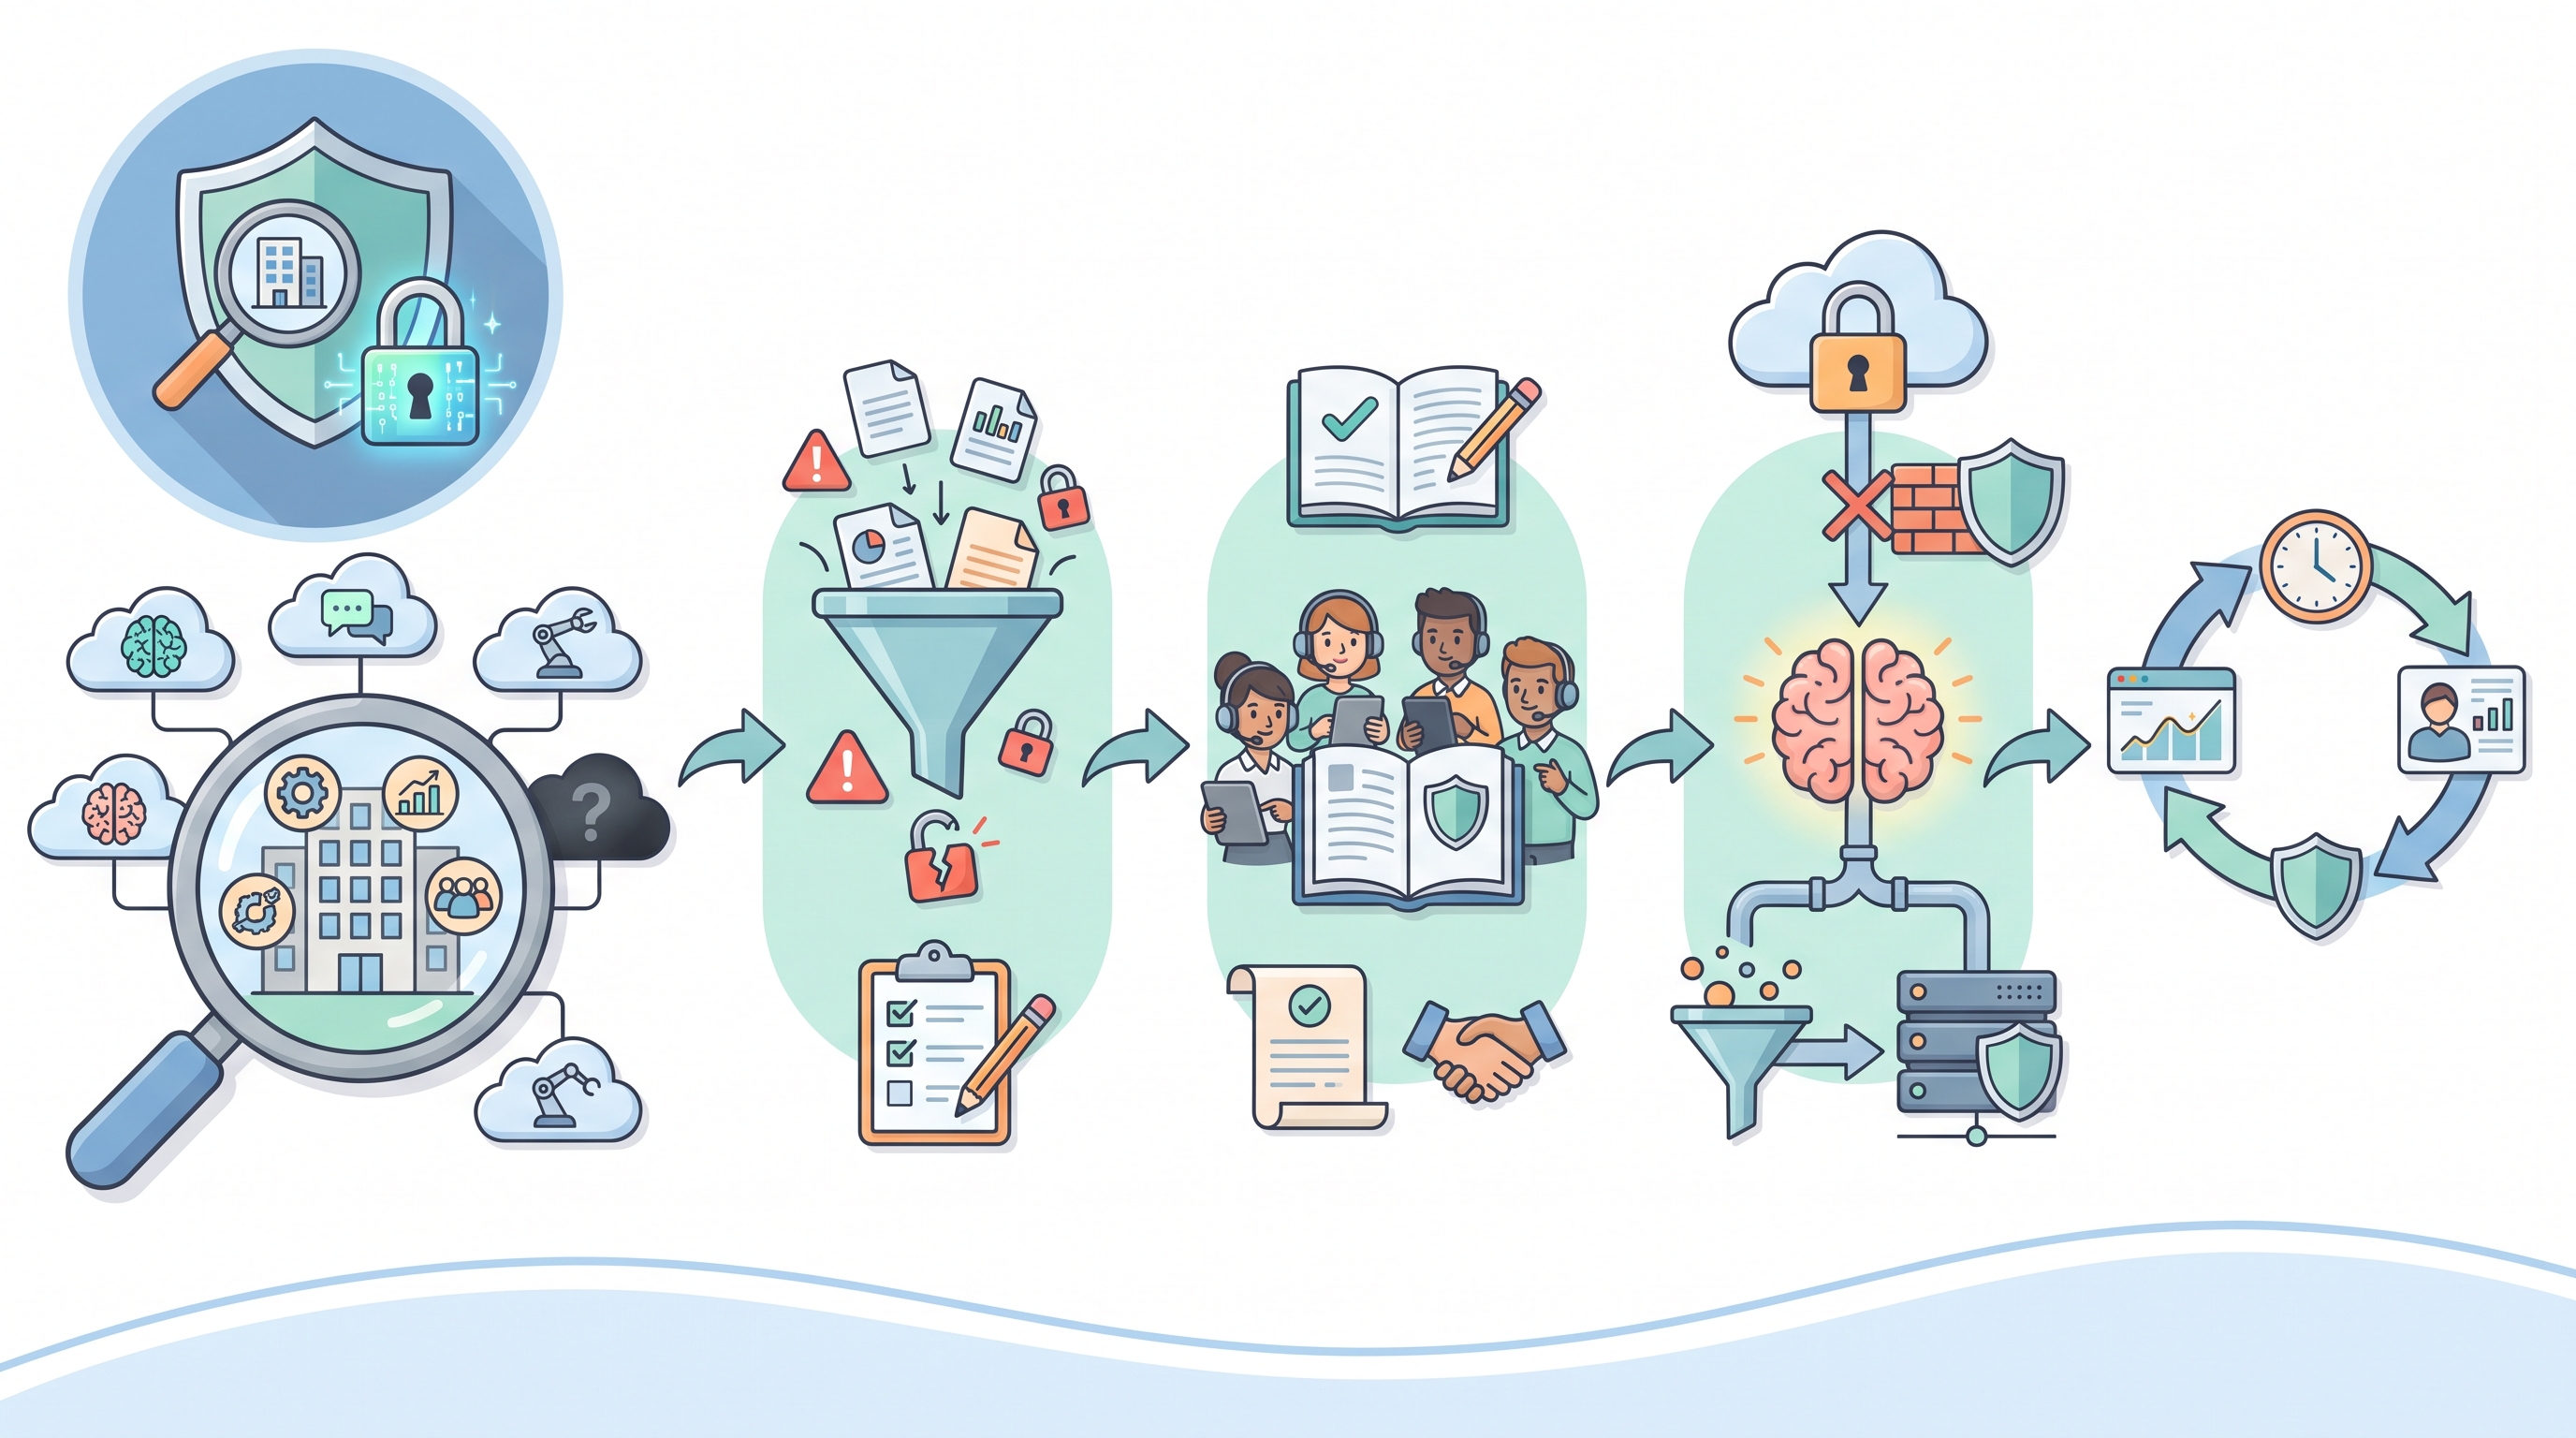
AIの脅威は他人事ではありません。自社のAIセキュリティ体制を網羅的に見直し、潜在的なリスクに備えることが急務です。安全なAI活用に向け、以下の5つのステップで現状をチェックしましょう。
まず、社内で利用されているAIツールと、その利用目的を正確に把握することから始めます。これにより、管理外で利用される「シャドーIT」のリスクを可視化できます。
- ステップ1:利用実態の可視化。サービス名、プラン、モデルとバージョン、用途、入力データ、連携先と権限を棚卸しします。
- ステップ2:潜在リスクの評価
プロンプトインジェクションによる情報漏洩や、データの汚染など、業務ごとのリスクを具体的に洗い出します。 - ステップ3:利用ガイドラインの策定
機密情報や個人情報の取り扱いルールを明確に定め、全従業員が遵守すべき基準を作成します。 - ステップ4:技術的な防御策の導入
入力データが学習に使われない法人向けプランへの移行や、不正アクセスを検知する仕組みを導入します。 - ステップ5:定期的な教育と見直し
全従業員を対象としたセキュリティ研修を定期的に実施し、最新の脅威に合わせて体制を継続的にアップデートします。
この5ステップは本記事の実務向け整理です。NIST AI RMFの公式な5段階手順ではありません。NISTのGovern・Map・Measure・Manageの4機能も参考に、自社の責任者と評価方法を定めましょう。
(出典:AI RMF – NIST)
企業が今すぐ実施すべきAI脆弱性への対策
AIの脆弱性がもたらすリスクは深刻ですが、適切な対策を講じることでその脅威は大幅に軽減できます。単一のツール導入で終わるのではなく、「技術」「組織」「運用」の三つの側面から総合的にアプローチすることが極めて重要です。
企業が直ちに取り組むべき具体的な対策は、以下の3つの領域に大別されます。これらを組み合わせることで、多層的な防御体制を構築できます。
- 技術的対策:入力・出力の検査、認証・認可、権限の制限、依存ソフトウェアの更新、用途に応じた診断を組み合わせます。すべての企業に同じ製品や診断が法的に義務付けられるという意味ではありません。
- 組織的対策:全社でセキュリティ意識を統一し、ルールを整備することです。AI利用ガイドラインの策定や、インシデント発生時の対応体制の構築が該当します。
- 運用的対策:日々の業務の中でセキュリティを維持する仕組みを指します。AIの利用状況の継続的な監視や、データへのアクセス権限の厳格な管理が重要になります。
効果は、自社で事故件数、検知・確認に要した時間、誤検知などの基準値を取り、導入後に比較します。研修やツールの導入だけで事故件数の削減を保証することはできません。
まずは、自社にとって最もリスクの高い領域から着手し、段階的に対策を強化していくことが現実的な進め方と言えるでしょう。
技術的対策:入力値のサニタイズと出力フィルタリング
入力と出力の検査は防御の一部ですが、通常の文字列サニタイズだけでプロンプトインジェクションを除去できるとは限りません。出力をコード・SQL・HTML等として使う場合は、実行先の規則に沿って検証します。モデルの判断と独立した認可、最小権限、重要操作の人による承認も組み合わせます。
これらの対策は、AIを外部の脅威から守るための第一の防衛ラインとして機能します。
組織的対策:AI利用ガイドラインの策定と従業員教育
どれだけ高度な技術的対策を施しても、それを利用する従業員のセキュリティ意識が低ければ、その効果は限定的です。全社的に統一された「AI利用ガイドライン」を策定し、継続的な従業員教育を実施することが、組織的な対策の要となります。
ガイドラインでは、従業員が判断に迷わないよう、具体的なルールを明確に定める必要があります。 例えば、以下のような項目を盛り込みます。
- 入力禁止データ:個人情報、顧客の機密情報、社外秘の技術情報など
- 生成物の取り扱い:著作権の確認、ファクトチェックの義務、社外公開時の承認プロセス
- 外部ツールの利用:会社が許可したAIサービスのみ利用を許可し、無許可ツールの利用を禁止するルール
さらに、ガイドラインを形骸化させないためには、全従業員を対象とした継続的な教育が不可欠です。単に禁止事項を伝えるだけでなく、AIのリスクを正しく理解し、安全に活用するためのスキルを向上させる機会と捉えるべきです。
グラシズ社の2025年9月の原取材では、LPライティングを内製化し、従来1本あたり10万円だった外注費を削減、ライティングの工数を3営業日から2時間へ短縮したと報告されています。AI利用料や社内人件費を含む全費用がゼロになったという意味ではありません。(出典:原取材)
運用的対策:継続的なモデルの監視と脆弱性診断
AIシステムは一度構築したら終わりではなく、継続的な監視とメンテナンスが必要です。AIモデルの挙動を常にモニタリングし、予期せぬ出力やパフォーマンスの劣化が見られないかをチェックする体制を整えましょう。不審な動きを検知した際には、速やかに原因を調査し、対処することが求められます。
また、人間の専門家や専用ツールによる定期的な脆弱性診断も欠かせません。これにより、自社では気づけなかった潜在的な脆弱性を発見し、攻撃を受ける前に修正することができます。新たな攻撃手法は日々生まれているため、常に最新の脅威情報にアンテナを張り、対策をアップデートし続ける姿勢が重要です。
サプライチェーンリスク管理:外部AIサービスの選定基準
多くの企業は、自社でAIモデルを開発するだけでなく、外部のAIサービス(APIなど)を組み合わせて利用しています。この場合、利用するサービスのセキュリティレベルが自社のセキュリティレベルを左右することになります。そのため、サービスを選定する際には、価格や機能だけでなく、提供元のセキュリティ体制を厳しく評価する必要があります。
具体的には、提供元がどのようなセキュリティ対策を講じているか、第三者機関による認証を取得しているか、脆弱性が発見された場合に迅速な情報公開と対応が行われるか、といった点を契約前に必ず確認すべきです。
AIを悪用したサイバー攻撃の最新手口
攻撃者がAIを調査、コード作成、詐欺コンテンツ作成に利用する例が公表されています。ただし、AIを利用する攻撃とAIシステム自体の脆弱性は同じ分類ではありません。
GTIGは2026年5月、AIで開発されたと評価するゼロデイの悪用コードなどを報告しました。AI利用については調査側の評価を含むため、完全自律で攻撃が成功したと読み替えないようにします。(出典:GTIGの2026年5月12日報告)
自動化できる範囲は対象環境、権限、利用するモデルやツールに依存します。「完全無人で常に侵入できる」「侵入から横展開の平均時間が一律に短縮した」とは判断できません。
現在、AIは主に次のような攻撃手法の高度化に悪用されています。
- ソーシャルエンジニアリング:文章、音声、映像の生成が詐欺に悪用される可能性があります。自然な文面や声だけで本人確認をせず、別経路で確認します。
- マルウェア開発の支援:GTIGは、AIを使ったコード作成や難読化等を報告しています。AIが必ず検知を回避できるという意味ではありません。
- 攻撃の計画と実行の自動化: 脆弱性の探索、権限昇格、データ窃取といった一連の攻撃プロセスを自動化する研究が進んでいます。 人間の介入を最小限に抑え、攻撃の意思決定をAIが行う事例も確認されています。
これらの脅威に対抗するため、セキュリティ専門家コミュニティも対策を進めています。例えば、OWASPは「LLMアプリケーションのためのOWASP Top 10」を公開し、AI利用システム特有の脆弱性への注意を喚起しています。 また、日本や米国を含む各国政府も連携し、安全なAI開発のためのガイドライン策定を進めています。
自律型サイバー攻撃エージェントの脅威
AIエージェントに探索や操作の一部を担わせる試みが報告されています。ただし、対象環境へのアクセス、認証情報、利用するツールなどの前提があります。単に目的を伝えれば必ず侵入から窃取まで完遂できるという説明は適切ではありません。
防御側は、依存ソフトウェアの更新、権限管理、検知・対応を継続して改善します。将来のAI同士の攻防は予測であり、現在のすべての攻撃が無人化しているわけではありません。
AIによる高度なフィッシングメールやディープフェイクの生成
生成AIは、自然な文章の作成を詐欺に悪用される可能性があります。文法や言い回しだけで正当な依頼と判断せず、送信元、リンク先、依頼の内容を確認します。
さらに、ディープフェイク技術を悪用すれば、経営者や取引先の声や映像を偽造し、従業員に不正な送金を指示する「ビジネスメール詐欺(BEC)」を仕掛けることも可能です。音声や映像といった、これまで信頼性の高い情報とされてきたものさえも、疑ってかかる必要が出てきています。
AI脆弱性対策に役立つツール・サービス
巧妙化・複雑化するAIの脅威に対し、自社のリソースだけですべて対応するのは困難な場合があります。幸いなことに、AIシステムのセキュリティを強化するための様々なツールやサービスが登場しており、これらを効果的に活用することで、対策の効率と質を高められます。
具体的には、以下のようなサービスが有効です。
- AI脆弱性診断サービス:プロンプトインジェクションなど、AI特有の攻撃手法に対する耐性を専門家がテストし、潜在的なリスクを可視化します。
- LLM向けファイアウォール:不正な入力や意図しない出力をリアルタイムで検知・ブロックし、AIモデルを保護します。
- AIセキュリティ研修・コンサルティング:開発者や利用者のリテラシーを向上させ、組織全体のセキュリティレベルを底上げします。
研修の効果は、対象業務、受講後の運用、確認工程によって異なります。業務時間の短縮事例があっても、セキュリティ事故が減ることの証明とは別です。研修と併せて権限・契約・監視の整備も評価しましょう。
自社の状況に合わせてこれらのツールやサービスを組み合わせることで、最新の脅威へも迅速に対応できる、より強固なセキュリティ体制を構築できます。
AI搭載の脅威検知・防御プラットフォーム
WAF・WAAP、EDR・NDR等は、それぞれWeb・API、端末、ネットワーク等の保護を担います。AIを搭載しているだけでプロンプトインジェクションにも対応するとは限りません。LLM向けの検査機能、対応範囲、誤検知、回避可能性を個別に検証してください。
AIシステム/コード向けの脆弱性診断サービス
AIシステムに対する診断では、構成と権限に応じて、プロンプトインジェクション、データ汚染、モデル抽出等の対象を定めます。すべてのリスクを一度の診断で網羅・解消できるわけではないため、範囲と再評価の条件を確認します。
開発ライフサイクルに組み込むセキュリティツール
セキュリティを開発の初期段階から組み込む「シフトレフト」の考え方は、AI開発においても重要です。AI/MLモデルの開発ライフサイクルにセキュリティを統合するMLSecOps(Machine Learning Security Operations)ツールも登場しています。これらのツールは、学習データの完全性を検証したり、利用するオープンソースライブラリに既知の脆弱性がないかをチェックしたり、完成したモデルのセキュリティテストを自動化したりする機能を提供します。開発の早い段階で問題を発見することで、手戻りのコストを大幅に削減できます。
AIセキュリティに関する研修・教育サービス
教育では、立場ごとの責任、入力してよい情報、事故時の連絡先を具体的に確認します。効果は理解度や運用状況で評価し、費用対効果が常に最も高いと判断しないようにしましょう。
AI開発ライフサイクルにおけるセキュリティ(Secure AI Framework)
設計から運用・廃棄までセキュリティを考慮します。GoogleのSecure AI Framework(SAIF)は6つの中核要素を示す概念的な枠組みです。MLSecOpsは機械学習の開発・運用へセキュリティを組み込む実践を指し、両者を同じ固有の枠組みと扱わないようにしましょう。(参考:Google SAIF)
設計段階での脅威モデリング
脅威モデリングでは、守る情報、入力経路、信頼境界、操作権限、攻撃者の能力を整理します。例えば、外部文書の指示が社内検索AIの操作に影響するか、学習データを書き換えられる主体がいるかを別々に検討し、対策を設計します。
この段階でリスクを特定しておくことで、後の工程での大幅な手戻りを防ぎ、効率的にセキュリティを実装できます。
実装・テスト段階でのセキュリティテスト
実装段階では、セキュアコーディングの原則に従い、脆弱性を生まないように開発を進めます。その後のテスト段階では、機能テストや性能テストに加えて、AIに特化したセキュリティテストを実施することが重要です。具体的には、以下のようなテストが挙げられます。
- プロンプトインジェクションテスト: 様々なパターンの悪意のあるプロンプトを入力し、システムが意図しない動作をしないか検証します。
- 敵対的サンプル耐性テスト: 意図的に生成した敵対的サンプルを入力し、モデルが誤認識を起こさないかを確認します。
- データ汚染の評価:許可された隔離環境で、代表的な改変に対する影響を評価します。本番データに無断で汚染データを混ぜず、評価後の復旧方法も決めます。
これらのテストを通じて、机上での設計が実際に機能するかを検証し、システムの堅牢性を高めていきます。
AIセキュリティに関する国内外のガイドラインと法規制
AIの社会実装が急速に進む中、そのリスクを管理し安全な利用を促進するルール作りが世界各国で進められています。技術的な対策だけでなく、こうした法的な枠組みを理解することは、グローバルに事業を展開する企業にとって不可欠です。ここでは、世界初の包括的なAI規制として注目されるEUの「AI法」を解説します。
EU AI法は用途やリスクに応じて義務が異なり、EU域外の事業者も対象になる場合があります。EU向け提供、域内への導入、出力の利用場所や例外など、適用範囲を確認します。一般的な4段階の説明だけで個々の義務を判断することはできません。
制裁金には違反の種類ごとの上限があり、規模なども考慮されます。現行の法文と欧州委員会の説明を参照してください。(参考:EUR-Lex現行法、欧州委員会の執行案内)
主な罰則は以下の通りです。
- 禁止されているAIの利用(許容できないリスク): 最大3,500万ユーロ、または全世界の年間総売上高の7%のいずれか高い方。
- 高リスクAIに関する義務違反: 最大1,500万ユーロ、または全世界の年間総売上高の3%のいずれか高い方。
- 当局への不正確・不完全な情報提供: 最大750万ユーロ、または全世界の年間総売上高の1%のいずれか高い方。
これらは上限であり、必ずこの金額になるという意味ではありません。第99条では、中小企業・スタートアップの該当する上限は定額と売上高割合の低い方となる点にも注意が必要です。違反の性質・期間・協力状況なども判断に関わります。
NIST AI Risk Management Framework (AI RMF)
NISTが2023年1月26日に公開したAI RMF 1.0は、設計・開発・利用・評価におけるリスク管理のための自主的な枠組みです。業種や用途に応じて活用し、公式の本文と更新情報を確認します。
AI RMFは、AIのリスク管理プロセスを4つの主要な機能に整理しています。 これにより、組織は体系的かつ継続的にAIのリスクへ対処できます。
- 統治(Govern):組織全体でAIリスク管理の文化を醸成し、方針や責任体制を確立する機能です。 他の3つの機能すべての基盤となります。
- マップ(Map):AIシステムの利用目的や背景を明確にし、潜在的なリスクと影響を特定する機能です。
- 測定(Measure):特定したリスクを分析・評価するため、定量的・定性的な手法や指標を用いてAIシステムの信頼性をテスト・監視します。
- 管理(Manage):測定結果に基づき、リスクへの対応策に優先順位を付けて実行する機能です。 リスクを軽減し、インシデントに備えます。
AI RMFは自主的に利用する枠組みで、法令への適合を自動的に証明するものではありません。NISTはAI RMF 1.0の改訂作業も案内しているため、採用する版と参照日を管理します。
(出典:AI RMF – NIST)
EU AI Actの動向と日本企業への影響
EU AI法は2024年に成立し、段階的に適用されています。禁止行為、ハイリスク用途、透明性、汎用AIモデルなどで義務が異なります。重要インフラや採用等に使うAIも、具体的な用途と例外を確認する必要があります。(参考:欧州委員会の現行案内)
欧州委員会の2026年10月時点の案内では、Annex IIIのハイリスク用途の規則は2027年12月2日、規制対象製品に組み込まれたハイリスクAIは2028年8月2日が適用日です。禁止行為など、すでに適用されている規則もあります。日本企業も域外適用と自社の役割を確認してください。(出典:欧州委員会の現行案内)
(出典:欧州委員会の現行案内)
(参考:欧州委員会の執行案内)
AI脆弱性の今後の動向と将来的な脅威予測
モデルや連携機能の進化に伴い、攻撃経路も変化します。モデル名の新しさだけで安全性を判断せず、利用構成に合わせて評価を更新しましょう。
TrendAIの2026年レポートは、同社がAI関連と集計した2025年のCVEが2,130件、前年比34.6%増と報告しています。AIモデルの欠陥だけの件数や、すべて実際に悪用された事件数ではありません。(出典:原レポート)
将来的に特に警戒すべき脅威の動向として、以下の3点が挙げられます。
- 脆弱性発見・悪用の高速化:AIがコードの解析や悪用コード作成の一部を支援する例が報告されています。候補の検出数と、確認・修正済みの脆弱性数や攻撃成功数を区別します。
- サプライチェーンのリスク:学習データ、モデル、依存ライブラリ、連携ツールの出所と変更履歴を確認します。特定機関の未特定の警告を根拠にせず、実際の構成で評価します。
- 自律型エージェントによる攻撃の自動化:AIが自律的に標的を偵察し、最適な攻撃手法を選択して実行する「AIエージェント」が登場する可能性があります。これにより、攻撃の規模と速度が飛躍的に増大する恐れがあります。
GTIGは2026年5月、AIを使って開発されたと高い確度で評価するゼロデイ悪用コードについて、提供元との連携で活動を妨害したと報告しています。AI関与は評価であり、攻撃が完全無人で成功したとの説明ではありません。(出典:GTIGの2026年5月12日報告)
(出典:AI vulnerability exploitation initial access)
(出典:Trend Micro: Fault Lines in the AI Ecosystem)
マルチモーダルAIがもたらす新たな脅威
今後のAIは、テキストだけでなく、画像、音声、動画など複数のデータ形式(モダリティ)を統合的に扱う「マルチモーダルAI」が主流になると考えられています。これにより利便性が向上する一方で、新たな攻撃経路が生まれる可能性があります。例えば、一見無害な画像データの中に、悪意のあるプロンプトを隠して埋め込み、AIに読み込ませることで不正な動作を引き起こすといった攻撃が考えられます。
また、音声認識と画像生成を組み合わせ、特定の人物の声で特定の画像について語らせる、より巧妙なディープフェイクの生成も可能になるでしょう。複数のモダリティを横断する攻撃への対策が、今後の重要な課題となります。
AI同士の攻撃と防御の進化
AIは攻撃側と防御側の双方で利用されています。今後さらに自動化が進む可能性がありますが、すべての探索・侵入・対応が人の関与なしで行われると断定することはできません。
検知、分析、対応、復旧の連携を改善し、SOARなどの自動化も必要な範囲で検討します。重大な遮断・削除等には、誤判断の影響を考慮して承認と復旧の手順を用意します。
AIの脆弱性対策ならAX CAMPの研修・コンサルティングへ
AIの脆弱性対策の重要性を理解できても、「具体的に何から手をつければ良いのか分からない」「社内に専門知識を持つ人材がいない」といった課題を抱える企業は少なくありません。AIセキュリティは専門性が高く、常に最新の知識が求められるため、自社だけで万全の体制を築くのは困難です。
そのような課題をお持ちであれば、ぜひ弊社の法人向けAI研修・伴走支援サービス「AX CAMP」にご相談ください。AX CAMPでは、単なるAIの活用方法だけでなく、ビジネスで安全にAIを使いこなすために不可欠なセキュリティや倫理に関する知識も体系的に学べます。貴社の業種や課題に合わせてカリキュラムをカスタマイズし、実務に直結する実践的なスキル習得を支援します。
グラシズ社の2025年9月の原取材では、LPライティングを内製化し、従来1本あたり10万円だった外注費を削減、ライティングの工数を3営業日から2時間へ短縮したと報告されています。AI利用料や社内人件費を含む全費用がゼロになったという意味ではありません。(出典:原取材)
研修や伴走支援で相談できる内容・期間・費用は、公式資料と個別相談で確認してください。専門的な脆弱性診断やセキュリティ運用がすべて標準サービスに含まれると判断しないようにしましょう。

法人向けAI研修
AX CAMP 無料資料
AIの脆弱性とそのセキュリティ対策に関するよくある質問(FAQ)
1. AIの脆弱性とは何ですか?従来のソフトウェアの欠陥とどう違うのですか?
AIシステムには、通常のコードや認証の不備と、モデル・データ・プロンプト等に関わるリスクの双方があります。データ汚染、敵対的サンプル、プロンプトインジェクションなどが代表例ですが、構成に応じて評価します。
2. AIシステムへの具体的な脆弱性対策を3つのステップで教えてください。
①入力情報と参照データ、②連携機能と権限、③監視・対応・復旧の3点から確認します。自社でモデルを学習しない場合も、契約・設定や外部文書の扱いは重要です。敵対的学習は用途別の選択肢で、すべてのAIに必須・有効な万能策ではありません。
3. 2026年現在、注意すべきAIの脆弱性を悪用した攻撃事例はありますか?
はい、2026年現在、AIを悪用した攻撃はすでに現実の脅威となっており、その手口は巧妙化・多様化しています。従来のサイバー攻撃を高度化させるだけでなく、AIサービス特有の機能を悪用した新たな手口も報告されています。
具体的には、主に2つのタイプの攻撃事例が確認されています。
- 詐欺コンテンツ作成の支援:生成AIによる文章・音声・映像の悪用が考えられます。個別企業の内部情報をAIが分析したとする未特定の事例とは分け、送金などは別経路で確認します。
- 共有ページを使ったマルウェア誘導:Push Securityは、AIサービスの共有チャット等を誘導に使うLLMShareを報告しています。正規ドメインにある内容も作成者を確認し、ソフトウェアの導入は公式配布元で行います。モデル自体の脆弱性と同義ではありません。(出典:調査元の説明)
これらの事例は、攻撃者がAIを偵察、攻撃コンテンツ作成、そして実行の各段階で利用していることを示しています。そのため、従来のセキュリティ対策だけでは不十分であり、AIシステム自体の脆弱性も考慮した多層的な防御が不可欠です。
まとめ:AIの脆弱性対策を総括し、セキュアな活用を目指す
本記事では、AIに特有の脆弱性とその深刻なリスク、そして企業が取るべき具体的な対策について網羅的に解説しました。AIはビジネスに革命的な変化をもたらす可能性を秘めていますが、その力を安全に解き放つためには、セキュリティという土台が不可欠です。
最後に、本記事の要点をまとめます。
- AIの脆弱性は、通常のソフトウェアの不備に加え、学習データ、モデル、プロンプト、接続先や権限にも関係します。
- プロンプトインジェクションやデータポイズニングなど、AI特有の攻撃手法があり、情報漏洩や誤った意思決定といった深刻なリスクにつながります。
- 対策は、技術的な防御策だけでなく、全社的なガイドライン策定や従業員教育といった組織的対策と合わせて、三位一体で進めることが重要です。
- NISTのAI RMFやEUのAI法など、国内外でルール整備が進んでおり、これらの動向を常に注視し、自社の体制に反映させる必要があります。
これらの対策を自社だけで推進するには、高度な専門知識と多くのリソースが必要です。もし、AIの脆弱性対策やセキュアなAI活用体制の構築にお悩みであれば、専門家の知見を活用することをお勧めします。AX CAMPでは、貴社の状況に合わせた最適なAIセキュリティ研修やコンサルティングを通じて、安全かつ効果的なAI導入を強力にサポートします。まずは無料の資料請求やオンライン相談で、貴社の課題をお聞かせください。
法人向けAI研修
AX CAMP 無料資料
