「あのマニュアルはどこにある?」「過去のトラブル対応の資料が見つからない」といった、日々の情報探しにストレスを感じていませんか?社内のナレッジが属人化し、共有が進まないのは多くの企業が抱える共通の悩みです。
こうした課題を解消し、必要な情報へアクセスしやすくするのが「AI社内ナレッジ検索」です。本記事では、RAGの仕組みや注意点を踏まえ、安全かつ効果的にAI社内ナレッジ検索を導入するためのポイントを詳しく解説します。
法人向けAI研修
AX CAMP 無料資料
社内情報の検索やナレッジ共有が注目される背景
社内情報の検索やナレッジ共有が注目される背景には、テレワークの普及や業務のデジタル化に伴う情報の散在があります。多くの企業でデータが様々なシステムに分かれて保管されており、必要な情報にたどり着くまでの時間が業務効率を低下させています。
特に近年は、チャットツールやクラウドストレージの利用が進んだことで、情報が「フロー化」しやすい傾向にあります。日々のやり取りの中で重要なノウハウが流れてしまい、後から参照しにくいという課題を抱える企業は少なくありません。
生成AIを検索に組み合わせることで、単なるキーワードの一致だけでなく、質問の文脈や意味の近さを考慮して情報を探すことが可能になっています。これにより、過去の業務データやノウハウを再活用する選択肢が広がっています。
また、限られた人材で生産性を維持・向上させることは、多くの企業にとって重要な課題です。情報探しにかかる時間を減らし、従業員がより付加価値の高い業務に集中できる環境を整えるため、ナレッジの共有と検索性の向上が求められています。

従来の検索システムとAI検索の違い
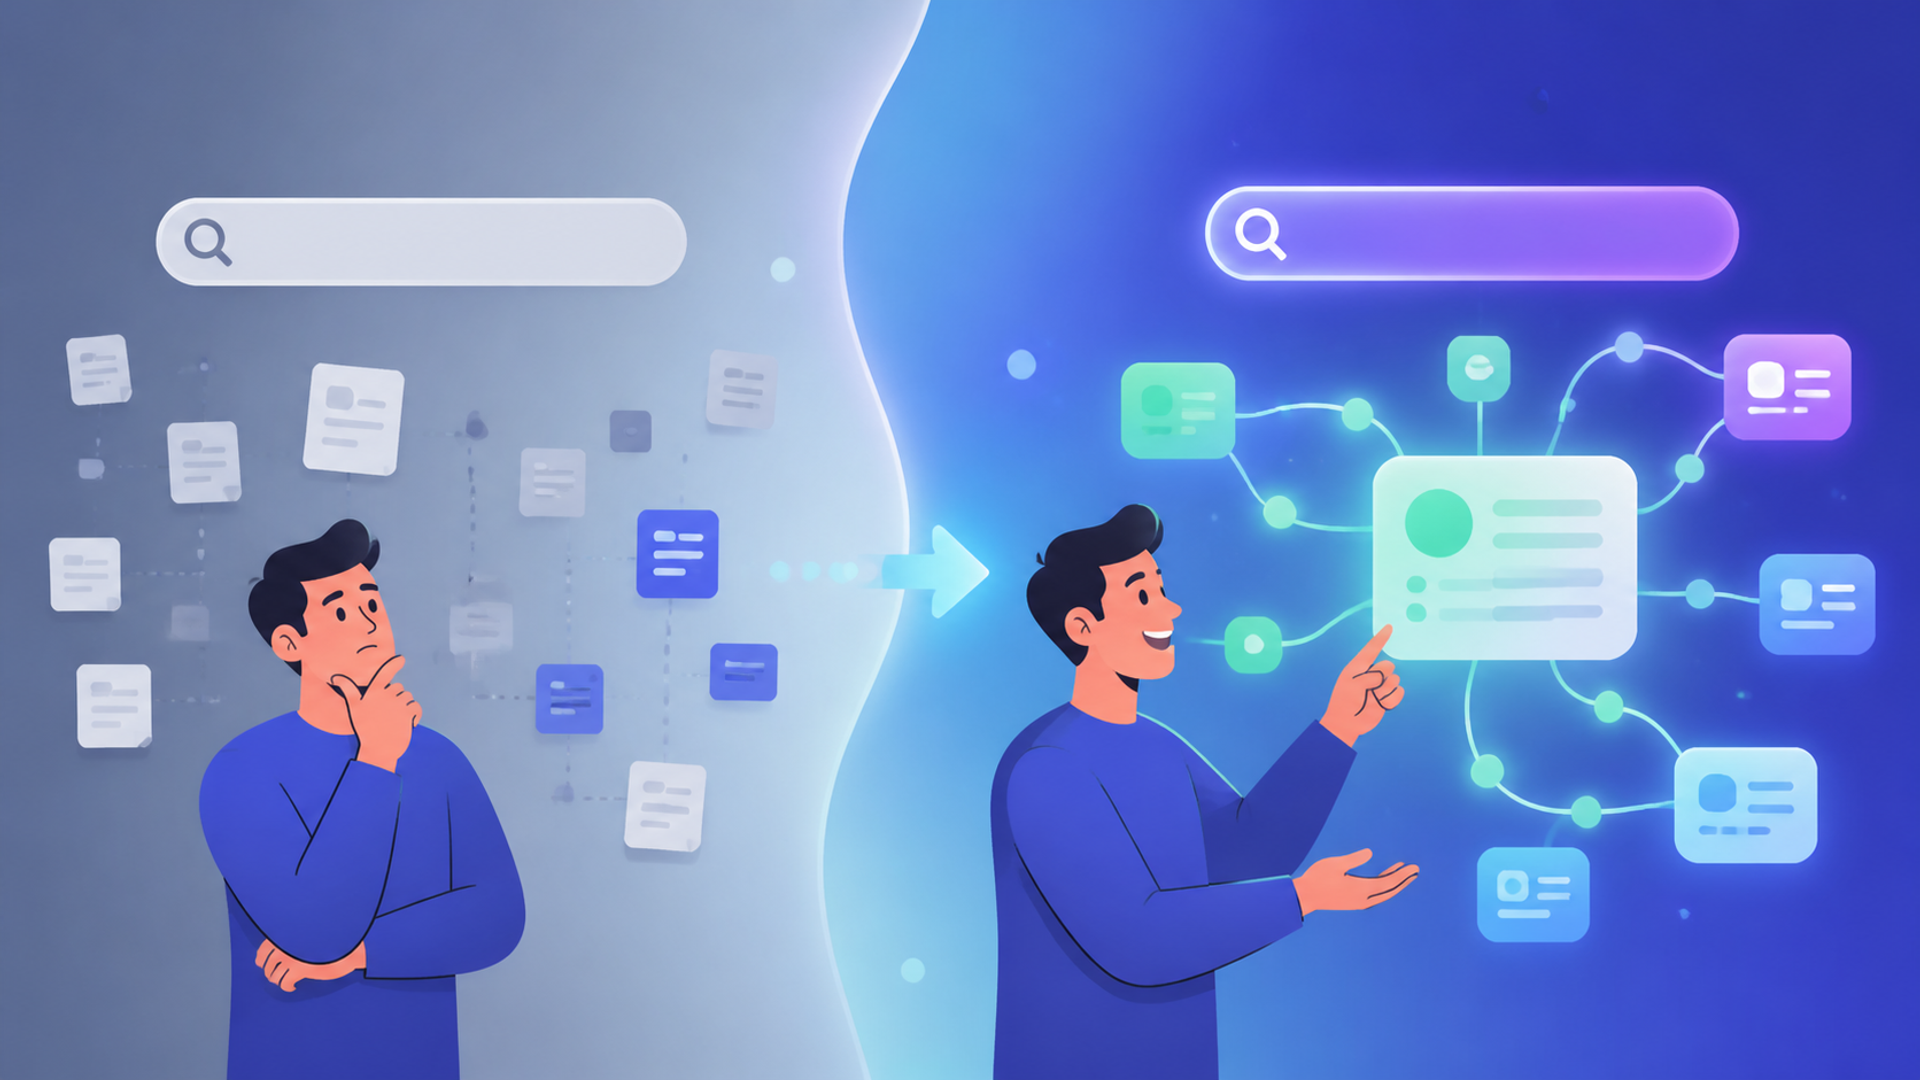
従来の検索システムとAI検索の違いの一つは、言葉の「文脈や意図」を考慮して情報を検索し、回答として整理できるかどうかにあります。従来のシステムが主にキーワードとの一致を基にファイルを抽出するのに対し、AI検索は質問との関連性が高い情報を探し、要約した上で提示する仕組みを備えています。
従来のファイルサーバー検索では、正確なファイル名や特定のキーワードを覚えていなければ、目的の文書にたどり着きにくい場合がありました。また、検索結果として大量のファイルが表示され、その中から必要な箇所を目視で探す手間が発生することもあります。
一方、AI社内ナレッジ検索では、日常会話のような自然な文章で質問を入力するだけで、システムが文脈を解析し、複数のドキュメントから関連情報を探して回答をまとめます。ただし、回答が常に正しいとは限らないため、ユーザー自身が裏付けを取れるよう、参照元(ソース)を明示する設計が欠かせません。
例えば、ユーザーが「お休みをもらう手続き」と検索した際、従来のシステムでは「お休み」という単語が含まれるファイルしかヒットしない場合があります。AI検索であれば、文脈との関連性から「有給休暇申請」や「特別休暇規定」などの文書を検索し、申請手順を整理して提示できる可能性があります。
法人向けAI研修
AX CAMP 無料資料
AI検索の精度を高める「RAG」の仕組み
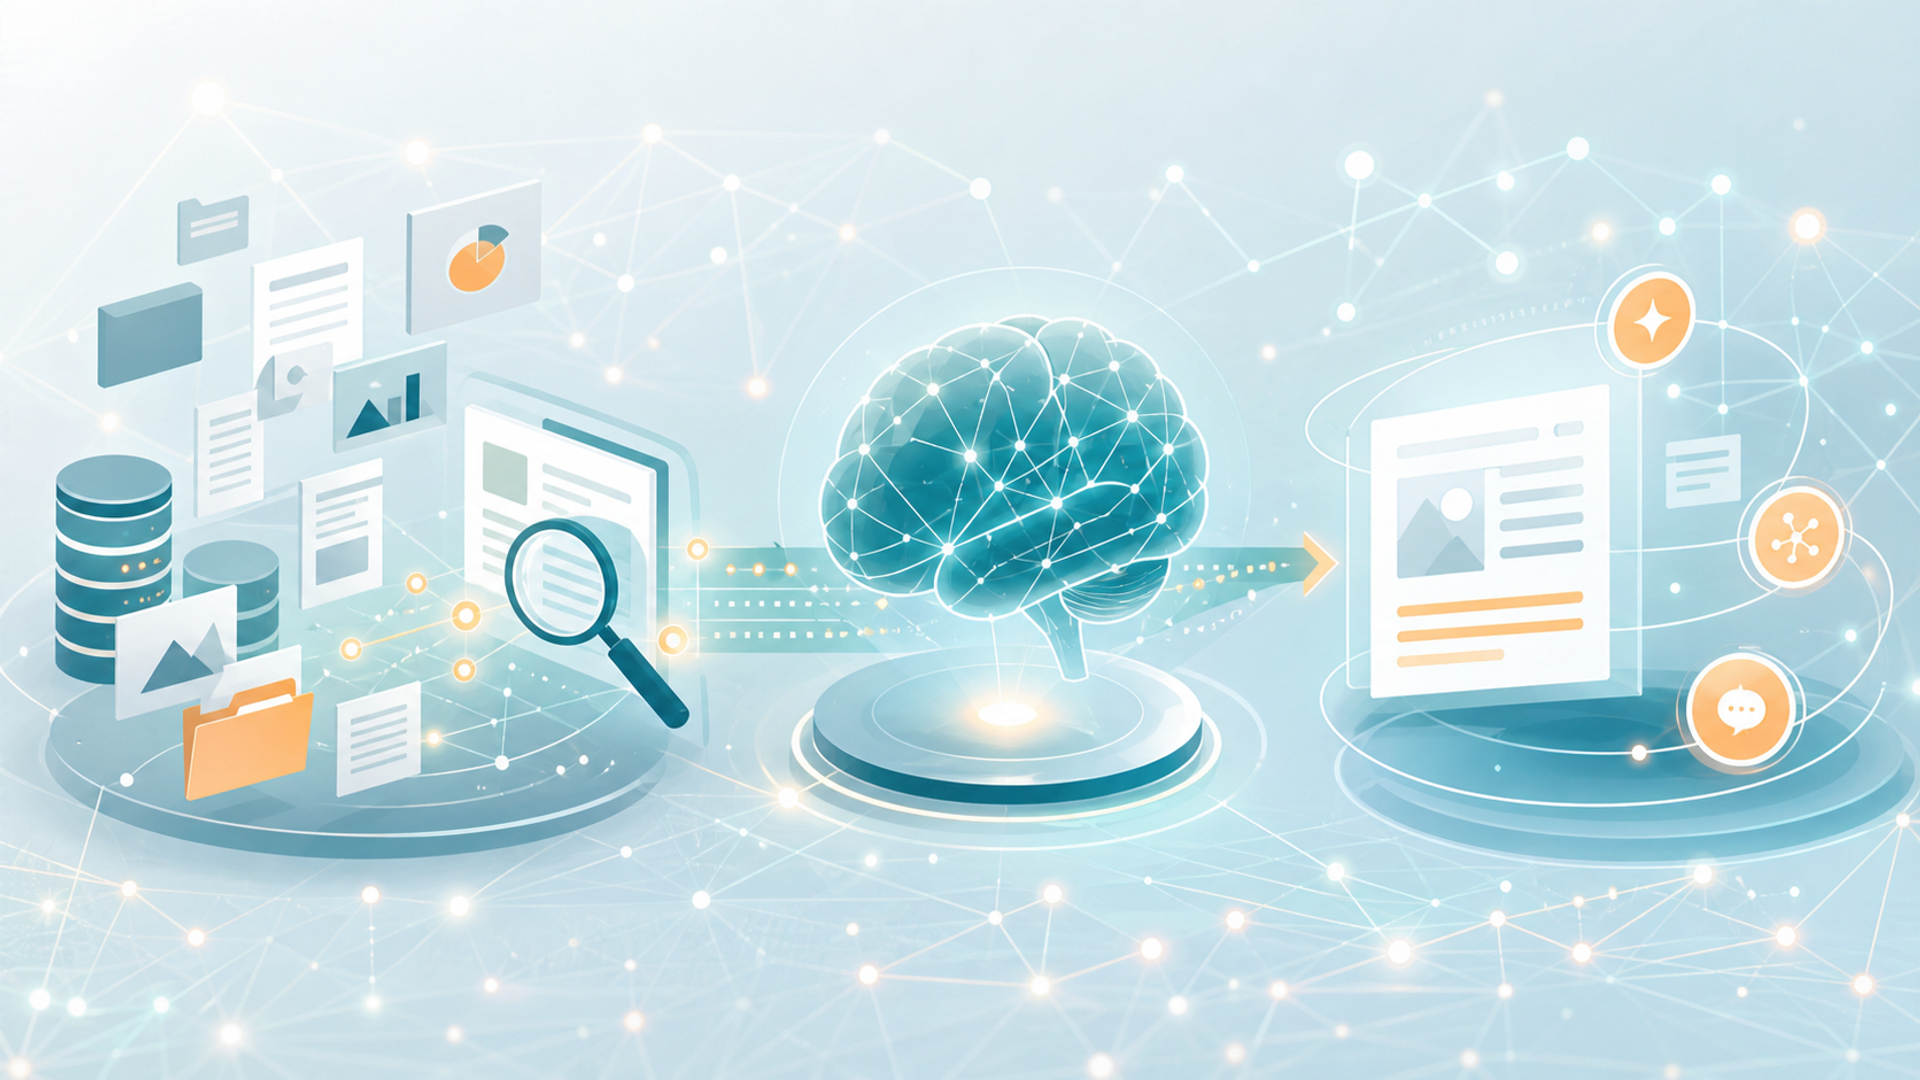
AI社内ナレッジ検索で活用される代表的な技術が、RAG(Retrieval-Augmented Generation:検索拡張生成)です。この仕組みは、生成AIが持つ一般的な知識だけに頼らず、企業が用意したデータベースから関連情報を検索し、その内容を回答生成時の参考情報として与えます。
一般的な生成AIは、学習データに含まれない社内の非公開情報を把握できません。そこでRAG(検索拡張生成)を導入すれば、索引化された社内マニュアルや規定集から質問に関連する情報を自動で取得し、その内容を反映した回答を作成します。ただし、検索漏れや文脈の誤読などは起こり得るため、最終的な正確性を担保する運用ルールも合わせて検討しておきましょう。

企業独自のデータを生成AIにインプットするプロセス
企業独自のデータを検索対象にするためには、まず社内ドキュメントを整理してシステムに登録する前処理が欠かせません。PDFやWord、社内Wikiなどからテキストを抽出し、検索に利用できる「ベクトルデータ」と呼ばれる数値情報へ変換します。
変換されたデータはベクトルデータベースなどに格納されます。この登録作業を定期的に行うことで、常に最新の社内情報を検索対象へと反映させます。ただし、対応可能なデータ形式や抽出精度はシステムごとに異なるため、自社で扱う文書との相性をあらかじめ検証しておくのが確実です。
関連情報を参照して回答を生成する流れ
ユーザーが検索窓に質問を入力すると、システムはまずベクトルデータベースなどを検索し、質問との関連性が高いと判断したドキュメントを抽出します。この段階では、まだ生成AIによる文章の生成は行われていません。検索されたドキュメントの断片が、回答を作るための参考情報になります。
次に、抽出された関連情報とユーザーの質問をセットにして、生成AI(LLM)へ指示(プロンプト)として送ります。生成AIは提示された情報を参照して回答を作成するため、社内情報を与えずに回答させる場合と比べて、根拠に沿った回答を得やすくなります。ただし、無関係な文書の取得、情報の読み違い、モデルが持つ事前知識の混入などは起こり得ます。RAGはハルシネーションを抑えるための手段の一つですが、誤回答を完全に防ぐものではありません。
AIを活用した社内ナレッジ検索を導入する3つのメリット
AIを活用した社内ナレッジ検索を導入すれば、情報探しにかかる時間を大幅に削減し、業務全体の生産性向上を後押しします。さらに、各部署に散らばる属人化したノウハウを見つけやすくし、組織全体で共有・活用する土壌が整います。
具体的なメリットを3つの視点から整理して解説します。それぞれの導入効果を自社の業務課題と照らし合わせながら確認してください。
1. 業務に必要な情報へのアクセス時間を削減
従業員が業務の中で情報や資料を探す時間は、積み重なると大きな負担になります。AI社内ナレッジ検索を導入すれば、社内規定や過去の提案書、技術資料などを横断的に検索し、必要な情報へ短時間でたどり着きやすくなります。
これにより、資料探しに費やしていた時間を本来のコア業務や顧客対応に充てやすくなります。組織全体の業務スピード向上に加え、新入社員や異動してきたばかりのメンバーが、周囲の手を煩わせずに必要な情報を自己解決できる環境が整います。
2. 問い合わせ対応の自動化による業務効率化
総務や人事、情報システムなどのバックオフィス部門には、日々「パスワードの再発行手順は?」「経費精算の期限はいつまで?」といった類似の問い合わせが集中します。これらの一次対応にAI社内ナレッジ検索を活用することで、担当者の負担を軽減できる可能性があります。
質問する側の従業員にとっても、システムが稼働していれば担当者の返信を待たずにその場で情報を得られます。結果として、問い合わせを受けるバックオフィス部門は、個別の判断が必要な相談や社内制度の改善など、より専門性の高い業務へリソースを集中させやすくなります。
3. 属人化していた社内ナレッジの共有と継承
特定のベテラン社員しか知らない業務手順や、過去のトラブル対応の経緯などは、組織内でブラックボックス化しやすい情報です。これらのナレッジをドキュメント化し、RAGの検索対象として索引化することで、必要な従業員が検索・参照できるようになります。一般的なRAGでは、このために生成AIのモデル自体を追加学習させる必要はありません。
退職や異動が発生した際にノウハウが失われるリスクを抑え、新入社員の教育コストを削減する効果も見込めます。組織内で参照できる知識を常に整備しておくことは、サービス品質の安定やトラブル対応の迅速化にも直結します。

導入時に注意すべきセキュリティと運用の課題
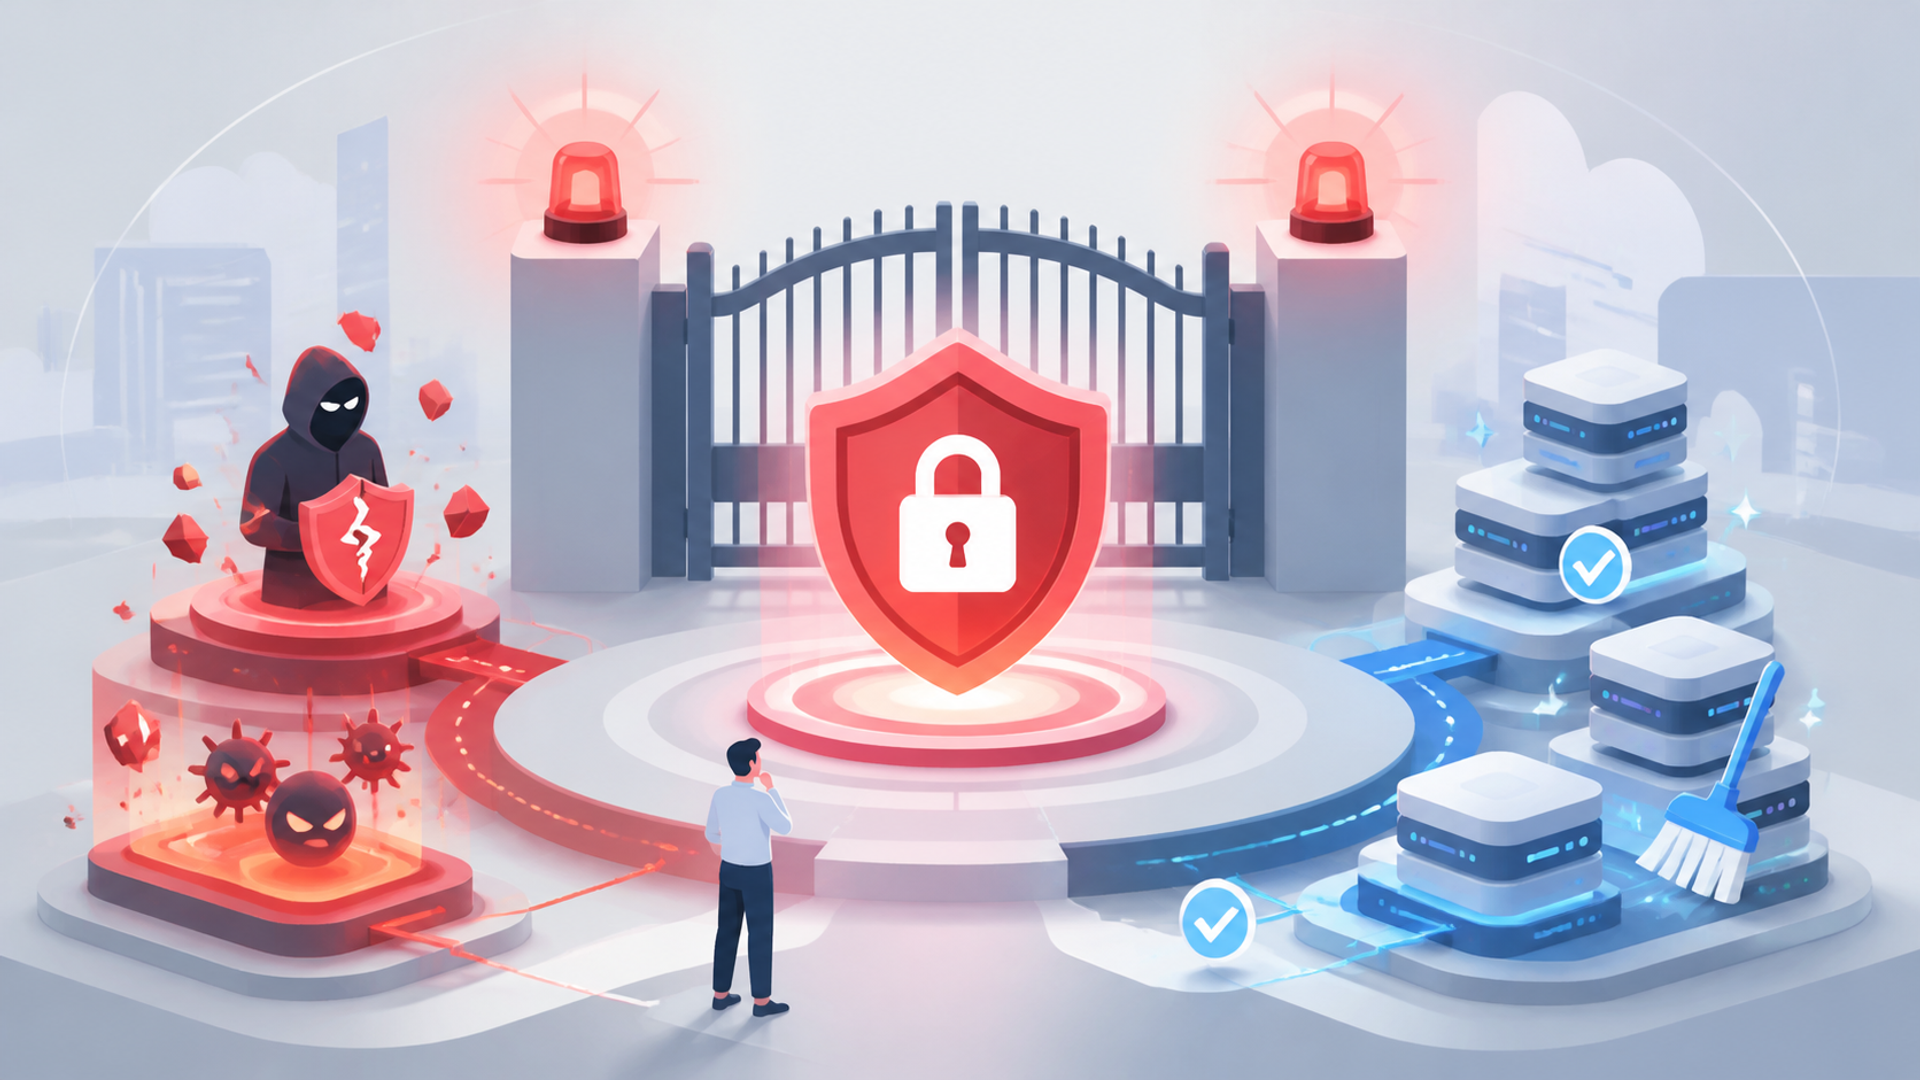
AI社内ナレッジ検索を安全に運用するためには、アクセス制御、生成AIを狙った攻撃への対策、継続的なデータメンテナンスが欠かせません。対策が不十分な場合、機密情報の漏洩や、古い情報・不正な情報に基づく回答の生成につながる恐れがあります。
技術的な利便性だけで判断せず、運用ルールや監査方法を初期段階から設計しておくことが不可欠です。個人情報の扱いは個人情報保護委員会の生成AIサービス利用時の注意喚起、著作権は文化庁のAIと著作権を事前に確認しておきましょう。生成AIに関するリスク全般については、生成AIのリスク管理に関する技術資料(PDF)も参考になります。
機密情報の漏洩を防ぐアクセス権限の管理
社内データには、全社に公開してよい情報だけでなく、役員や特定のプロジェクトメンバーしか閲覧できない機密情報が含まれます。AI社内ナレッジ検索を導入する際は、ユーザーの役職や所属部署に応じて、検索対象文書と回答内容の両方にアクセス権限を細かく設定しなければなりません。
既存の認証基盤やクラウドストレージの権限設定と連携できるかを確認し、権限のないユーザーには機密情報を含む検索結果や回答が表示されないように設計します。また、外部の生成AIモデルへデータを送信する場合は、送信先や保存期間、学習への利用有無、契約上の取り扱いを事前に精査しておきましょう。
間接プロンプトインジェクションやデータ汚染への対策
RAGでは、検索対象の文書内に悪意のある指示が埋め込まれ、生成AIの動作へ影響を与える「間接プロンプトインジェクション」への対策を怠ってはなりません。不正確な文書や改ざんされた文書が登録されると、それらを根拠に誤った回答が生成されるリスクが高まります。
登録元を信頼できるデータに限定し、文書の追加・変更権限を管理するとともに、回答へ参照元を表示して利用者が確認できるようにします。質問、取得文書、回答、権限判定などのログを保存・監査し、不審な挙動を検知した際に即座に利用停止や調査ができる運用体制を整えておきましょう。
回答の精度を維持するための定期的なデータ更新
RAGは検索で取得したデータを回答生成に利用するため、元のドキュメントが古いままだと、改定前の情報を参照した回答が生成される可能性があります。例えば、改定前の就業規則がデータベースに残っている場合、現在とは異なるルールが回答に含まれる原因になります。
定期的に不要なファイルを除外し、最新のドキュメントへ差し替える「データクレンジング」の運用体制を社内で確立しなければなりません。どのドキュメントを誰が管理し、いつ更新するのかというデータガバナンスのルール策定が、長期的な品質維持を左右します。
導入を成功に導く具体的なステップ
AI社内ナレッジ検索の導入を成功させるには、スモールスタートで段階的に適用範囲を広げていくアプローチが有効です。最初から全社規模で完璧なシステムを目指すのではなく、特定の部署や限定されたデータから検証を始めます。ただし、実データをPoC(概念実証)へ投入する前に、対象データの機密区分と最低限のセキュリティ要件を定義しておくことが求められます。
具体的な導入手順は、以下の4つのステップに沿って進めます。
- ステップ1:目的の明確化、対象データの分類、最低限のセキュリティ要件の策定
「どの部署の、どのような問い合わせを減らしたいのか」を明確にし、FAQやマニュアルが整備されている領域を最初の対象に選びます。そのうえで、PoC開始前にデータの機密区分と利用目的を整理し、アクセス制御、外部送信の条件、保存期間、ログの取得・管理方針を定めます。検討時は、経済産業省のAI事業者ガイドライン第1.2版も参照してください。 - ステップ2:PoC環境のセキュリティと権限の設計
ステップ1で定めた要件に基づき、PoC環境の利用者、検索できる文書、生成AIへの送信範囲を制限します。認証・アクセス権限、攻撃への対策、ログ監査、データの削除方法などを実装し、許可されていない情報を投入しない運用手順も整えます。 - ステップ3:PoC(概念実証)の実施
承認されたデータと一部のユーザーに限定して検証し、実際の質問に対してAIがどの程度適切に回答できるか、根拠となる文書を取得できるか、権限が正しく反映されるかを確認します。 - ステップ4:本導入と定着化支援
PoCの結果を踏まえてセキュリティ対策や運用ルールを見直したうえで、全社または対象部署へ展開します。利用方法や回答を確認する際の注意点を共有し、従業員が日常的に活用できるようサポートします。
各ステップでユーザーからのフィードバックを収集し、検索精度や使い勝手を継続的に改善していくことが、最終的な定着につながります。特に、現場のキーマンを巻き込み、日常業務のワークフローに検索システムを自然に組み込む工夫が成功を左右します。

ツール選定における比較ポイント
自社に適したAI社内ナレッジ検索ツールを選ぶ際は、機能面だけでなく、既存システムとの連携性やセキュリティ基準を総合的に評価しなければなりません。自社の予算や運用体制に合致しているかを見極めることが、導入後のミスマッチを防ぐ判断基準となります。
市場には複数のタイプのAI検索ツールが存在するため、以下の比較表を参考に、自社が重視すべき要件を整理してください。
| サービスタイプ | 主な対象 | 特徴 | 確認ポイント |
|---|---|---|---|
| オールインワン型ツール | ナレッジ管理をゼロから始めたい企業 | ドキュメント管理機能とAI検索が一体化している | 既存のファイルサーバーからのデータ移行コスト |
| 検索特化(RAG)エンジン | 既に大量の社内データが蓄積されている企業 | 対応する既存ストレージと連携して横断検索できる | 対応しているファイル形式やAPIの柔軟性 |
| チャットボット連携型 | チャットツールを日常的に活用している企業 | 普段使っているチャット画面からAIへ質問できる | チャットツール側での権限管理との連動性 |
ツールを選定する際は、特に「日本語のゆらぎ(表記のばらつき)をどの程度吸収できるか」や「初期費用と月額運用のコストバランス」を事前にデモや無料トライアルで確認することをおすすめします。また、ベンダーによる導入後のサポート体制が自社の求める水準を満たしているかも見極めたいポイントです。
画像・音声・動画を扱うAI社内ナレッジ検索
テキストだけでなく画像や音声、動画をAI社内ナレッジ検索の対象にしたい場合は、それらを解析して関連情報を取得する「マルチモーダルRAG」が選択肢になります。実現できる範囲や精度は製品、データ形式、解析方法によって異なるため、自社の実際のデータを用いた事前の検証が欠かせません。
従来の検索システムでは、主にテキストファイルやPDF内の文字情報が検索対象でした。画像内の文字や図表、動画内の音声なども解析対象にできれば、これまで検索しにくかった情報を活用できる可能性があります。
例えば、機器のメンテナンスマニュアルに掲載された配線図や、作業手順を記録した動画を検索対象にし、関連する説明や動画内の該当箇所を提示する活用方法が考えられます。ただし、図の読み違いや音声認識の誤りも起こり得るため、業務利用では人による確認が欠かせません。
また、AIを使って関連情報の整理や、更新が必要な文書の候補抽出を支援する方法も考えられます。自動処理の結果をそのまま確定情報にせず、管理者が確認・承認する工程を設けることで、誤った情報が検索対象へ混入するリスクを抑えられます。
生成AIを活用したナレッジマネジメントの今後
生成AIを活用したナレッジマネジメントは、情報の検索に加えて、蓄積されたデータの整理や業務上の検討を支援する方向へ発展する可能性があります。ただし、どこまで自動化できるかはデータ品質やシステム設計、業務上許容できるリスクによって異なります。
メールやチャット、ドキュメントの作成履歴から重要な情報の候補を抽出し、分類や要約を支援する仕組みも考えられます。一方で、個人情報や機密情報の取り扱い、誤った分類、必要な文脈の欠落といった課題があるため、人による最終確認や適切な権限管理の徹底が求められます。
ユーザーが検索する前に、現在の作業内容に関連する提案書やトラブル事例を提示する「能動的なナレッジ提案」も活用方法の一つです。こうした機能が業務に適切に組み込まれれば、情報を探したり整理したりする負担を減らし、従業員が判断や顧客対応などの業務に時間を使いやすくなると期待できます。
AX CAMPなら現場成果から逆算したAI活用の設計と人材育成を支援
株式会社AXが提供する法人向けAI研修サービス「AX CAMP」では、単にAIの知識を学ぶだけでなく、現場での活用を目指す実践的なカリキュラムを提供しています。自社の業務課題を分解し、AI社内ナレッジ検索を含むAI活用の目的や進め方を整理したうえで、実務への落とし込みを伴走支援します。
AX CAMPは、完全オンラインで受講可能な14時間のeラーニングと、個別のAI化計画プランニング、そして半年〜年間の伴走支援を組み合わせた研修設計が特徴です。受講中に作成したAIツールを実際の業務で活用できる状態を目指し、研修内容の定着を支援します。
実際の導入事例として、D2C事業を展開する株式会社JIMOS様では、役員・管理職から3段階で全社展開し、AI活用の土台づくりを推進されています(参考:株式会社JIMOS導入事例)。AX CAMPでは、技術の習得にとどまらず、AI化計画の策定や業務課題の整理、研修中のAIツール作成を通じて、組織への定着と実務活用を支援します。AI社内ナレッジ検索を活用できる人材の育成や導入計画の整理を進めたい企業様は、ぜひお気軽にお問い合わせください。

法人向けAI研修
AX CAMP 無料資料
まとめ:AIによる社内ナレッジ検索を導入して業務効率化を実現しよう
AIによる社内ナレッジ検索は、社内に蓄積されたデータを見つけやすくし、業務効率化やナレッジ継承を支援する手段です。導入にあたっては、RAGの仕組みと限界を理解し、アクセス制御、攻撃への対策、ログ監査、データメンテナンスを含む運用体制を整えることが重要です。
まずは目的と対象データを明確にし、データ分類、アクセス制御、外部送信、保存期間、ログに関する最低限の要件を定めたうえで、小さな範囲からPoCを行いましょう。PoCでは回答の正確さだけでなく、適切な根拠文書を取得できるか、権限を正しく反映できるかも検証します。
検証結果と利用者のフィードバックを基に改善を重ね、段階的に適用範囲を広げていくことが定着につながります。
導入計画の策定や人材育成に不安がある場合は、専門的な知見を持つパートナーへの相談も検討してください。
法人向けAI研修
AX CAMP 無料資料
