
「AIに業務マニュアルの要約を頼んだら、存在しない機能が追記されていた」
「最新の市場データを質問したら、もっともらしい嘘の数値を回答された」——。
生成AIの活用が広がる一方で、このようなAIが生成する「嘘」に戸惑うビジネスパーソンが増えています。この現象は「ハルシネーション」と呼ばれ、業務利用における重大なリスクとして認識され始めています。
この記事では、AIがなぜ嘘をつくのか、その根本的な原因から、具体的なビジネスリスク、そして今日から実践できる対策までを網羅的に解説します。最後まで読めば、AIの出力に潜む危険性を理解し、安全かつ効果的にAIを業務活用するための知識が身につきます。
生成AIを業務で活用するための実践力を身につけたい方は、当社の法人向けAI研修・伴走支援「AXCAMP」の資料もご参照ください。業務ヒアリングをもとに、企業ごとの課題に合わせたAI化プランをご提案します。
法人向けAI研修
AX CAMP 無料資料
AIが嘘をつく「ハルシネーション」とは?

AIが嘘をつく現象は「ハルシネーション(Hallucination)」と呼ばれます。これは、生成AIが事実に基づかない情報や文脈に合わない内容を、あたかも真実であるかのように生成する現象を指します。人間における「幻覚」に例えられて、この名前が付けられました。
ハルシネーションの発生確率は、利用するAIモデルや実行させるタスクの種類によって大きく異なります。そのため、公表されている数値を解釈する際には、どのような条件下で測定されたかを理解することが重要です。例えば、特定の文書を要約させるタスクと、一般的な知識を問う質問応答タスクとでは、評価の難易度や性質が全く異なります。
VectaraのHallucination Leaderboardは、一般的な質問応答の正答率ではなく、与えられた文書を要約した際に、元文書に支持されない内容が含まれる割合を測るベンチマークです。データセットや評価モデルの更新によって数値は変わるため、比較する際は測定時点とベンチマークの版を確認する必要があります。
OpenAIはGPT-5.6 Solを2026年6月26日に限定プレビューし、GPT-5.6を7月9日に一般提供しました。OpenAIの評価では、GPT-5.6 SolはGPT-5.5より事実誤りがわずかに少ない一方、誤り自体は残るとされています。評価結果はタスクや利用条件によって異なるため、最新モデルでも出典確認が必要です。
ハルシネーションの基本的な定義
ハルシネーションとは、生成AIが学習データに含まれていない、あるいは事実と異なる情報を自信を持って出力してしまう現象です。例えば、AIに特定の法律について質問した際に、存在しない条文をもっともらしく引用したり、歴史上の出来事について尋ねた際に、架空のエピソードを創作したりするケースがこれに該当します。AIは確率に基づいて次に来る単語を予測しているため、「わからない」と答える代わりに、それらしい言葉を繋ぎ合わせてしまうのです。
AIの「嘘」と人間の「嘘」の根本的な違い
AIの「嘘」と人間がつく「嘘」には、決定的な違いがあります。それは「意図」の有無です。人間が嘘をつく場合、そこには相手を騙そう、自分を良く見せようといった何らかの意図が存在します。一方で、AIのハルシネーションには意図がありません。AIは倫理観や悪意を持っているわけではなく、あくまで学習したデータに基づいて、統計的に最もそれらしい単語の連なりを生成しているに過ぎません。その結果が、偶然事実と異なってしまったものがハルシネーションなのです。
生成AIにおけるハルシネーションの発生確率
ハルシネーションの発生確率は、使用するAIモデルやタスクの内容によって大きく異なります。AI技術企業のVectara社は、主要な大規模言語モデル(LLM)が要約タスクを行う際のハルシネーションレート(誤情報や非現実的な情報を生成する頻度)を比較し、リーダーボードで公開しています。
2026年8月16日に確認したVectaraの文書要約ベンチマークでは、Gemini 2.5 Flash-Liteは3.3%、GPT-4.1は5.6%、Gemini 2.5 Flashは7.8%でした。ただし、これは7,700件超の文書を要約した際の事実的一貫性をHHEM-2.3で評価した結果であり、一般的な質問応答すべてに同じ割合を当てはめることはできません。(出典:Vectara Hallucination Leaderboardの現行表・評価方法)
どのモデルも、すべての用途で正確さが保証されるわけではありません。公開ベンチマークの数値をそのまま自社業務へ当てはめず、実際の入力・出力条件で評価し、重要な事実は一次情報と照合する必要があります。
なぜAIはもっともらしい嘘をつくのか?その仕組みと原因

AIがもっともらしい嘘、すなわちハルシネーションを生成する背景には、その技術的な仕組みに起因する複数の原因が存在します。AIは人間のように事実を「理解」しているわけではなく、膨大なデータから学習したパターンを再現しているに過ぎません。この根本的な特性が、ハルシネーションを引き起こす土壌となっています。
学習データの不足・偏り・古さ
AIの回答品質は、学習データの量と質に大きく依存します。データが特定の分野に偏っていたり、情報が古かったりすると、それがそのまま出力に反映されてしまいます。例えば、2023年までの情報しか学習していないAIに最新の法改正について尋ねても、古い情報に基づいた回答しかできません。また、インターネット上の不正確な情報や偏った意見を学習してしまえば、それを事実として生成してしまうリスクもあります。
文脈の誤解釈とパターンの過剰な一般化
AIは、ユーザーが入力したプロンプト(指示)の文脈を完全に理解できるわけではありません。複雑な背景や微妙なニュアンスを汲み取れず、単語の表面的な繋がりだけで回答を生成してしまうことがあります。その結果、文脈にそぐわない情報や、一見正しそうに見えて論理が破綻している回答が生まれます。また、学習データ内の特定のパターンを過剰に一般化し、あらゆる状況に当てはめてしまうことも、ハルシネーションの一因です。
モデルの構造的な限界(事実確認機能の欠如)
多くの大規模言語モデルは、単独では事実検証を目的とした内部的な知識の最新化や、厳密なファクトチェック機能を持ちません。AIの主な目的は「次に来る確率が最も高い単語」を予測し、自然な文章を生成することにあります。そのため、生成している内容が真実か虚偽かを自ら判断する能力はなく、誤った情報でも文章として自然であれば出力を続けてしまいます。実運用では、RAG(検索拡張生成)や検索連携、専用の検証モジュールを組み合わせて事実確認を行うアーキテクチャが一般的になっています。
プロンプト(指示)の曖昧さや複雑さ
ユーザーがAIに与える指示、すなわちプロンプトが曖昧であることも、ハルシネーションを引き起こす大きな要因です。例えば、「日本の首都について教えて」という単純な質問であれば正確に答えることができても、「今後の経済政策が中小企業に与える影響について、考えられるシナリオをいくつか挙げてください」といった複雑で多角的な回答が求められる指示では、AIが推測で情報を補完しようとするため、誤りが含まれる可能性が高まります。
【実例】ビジネスに影響を与えたAIの嘘(ハルシネーション)の事例

ハルシネーションは、もはや理論上のリスクではありません。世界中のビジネスや専門分野で、実際に問題となった事例が多数報告されています。これらの事例は、AIの出力を鵜呑みにすることの危険性を具体的に示しています。
事例1:存在しない論文や判例の捏造
2023年のMata v. Aviancaでは、ChatGPTが生成した6件の架空の裁判例を含む文書が裁判所に提出されました。裁判所は、弁護士らが判例を確認せず提出しただけでなく、裁判所から存在を疑われた後も架空の意見を支持し、虚偽・誤解を招く説明を続けたとして、弁護士2名と法律事務所に連帯で5,000ドルの制裁金を科しました。(出典:Mata v. Avianca 制裁命令)
事例2:もっともらしい固有名詞や日付の創作
生成AIは、実在しそうな書名、人物名、日付などを組み合わせて誤った回答を作ることがあります。OpenAIも、存在しない博士論文名や誤った生年月日を回答する例を示し、モデルが不確実性を認めるより推測を選びやすい評価方法を課題として挙げています。固有名詞や日付は、検索結果の見出しだけでなく原資料まで確認する必要があります。(出典:Why language models hallucinate)
隣接事例:顧客向けチャットボットの誤案内
2024年のMoffatt v. Air Canadaでは、同社サイトのチャットボットが、搭乗後でも発券日から90日以内なら忌引運賃を遡って申請できると誤案内しました。忌引運賃自体は存在しましたが、実際の規定では搭乗後の遡及申請は認められていませんでした。審判所はAir Canadaの過失による不実表示を認定しました。ただし、判断文はこのチャットボットの基盤技術を生成AI・LLMとは特定していません。そのため、これは生成AIのハルシネーションが立証された事例ではなく、自動応答を検証せず顧客へ提示することの隣接リスクとして位置づけられます。(出典:Moffatt v. Air Canada, 2024 BCCRT 149)
AIの嘘が引き起こす具体的なリスクと危険性

AIが生成する嘘、ハルシネーションは、単なる「間違い」では済みません。特にビジネスの現場においては、企業の信頼性や財務に直接的な打撃を与える深刻なリスクとなり得ます。その危険性を正しく認識し、対策を講じることが不可欠です。
誤った意思決定による経済的損失
ハルシネーションによって生成された誤った市場分析や財務データを基に経営判断を下した場合、深刻な経済的損失につながる可能性があります。例えば、AIが生成した架空の需要予測を信じて過剰な在庫を抱えてしまったり、不正確な競合分析に基づいてマーケティング戦略を誤ったりするケースが考えられます。AIの回答を検証せずに重要な意思決定に利用することは、大きなビジネスリスクを伴います。
偽情報の拡散と社会的信用の失墜
企業がAIを用いて生成したコンテンツ(ブログ記事、SNS投稿、プレスリリースなど)にハルシネーションが含まれていた場合、偽情報を社会に拡散してしまうことになります。一度誤った情報が広まると、それを訂正することは容易ではありません。企業の公式サイトや公式アカウントから発信された情報は、たとえAIが生成したものであっても、その企業の公式見解と見なされます。結果として、企業のブランドイメージが傷つき、顧客や取引先からの信頼を失うことにつながります。
法務・コンプライアンス上の問題
AIの生成物は、著作権、名誉・信用、個人情報などをめぐる法的問題につながる可能性があります。AI自体ではなく、その開発・提供・利用に関わる主体が法的責任を問われる可能性がありますが、責任が常に利用企業や個人だけに帰属するわけではありません。経済産業省の手引きでは、AIが判断を補助するものか、人の判断を代替するものか、各当事者が必要な検証・説明・安全設計を行っていたかなど、個別の事情に応じて判断すると整理されています。実務上の管理策はAIの内部統制とリスク対策でも解説しています。

AIの嘘を見抜くための実践的な方法5選

AIのハルシネーション(もっともらしい嘘)は完全にはなくせないため、利用者が「嘘を見抜くスキル」を持つことが重要です。AIの回答を鵜呑みにせず、常に批判的な視点を持つことで多くのリスクは回避できます。AIの嘘を見抜くには、複数の検証手法を組み合わせることが有効です。
- 一次情報によるファクトチェック
数値、固有名詞、日付は、官公庁、企業の公式発表、原著論文などで裏付けを取ります。 - 複数モデルで相違点を探す
複数モデルの比較は、食い違いや追加確認箇所を見つける補助になります。ただし、回答が一致しても事実とは限りません。 - 出典を開いて内容を確認する
出典URLを求めるだけでは不十分です。架空のURLや、主張を裏付けないページが示される場合があるため、リンク先を開き、該当箇所を確認します。 - 自己申告の確信度を過信しない
AIの確信度と実際の正確性は一致しない場合があります。検証候補の洗い出しには使えても、信頼性の証明にはなりません。 - 影響度に応じた人間のレビュー
医療、法律、金融、契約、対外公表など、誤りの影響が大きい用途では、必要な専門知識を持つ人が確認します。
1. ファクトチェックと一次情報源の確認を徹底する
最も基本的かつ重要な対策は、ファクトチェックの徹底です。AIが提示した数値、固有名詞、日付、専門用語など、検証可能な情報については、必ず信頼できる情報源で裏付けを取りましょう。特に、官公庁のウェブサイト、公的な統計データ、企業の公式発表、査読付きの学術論文など、信頼性の高い「一次情報」にあたる習慣をつけることが重要です。AIの回答はあくまで「仮説」や「下書き」と捉え、最終的な正しさを保証するのは人間の役割だと認識する必要があります。
2. 複数の異なるAIモデルでクロスチェックする
一つのAIモデルの回答を信じ込まず、複数の異なるAIモデルの回答を比較すると、食い違いや追加確認が必要な箇所を見つけやすくなります。ただし、複数モデルが同じ誤情報や同じ検索結果に依存する可能性もあります。回答が一致しても一次情報による確認は省略できません。
3. 具体的な出典や根拠を明示させるプロンプトを使う
AIに根拠となる情報源を示すよう求めると、検証しやすい形式で回答を得られます。ただし、AIは実在しない出典や、主張を裏付けていないURLを提示することがあります。URLが表示されたこと自体を根拠にせず、リンクを開いて発行主体、公開日、該当箇所を確認してください。具体的な指示の組み立て方はLLMプロンプトの作り方でも解説しています。

4. 回答の「確信度」を自己評価させる
AIに確信度や推測箇所を尋ねる方法は、検証候補を洗い出す補助として使える場合があります。ただし、自己申告した確信度と実際の正確性が一致するとは限りません。数値を信頼性の証明として扱わず、一次情報による確認と組み合わせてください。
5. 用途のリスクに応じて人がレビューする
AIの出力をそのまま業務へ利用せず、用途と影響度に応じた検証・承認工程を設けることが重要です。特に、対外公表、契約、医療、法律、金融などでは、必要な専門知識を持つ人が内容を精査します。
総務省と経済産業省の「AI事業者ガイドライン(第1.2版)」は、AIへの過度な依存や自動化バイアスに注意し、リスクに応じて人間の判断を介在させるか検討するよう求めています。人間が最終判断することが適切な場面では、判断項目を事前に明確化し、利用者が出力を適切に評価できる知識や体制を整えることが重要です。
例えば、AIが生成した契約書の草案をそのまま利用するのではなく、法務担当者がリーガルチェックを行うべきです。また、AIが提案したマーケティング戦略も、市場データや自社の状況と照らし合わせて人間が妥当性を判断する必要があります。AIの回答を過度に信頼し、確認を怠る「自動化バイアス」に陥らないよう注意が求められます。
AIを便利な「壁打ち相手」や「思考の整理ツール」として活用しつつも、最後の砦は自分自身の知識と判断力です。この原則を徹底することが、AIの嘘からビジネスを守る最大の防御策となります。
(出典:AI事業者ガイドライン(第1.2版))
AIの嘘を防ぐプロンプトエンジニアリング入門
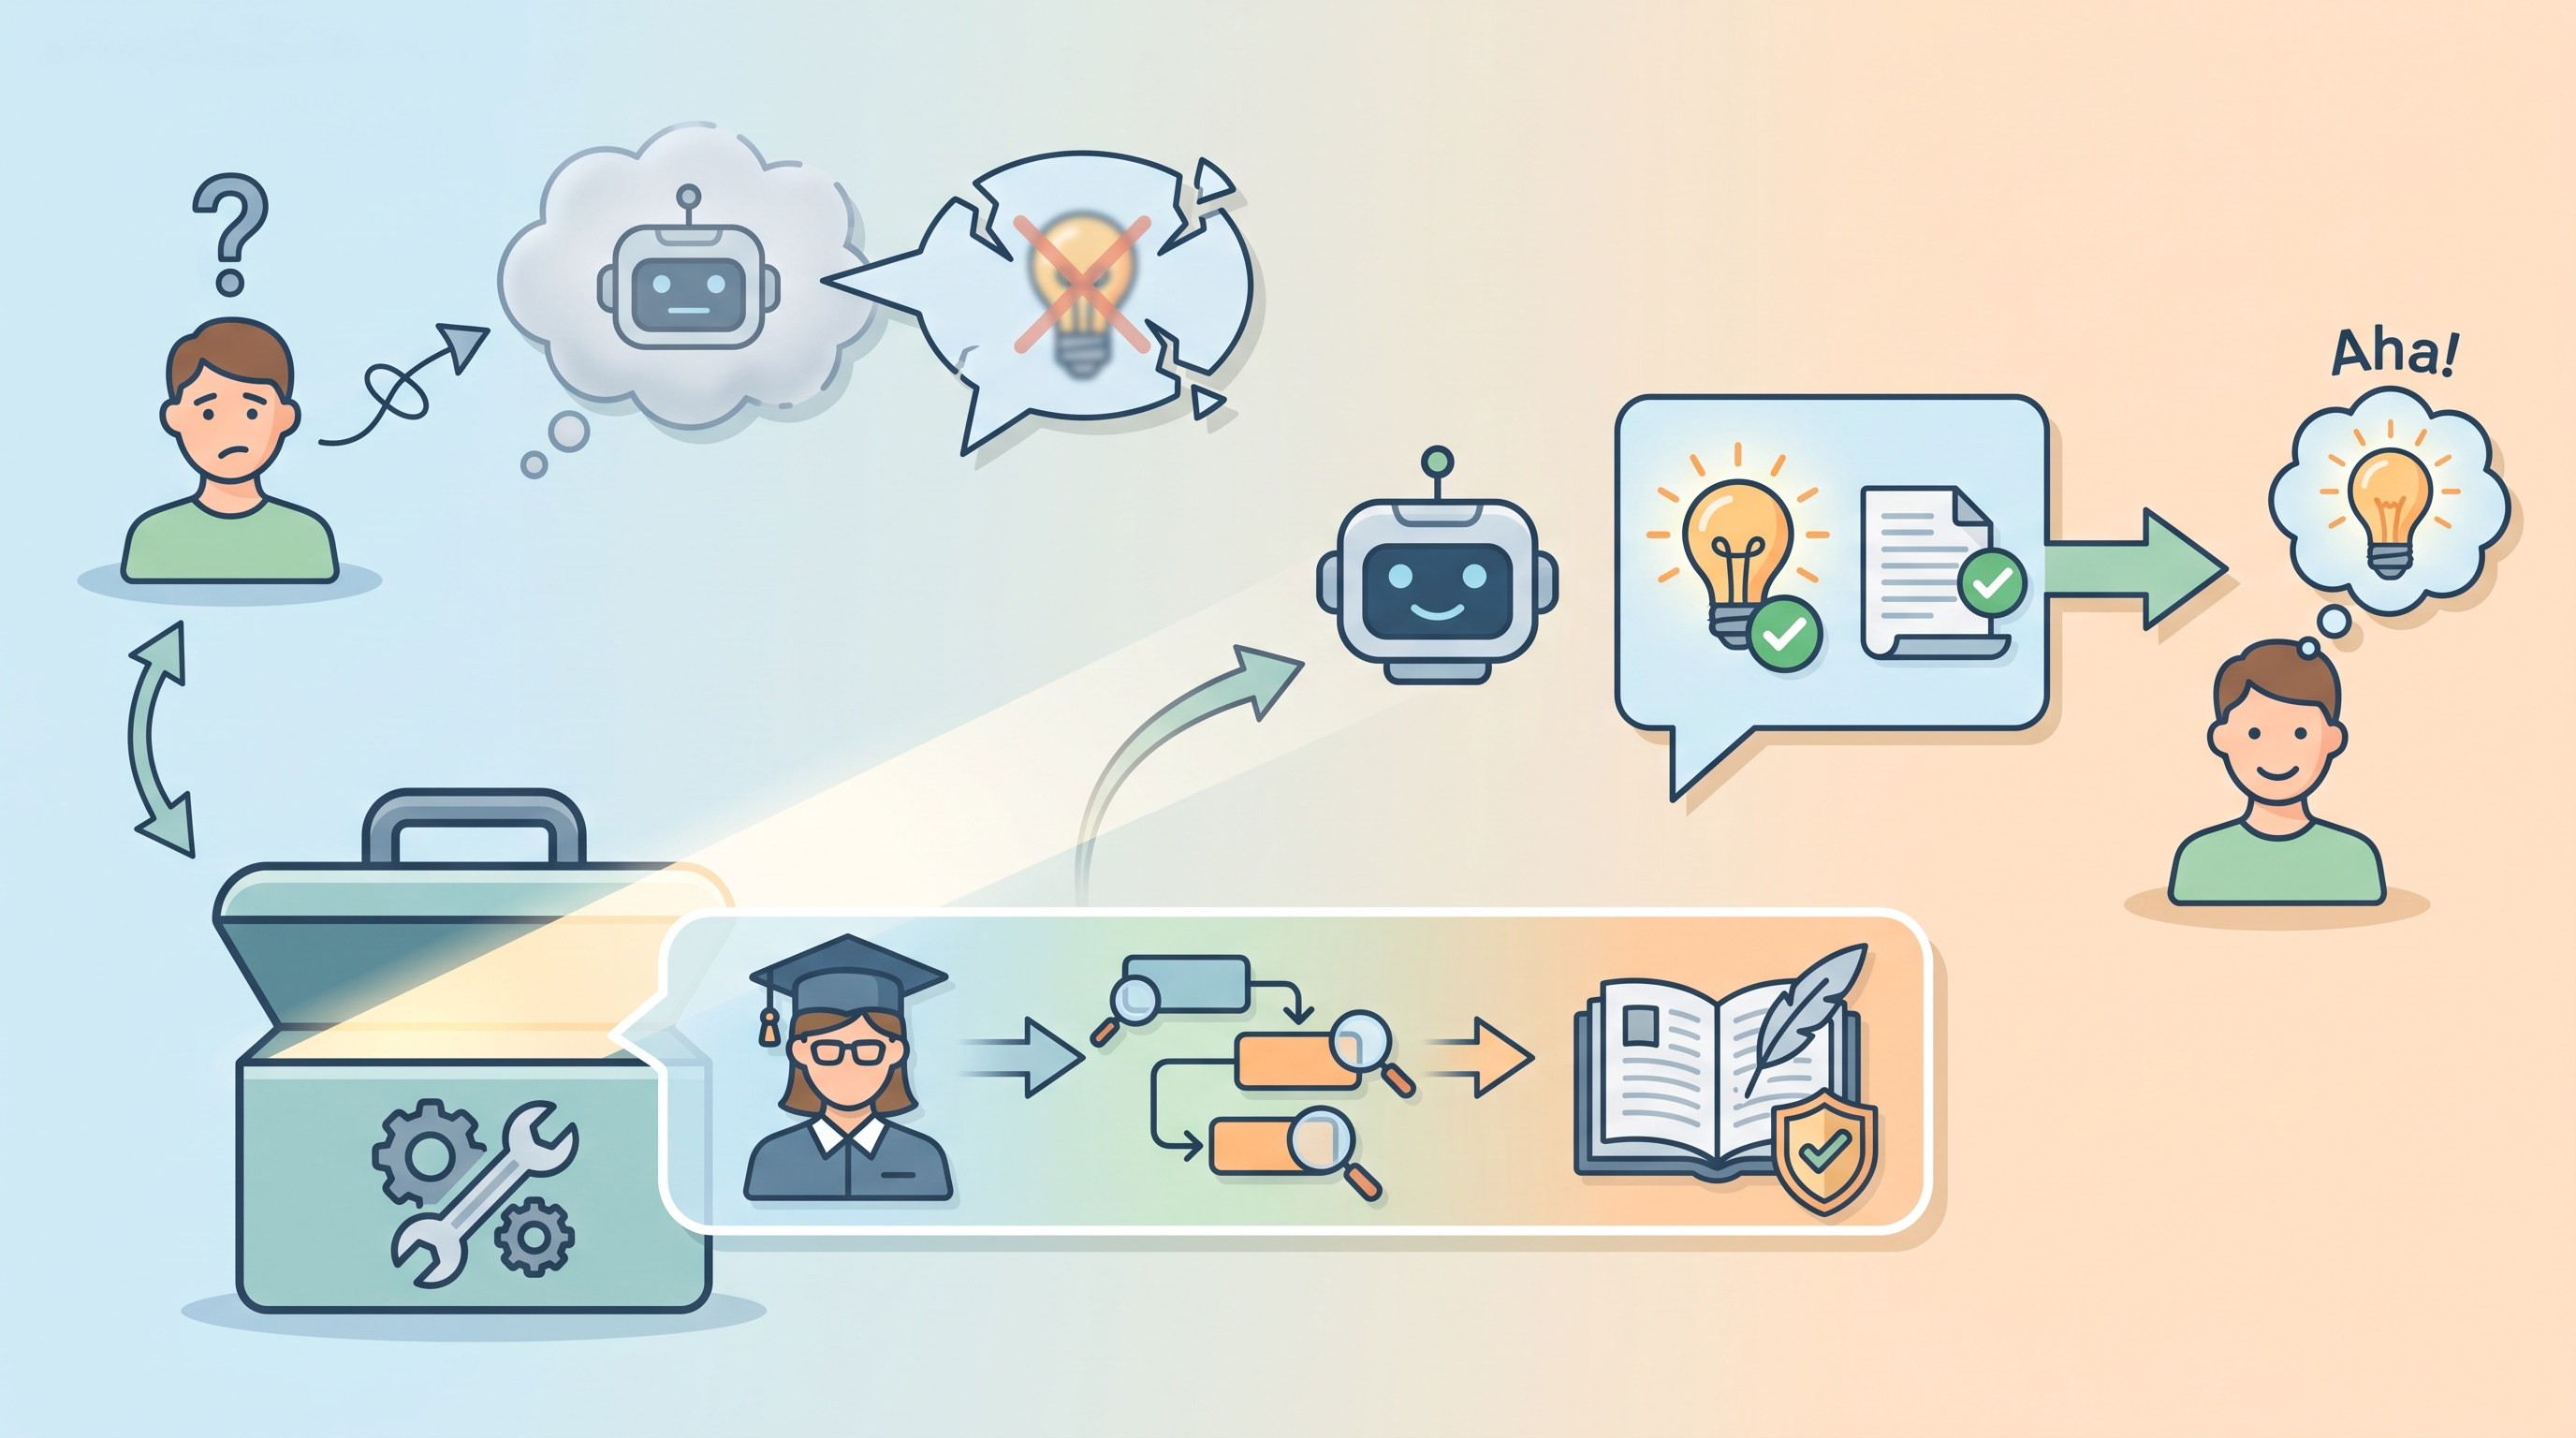
プロンプトで回答条件、対象範囲、必要な根拠を明確にすると、曖昧な推測を減らし、検証しやすい出力を得やすくなります。ただし、プロンプトだけでハルシネーションを防止できるわけではありません。
次のように、事実・推測・不明点を分け、根拠を確認できる形で出力させると、利用者が検証しやすくなります。
- 前提と対象範囲を指定する:対象期間、地域、利用可能な資料、判断基準を明示します。
- 既知・推測・不明を分ける:確認できた事実と推論を分け、不明な点は「不明」と記載させます。
- 根拠を示させ、リンク先を確認する:出典名、公開日、URL、該当箇所を求めます。ただし、提示された出典は必ず利用者が開いて確認します。
これらは検証しやすい出力を得るための工夫です。事実性を保証するものではないため、重要な主張は一次情報で照合し、必要に応じて検索連携やRAG、レビュー工程を組み合わせます。
ハルシネーションを抑制・防止するための最新技術

ハルシネーションは生成AIにおける根深い課題であり、その対策技術の研究開発が世界中で進められています。モデル自体の性能向上に加え、AIの外部に新たな仕組みを組み合わせることで、回答の正確性を高めようとするアプローチが主流となっています。ここでは、特に注目されている3つの技術を紹介します。
RAG(検索拡張生成)による外部知識の参照
RAG(Retrieval-Augmented Generation:検索拡張生成)は、回答時に外部情報を検索して根拠として利用する仕組みです。モデル内部の知識だけに頼る場合と比べ、情報の更新や出典確認を行いやすくなります。仕組みや導入手順はRAG開発の仕組みと実践手順で詳しく解説しています。

人間が何かを答える前に「まず調べてから話す」のと同じプロセスをAIに実行させます。これにより、モデル内部の知識の古さや偏りを補い、事実に基づいた正確な回答を生成する精度を高めます。例えば、最新の製品情報を反映した回答や、社内規定に基づいた応答が可能になります。
ただし、RAGは万能ではありません。回答品質は、参照情報の正確性だけでなく、検索対象の整備、関連文書の取得精度、指示の設計、生成モデルの解釈にも左右されます。古い文書や誤情報、関連性の低い検索結果を参照すれば、誤った回答につながる可能性があります。
また、検索システムが質問と関連性の低い情報を取得したり、情報の照合に失敗したりするケースも起こり得ます。そのため、RAGを導入する際は、参照させる情報源の品質を厳しく管理することが不可欠です。信頼できる情報源のみに限定したり、検索結果をフィルタリングしたりする仕組みを組み合わせることで、リスクを低減できます。
ファインチューニングによる専門知識の強化
ファインチューニングは、特定の出力形式、文体、分類方法、業務手順などをモデルへ学習させ、振る舞いを安定させる用途に適しています。一方、最新情報を正確に保存・検索するデータベースの代わりにはならず、事実性の向上を一律に保証するものでもありません。更新される知識を扱う場合は、RAGや検索連携、評価用データセット、レビュー工程を組み合わせます。
出力の正確性を評価するガードレール機能
ガードレールは、出力形式の制約、禁止表現や個人情報の検知、外部公開前の警告などを行う仕組みです。用途に応じてリスクのある出力を止めたり、確認工程へ回したりできます。ただし、一般的なガードレールだけで個々の事実が正しいかを保証することはできません。一次情報との照合や人によるレビューを別に設計する必要があります。
主要な生成AIモデルごとのハルシネーション傾向

モデルごとの事実性は、質問応答、要約、検索利用、専門分野などの条件で変わります。モデル名だけで信頼性を決めず、自社の利用条件に合わせて評価することが重要です。
- OpenAI GPTシリーズ:GPT-5.6 Solは、Web検索、ファイル検索、コンピュータ操作、ツール検索などに対応しています。OpenAIの評価ではGPT-5.5より事実誤りがわずかに少ない一方、誤りは残るとされています。
- Google Geminiシリーズ:対応モデルではGoogle検索によるGroundingを有効にすると、リアルタイムのWeb情報と引用を回答に利用できます。ただし、検索結果の解釈や要約が常に正しいとは限りません。
- Anthropic Claudeシリーズ:Anthropicは、根拠のない主張を避け、不確実性を明示するようモデルを訓練していると説明しています。ただし、結果はモデルやタスクによって異なり、他社モデルより常に正確とは限りません。
どのモデルを使う場合でも、重要な主張は一次情報で確認してください。文書要約のベンチマーク値を一般質問へ流用したり、モデル間の順位を固定的な信頼度として扱ったりするのは適切ではありません。
GPTシリーズ(OpenAI)の特性と注意点
GPT-5.6 Solは1.05Mトークンのコンテキストウィンドウを持ち、Web検索などのツールに対応しています。一方、公式仕様上の知識カットオフは2026年2月16日です。検索を利用しない回答や、カットオフ後の出来事を扱う回答では、最新の一次情報と照合する必要があります。(出典:GPT-5.6 Solモデル仕様)
Geminiシリーズ(Google)の傾向と対策
Gemini APIでは、対応モデルでGoogle検索によるGroundingを有効にすると、リアルタイムのWeb情報と引用を回答に利用できます。これは知識カットオフを補う手段になりますが、引用先の内容と回答の主張が一致しているかは利用者が確認する必要があります。(出典:Grounding with Google Search)
Claudeシリーズ(Anthropic)の信頼性
AnthropicはClaudeを、根拠のない主張を避け、不確実性を明示するよう訓練していると説明しています。Claude Opus 4.8は、必要なツールや参照情報が欠けた状況を対象とする評価で高いハルシネーション耐性を示しました。ただし、この結果をClaude全モデル・全タスクや他社比較へ一般化することはできません。(出典:Claude Opus 4.8 System Card)
AIの「嘘」は悪影響だけではない?創造性を引き出す活用法

これまでAIのハルシネーションをリスクとして解説してきましたが、その「事実に基づかない情報を生成する」という特性は、見方を変えれば創造的な活動の源泉にもなり得ます。常に正しい情報だけを求めるのではなく、発想を飛躍させるためのツールとして活用することで、ハルシネーションを味方につけることも可能です。
アイデア出しやブレインストーミングの起爆剤として
企画会議や新商品のアイデア出しに行き詰まった時、AIのハルシネーションは意図しない角度からの刺激を与えてくれます。例えば、「これまでにない斬新なマーケティング手法を10個提案して」といった指示を出すと、AIは現実の制約を無視した突飛なアイデアを生成することがあります。その中には非現実的なものも多いでしょうが、「もし〇〇が可能なら」という新しい視点や、既存の枠組みを打ち破るヒントが隠されているかもしれません。ハルシネーションを「間違い」ではなく「意外な組み合わせ」と捉えることで、人間の思考を活性化させる起爆剤として活用できます。
小説や脚本など創作活動のインスピレーション源に
小説のプロット、ゲームの世界観、詩や歌詞のフレーズなど、クリエイティブな執筆活動において、ハルシネーションは強力なインスピレーション源となります。AIに「架空の国の歴史を創作して」と依頼すれば、もっともらしい年表や文化、英雄譚を生成してくれるでしょう。これらは事実ではありませんが、物語の世界観を豊かにするための素材としては非常に価値があります。AIが生成した「嘘」をそのまま使うのではなく、そこから着想を得て自分自身の創造力で物語を膨ませていくことで、独創的な作品を生み出すきっかけになります。
AIの嘘とどう付き合うべきか?今後の展望と課題

AIのハルシネーション対策は進歩していますが、発生率はモデル、タスク、評価方法で変わり、完全な防止は困難です。そのため、私たちは「AIは嘘をつく可能性がある」という前提のもと、賢く付き合っていく方法を模索する必要があります。今後のビジネスシーンでは、AIを使いこなすための新たなスキルとリテラシーが不可欠となるでしょう。
完全な撲滅は困難?人間による監視と判断の重要性
AIの仕組みが確率的である以上、ハルシネーションのリスクをゼロにすることは難しいのが現状です。すべての処理に一律で人を介在させるのではなく、誤りが与える影響、出力の信頼性、時間的猶予などに応じて、確認・承認・停止の条件を設計することが重要です。
全社員に求められるAIリテラシー教育の必要性
AIの利用が全社へ広がるほど、社員がAIの特性とリスクを理解するための教育が重要になります。ハルシネーションの確認方法に加え、入力してよい情報、利用可能なツール、対外公表前の承認者などを社内ルールとして定めます。具体的な項目は生成AIの社内ルールの作り方で確認できます。
ハルシネーション検出技術の進化予測
今後は、ハルシネーションを自動で検出し、ユーザーに警告する技術の研究が一層進むと予測されます。AIの回答に信頼度スコアを付与したり、事実と異なる可能性が高い部分をハイライト表示したりする機能が、標準的に搭載されるようになるかもしれません。また、AI自身が回答を生成する過程で自己矛盾を検知し、自ら修正を行うような、より高度なモデルも登場するでしょう。人間によるファクトチェックを補助し、その負担を軽減する技術の進化が期待されます。
AI活用を実務に落とし込むならAXCAMP
AXCAMPは、法人向けのAI研修・伴走支援サービスです。14時間の研修では、AIの基礎、プロンプト、AIエージェント設計、バイブコーディングなどを扱い、その後は業務ヒアリングをもとにAI化計画の作成やAIエージェントの構築・改善を支援します。(出典:AXCAMPサービスページ)
導入企業からは、業務時間や外注費の削減などが報告されています。また、受講後アンケートでは、9割以上の企業が「満足」と回答しています。(出典:AXCAMP受講企業アンケート)
- 株式会社グラシズ様(リスティングを主軸とする広告代理店):LPライティング1本あたり約10万円の外注費を0円にし、制作時間も3営業日から2時間へ短縮しました。(出典:株式会社グラシズ様 導入事例)
- Route66株式会社様(SNS広告を軸に動画・記事制作を行う広告代理店):記事1本の原稿執筆に最大24時間、最短でも3時間かかっていた工程を、AIによる出力10秒まで短縮しました。(出典:Route66株式会社様 導入事例)
- C社様(SNSマーケティングを主軸とする広告代理事業):テキスト系SNS運用の稼働時間を1日3〜4時間から1時間へ短縮し、月間1,000万インプレッションを安定して獲得したと報告されています。(出典:C社様 導入事例)
- WISDOM合同会社様(SNS広告・ショート動画制作を手がける広告代理店):バックオフィス業務をAIで代替できる見通しが立ち、予定していたアポインターと経理担当者の2名の採用を見送りました。(出典:WISDOM合同会社様 導入事例)
AI活用を業務成果につなげるには、ツールの導入に加えて、対象業務の整理と社内で使い続けられる仕組みづくりが重要です。AXCAMPでは、AIコンサルタントが業務ヒアリングからAI化計画の作成、AIエージェントの構築・改善・定着まで伴走します。まずは無料相談で、貴社の課題をお聞かせください。

法人向けAI研修
AX CAMP 無料資料
AIが嘘をつく現象に関するよくある質問(FAQ)
1. AIが嘘をつく(ハルシネーションを起こす)のはなぜですか?
AIの「嘘」は意図的ではなく「ハルシネーション」と呼ばれます。 主な原因は3つあり、①学習データに誤りや偏り、古い情報が含まれている、②AIは事実を確認せず、確率的に最もそれらしい単語を繋げて回答を生成する仕組みである、③曖昧な質問に対してAIが文脈を補完しようと推測で答えてしまう、などです。
2. AIの嘘を見抜くための具体的な方法はありますか?
はい。①検証対象となる固有名詞、数値、日付を抜き出す、②官公庁、企業の公式発表、原著論文などの一次情報を探す、③AIが示したURLを実際に開き、該当箇所が主張を裏付けているか確認する、という順で進めます。複数モデルの回答一致だけで正しいとは判断しません。
3. AIが嘘をついた有名な事例はありますか?
はい。2023年のMata v. Aviancaでは、ChatGPTが生成した6件の架空判例を含む文書が提出され、弁護士2名と法律事務所に制裁金が科されました。なお、Air Canadaのチャットボット誤案内事件も自動応答のリスクとして知られますが、判断文は基盤技術を生成AI・LLMとは特定していないため、生成AIのハルシネーション事例とは区別する必要があります。
まとめ:AIが嘘をつく現象を理解し、賢く付き合う方法
本記事では、AIが嘘をつく「ハルシネーション」について、その原因からリスク、具体的な対策までを詳しく解説しました。AIはビジネスに革命をもたらす強力なツールですが、その出力には常に誤りが含まれる可能性があることを理解しておく必要があります。
この記事の要点をまとめます。
- ハルシネーションとは:AIが事実に基づかない情報を、もっともらしく生成する現象。AIに悪意はなく、技術的な限界に起因する。
- 主な原因:学習データの偏りや古さ、モデルの構造的限界、曖昧な指示などが複合的に絡み合って発生する。
- ビジネスリスク:誤った意思決定による経済的損失、企業の信用失墜、法務・コンプライアンス問題など、深刻な影響を及ぼす可能性がある。
- 実践的な対策:一次情報の確認、複数モデルによる相違点の把握、提示された出典の実査、用途のリスクに応じたレビュー工程を組み合わせる。
- 今後の付き合い方:完全な防止は困難なため、社員教育、社内ルール、検索・RAG、承認工程を用途に応じて設計する。
AIのハルシネーションは、決して無視できないリスクですが、その特性を正しく理解し、適切な対策を講じることで、安全にその恩恵を享受することは十分に可能です。重要なのは、AIを盲信するのではなく、あくまで「優秀なアシスタント」として位置づけ、人間が主導権を持って活用していく姿勢です。
自社だけで生成AIの活用や人材育成を進めることに不安がある場合は、専門家の支援も選択肢です。当社の法人向けAI研修・伴走支援「AXCAMP」では、AI活用の基礎からAIエージェント設計までを学び、業務ヒアリング、AI化計画の作成、実務への導入・定着まで支援しています。ご興味のある方は、お気軽に無料相談へお問い合わせください。
法人向けAI研修
AX CAMP 無料資料
